KI und Suche
llms.txt erklärt
Kurzantwort
Die llms.txt ist eine Textdatei im Markdown-Format unter der Adresse /llms.txt, die Sprachmodellen die wichtigsten Inhalte einer Website mit Links und Kurzbeschreibungen vorstellt. Vorgeschlagen hat sie Jeremy Howard am 03.09.2024; ein verabschiedeter Standard ist sie nicht1. Eine Auswertung von Ahrefs fand, dass 97 Prozent der Dateien im Mai 2026 keinen einzigen Abruf hatten2.
Eine llms.txt liegt wie die robots.txt im Hauptverzeichnis einer Website und ist mit jedem Texteditor lesbar. Sie enthält eine Überschrift mit dem Namen des Angebots, eine kurze Zusammenfassung und Listen mit Links auf die wichtigsten Seiten, jeweils mit einem Satz Erklärung. Gedacht ist sie für Sprachmodelle und KI-Agenten, die während einer Anfrage schnell verstehen sollen, was eine Website bietet und wo die passenden Informationen stehen. Die Idee ist einfach, die Beleglage für ihren Nutzen dagegen dünn.
Zur Einordnung vorweg: Wir sind bei diesem Thema nicht unbeteiligt. SEO NW, das Unternehmen hinter ki-blog.de, berät selbst zu KI-Suche und GEO. Was unten über den Nutzen steht, stützt sich deshalb nur auf veröffentlichte Daten.
Wer die Datei erfunden hat
Den Vorschlag hat Jeremy Howard am 03.09.2024 veröffentlicht, die Beschreibung liegt auf llmstxt.org und wurde zuletzt am 10.08.2026 überarbeitet1. Ziel ist laut Vorschlag, Agenten bei der Nutzung einer Website zu helfen. Der Hintergrund ist technisch: Das Kontextfenster eines Sprachmodells fasst nur eine begrenzte Menge Text, und HTML-Seiten mit Menüs, Werbung und Skripten enthalten viel Text, der zur Antwort nichts beiträgt. Eine kurze, ausgewählte Übersicht in Markdown passt besser hinein. Der Vorschlag rechnete damit, dass die Datei vor allem beim Beantworten von Anfragen genutzt wird und weniger fürs Training1.
Aufbau einer llms.txt
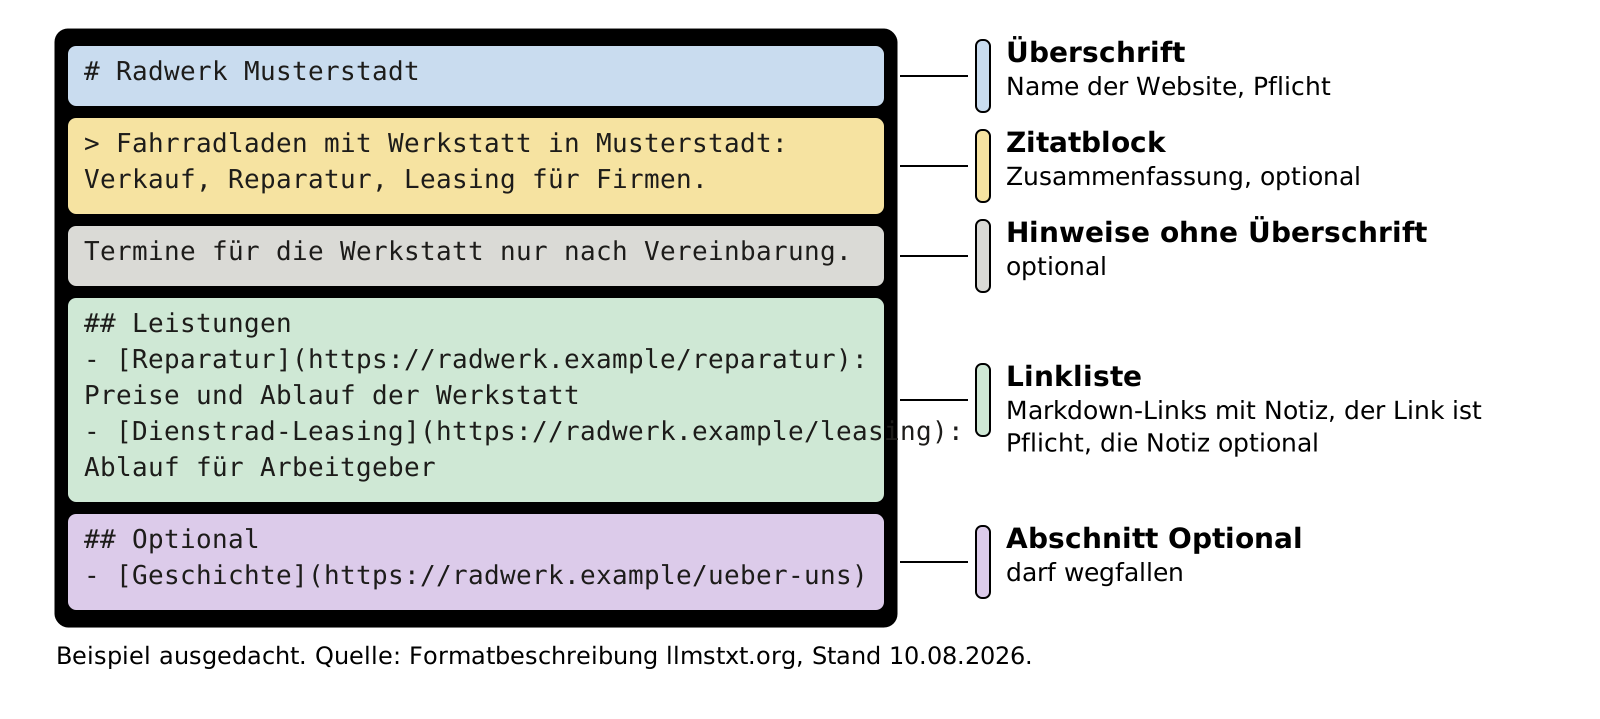
Das Format ist bewusst schlicht und folgt einer festen Reihenfolge1:
- Eine Überschrift erster Ordnung mit dem Namen des Projekts oder der Website. Sie ist der einzige Pflichtteil.
- Ein Zitatblock mit einer kurzen Zusammenfassung, eingeleitet mit dem Zeichen ">".
- Beliebig viele Absätze oder Listen ohne Überschrift mit weiteren Hinweisen.
- Abschnitte mit Überschriften zweiter Ordnung, die jeweils eine Liste von Links enthalten. Jeder Eintrag besteht aus einem Markdown-Link, also dem Namen in eckigen und der Adresse in runden Klammern, optional gefolgt von einem Doppelpunkt und einer Notiz.
- Ein Abschnitt "Optional" für Links, die ein Agent weglassen kann, wenn er mit wenig Text auskommen muss.
- Überschrift Name, Pflicht
- Zitatblock Zusammenfassung
- Linkliste Markdown-Links mit Notiz
- Optional darf wegfallen
Die Datei kann im Hauptverzeichnis liegen oder in einem Unterordner; dann gilt sie für die Seiten darunter1. Zusätzlich schlägt llmstxt.org vor, wichtige Seiten auch als reine Markdown-Fassung unter derselben Adresse mit der Endung .md anzubieten und mit einem Link-Element im Seitenkopf auf diese Fassung und auf die zuständige llms.txt zu verweisen1. Von einer Datei llms-full.txt mit allen Volltexten steht in der aktuellen Beschreibung nichts.
Ein Beispiel
Für einen ausgedachten Fahrradladen könnte eine Datei so aussehen:
| Inhalt | Bedeutung |
|---|---|
| # Radwerk Musterstadt | Name des Angebots, Pflichtteil |
| > Fahrradladen mit Werkstatt in Musterstadt: Verkauf, Reparatur, Leasing für Firmen. | Zusammenfassung als Zitatblock |
| Termine für die Werkstatt nur nach Vereinbarung. | weiterer Hinweis ohne Überschrift |
| ## Leistungen | Abschnitt mit Links |
| - [Reparatur](https://radwerk.example/reparatur): Preise und Ablauf der Werkstatt | Link mit Notiz |
| - [Dienstrad-Leasing](https://radwerk.example/leasing): Ablauf für Arbeitgeber | Link mit Notiz |
| ## Optional | Abschnitt, den ein Agent weglassen kann |
| - [Geschichte](https://radwerk.example/ueber-uns) | Link ohne Notiz |
Laut Vorschlag besteht jeder Listeneintrag aus einem Markdown-Link1. Eine nackte Adresse im Fließtext erkennt ein Programm, das die Datei nach dem Vorschlag auswertet, nicht als Eintrag einer Linkliste. Hilfreich ist außerdem, Angaben in die Notizen zu schreiben, die ohne Seitenabruf verständlich sind, etwa wofür eine Seite gut ist oder für wen sie gedacht ist.
llms.txt und robots.txt
Die robots.txt sagt Crawlern, welche Bereiche sie automatisch abrufen dürfen, etwa für einen Suchindex. Die llms.txt dagegen liefert Informationen, die ein Agent bei Bedarf abruft, wenn er zu einem Thema etwas wissen will1. Sie erlaubt und verbietet nichts. Wer KI-Crawler aussperren oder zulassen will, braucht weiter die robots.txt mit den Kennungen der einzelnen Crawler.
Auch die XML-Sitemap ersetzt die llms.txt nicht, schreibt llmstxt.org. Sie listet alle indexierbaren Seiten, enthält aber oft keine für Sprachmodelle lesbaren Fassungen, keine externen Adressen und meist zu viel Inhalt für ein Kontextfenster1. Auch strukturierte Daten im Seitenquelltext erfüllen einen anderen Zweck, denn sie beschreiben einzelne Seiten und keine ganze Website.
Wer die Datei liest
Ahrefs hat für 137.210 Domains, die im Mai 2026 Besucher hatten, alle Abrufe der Adresse /llms.txt ausgewertet2. 28 Prozent der Domains hatten eine solche Datei, wobei Ahrefs diesen Anteil selbst als Obergrenze bezeichnet, weil seine Kunden technisch versierter sind als der Durchschnitt. 97 Prozent dieser Dateien wurden im ganzen Monat kein einziges Mal abgerufen2.
Die Abrufe, die es gab, kamen zu 96 Prozent von Bots2. Benannte KI-Bots machten 19,5 Prozent aus, darunter waren Abrufe für die Antwortsuche mit 1,1 Prozent der kleinste Teil. Der fleißigste einzelne KI-Bot war GPTBot, der Trainings-Crawler von OpenAI. Größere Gruppen waren Prüfwerkzeuge für Suchmaschinenoptimierung, nicht zuordenbare Bots und allgemeine Crawler. Weitere 12 Prozent der Abrufe stammten von Werkzeugen, die das Format selbst untersuchen, darunter GEO- und AEO-Werkzeuge2. Auf Adressen ohne Datei griffen KI-Bots überhaupt nicht zu2. Das spricht dagegen, dass sie gezielt nach einer llms.txt suchen.
Google schreibt ausdrücklich, dass niemand neue maschinenlesbare Dateien oder KI-Textdateien braucht, um in den KI-Übersichten oder im KI-Modus zu erscheinen4. Von OpenAI, Anthropic oder Perplexity haben wir keine Dokumentation gefunden, die eine Auswertung der Datei zusagt. Ein Abruf ist zudem noch kein Beleg dafür, dass der Inhalt eine Antwort beeinflusst; Ahrefs betont selbst, dass ein Abruf nicht heißt, dass die Datei gelesen wurde2.
Eigene Serverprotokolle können wir noch nicht beisteuern. Das System, mit dem ki-blog.de gebaut wird, schreibt seine llms.txt bei jedem Bau neu; ausgewertet haben wir die Zugriffe darauf bisher nicht.
Erstellen und Generatoren
Eine kleine Website kommt mit einer handgeschriebenen Datei aus. Problematisch wird es, wenn sich Inhalte ändern und niemand die Datei nachzieht. Eine veraltete llms.txt verweist auf Seiten, die es nicht mehr gibt, und beschreibt Angebote falsch. Sicherer ist eine Datei, die das Redaktionssystem automatisch aus dem Bestand erzeugt.
Viele Systeme können das inzwischen. Die Beschreibung auf llmstxt.org nennt unter anderem Yoast SEO, All in One SEO und Wix sowie Dokumentationswerkzeuge wie Mintlify und GitBook, dazu Erweiterungen für Docusaurus, VitePress und Drupal1. Common Crawl hat im Juli 2026 genau 584.107 nicht leere llms.txt-Dateien ausgewertet und fand, dass rund zwei Drittel von einer Erweiterung erzeugt wurden; allein Wix stand hinter 41,34 Prozent3. Online-Generatoren, die eine Website abrufen und daraus eine Datei vorschlagen, gibt es ebenfalls. Ihr Ergebnis solltest du wie jeden Entwurf durchsehen.
Die Auswertung von Common Crawl zeigt typische Fehler. Nur 49,90 Prozent der Dateien hatten den vollständigen Aufbau aus Überschrift, Zitatblock und Linklisten3. Bei 40,36 Prozent der erfolgreichen Abrufe lieferte der Server HTML statt Text aus, meist weil eine Web-Anwendung jede unbekannte Adresse auf die Startseite umleitet. Bei weiteren 10,61 Prozent kam der Inhalt der robots.txt zurück3. Einige wenige Dateien enthielten sogar Anweisungen an Sprachmodelle, die als Prompt Injection gedacht sein könnten3. Prüf deine Datei deshalb im Browser und achte darauf, dass sie als reiner Text ausgeliefert wird.
Manche Betreiber schreiben Lizenzbedingungen, Abrufgrenzen oder Verbote für das Training in ihre llms.txt. Laut Common Crawl enthielten 6,59 Prozent der Dateien solche Begriffe, die der Vorschlag gar nicht vorsieht, darunter Abrufgrenzen in 3,05 Prozent und Urheberrechtshinweise in 0,93 Prozent der Dateien3. Verlassen kannst du dich darauf nicht, denn kein Anbieter hat zugesagt, solche Sätze zu beachten. Signale, die Crawler nach ihrer eigenen Dokumentation auswerten, gehören in die robots.txt.
Die Begleitdatei llms-full.txt mit allen Volltexten ist noch seltener im Einsatz. In derselben Auswertung lieferten 73,94 Prozent der Abrufe dieser Adresse den Fehler 404, und von den erfolgreichen Abrufen enthielten nur 7,01 Prozent tatsächlich Text3. Für die meisten Websites lohnt der zusätzliche Pflegeaufwand nicht.
Lohnt sich die Datei?
Der Aufwand ist gering, wenn dein System die Datei automatisch schreibt, und von Nachteilen einer korrekten Datei berichten die ausgewerteten Quellen nichts. Belegt ist ein Nutzen für die Sichtbarkeit in KI-Antworten bisher nicht. Für Websites mit technischer Dokumentation kann sie trotzdem praktisch sein. In der Auswertung von Ahrefs war das Programmierwerkzeug Claude Code nach GPTBot der zweithäufigste KI-Abrufer2, Entwickler lassen solche Dateien also offenbar von ihren Assistenten lesen. Wer die Einrichtung als eigene Leistung anbietet, SEO NW eingeschlossen, sollte erklären können, woran sich die Wirkung messen lässt. Für Nennungen in Sprachmodellen halfen in einem Laborversuch von 2023 Zitate, Statistiken und genannte Quellen im Text; die Studienlage fasst Was ist GEO? zusammen.
Was das für dich heißt
Eine llms.txt kostet wenig, wenn dein System sie selbst pflegt, und mehr solltest du dir von ihr nicht versprechen.
- Prüf in den Einstellungen deines Redaktionssystems oder SEO-Plugins, ob es eine llms.txt erzeugen kann.
- Ruf deine Datei im Browser auf und kontrolliere, ob Text erscheint und keine HTML-Seite.
- Schreib zu jedem Link eine kurze Notiz, die ohne Seitenabruf verständlich ist.
- Steck die Zeit, die du sparst, lieber in klare Absätze und belegte Angaben auf den Seiten selbst.
Häufige Fragen
Wie erstelle ich eine llms.txt?
Leg im Hauptverzeichnis eine Textdatei namens llms.txt an, beginne mit einer Überschrift mit dem Namen deiner Website und einer Zusammenfassung als Zitatblock und füge darunter Abschnitte mit Markdown-Links an. Bequemer ist eine Erweiterung deines Redaktionssystems, die die Datei bei jeder Änderung neu schreibt.
Ersetzt die llms.txt die robots.txt?
Nein. Die robots.txt regelt den Zugriff von Crawlern, die llms.txt beschreibt Inhalte und erlaubt oder verbietet nichts. Beide können nebeneinander bestehen.
Welcher llms.txt-Generator ist gut?
Am verlässlichsten ist der Generator, der in dein System eingebaut ist, weil er die Datei aktuell hält. Online-Generatoren liefern einen Entwurf, den du auf Aufbau, echte Markdown-Links und sinnvolle Notizen prüfen solltest.
Liest ChatGPT die llms.txt?
OpenAI hat dazu keine Zusage veröffentlicht. In der Auswertung von Ahrefs war der Trainings-Crawler GPTBot zwar der häufigste KI-Bot unter den Abrufen, ein Einfluss auf Antworten ist damit aber nicht belegt.
Quellen
Stand:
- Jeremy Howard: The /llms.txt file (llmstxt.org), Stand 10.08.2026, abgerufen am 22.11.2026. zurück
- Ahrefs (Louise Linehan, Xibeijia Guan): We Analyzed 137K Sites: 97% of llms.txt Files Never Get Read, Stand 15.06.2026, abgerufen am 22.11.2026. zurück
- Common Crawl (Malte Ostendorff): A content analysis of llms.txt files from the July 2026 crawl archive, Stand 31.08.2026, abgerufen am 22.11.2026. zurück
- Google: AI features and your website (Google Search Central), abgerufen am 22.11.2026. zurück