Lexikon · A
Attention
Kurzantwort
In neuronalen Netzen legt ein Rechenschritt namens Attention für jedes Wort fest, wie stark die übrigen Wörter der Eingabe in seine Verarbeitung einfließen2. Bei Self-Attention bezieht sich ein Text dabei auf sich selbst. Multi-Head-Attention führt mehrere solcher Gewichtungen nebeneinander aus2.
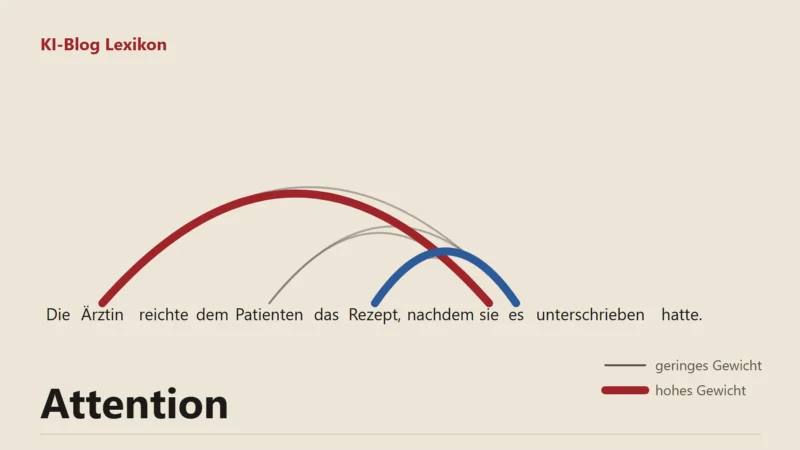
"Die Ärztin reichte dem Patienten das Rezept, nachdem sie es unterschrieben hatte." Beim Lesen ordnest du "sie" sofort der Ärztin zu und "es" dem Rezept. Ein Sprachmodell braucht für diese Zuordnung einen eigenen Rechenschritt. Er heißt Attention, auf Deutsch Aufmerksamkeit, und bestimmt für jedes Wort, welche anderen Wörter im Satz für seine Bedeutung zählen. Vereinfacht gesagt bekommt für "sie" die "Ärztin" ein hohes Gewicht und das "Rezept" ein niedriges.
Woher der Mechanismus kommt
Seinen Durchbruch hatte Attention in der maschinellen Übersetzung. Die damals üblichen Netze pressten einen ganzen Ausgangssatz in einen einzigen Zahlenvektor fester Länge, aus dem ein zweites Netz die Übersetzung erzeugte. Bahdanau, Cho und Bengio nannten diesen Vektor 2014 einen Engpass und ließen das Netz stattdessen bei jedem Zielwort im Ausgangssatz nach den passenden Stellen suchen1. Die gelernten Zuordnungen waren für Menschen gut nachvollziehbar1.
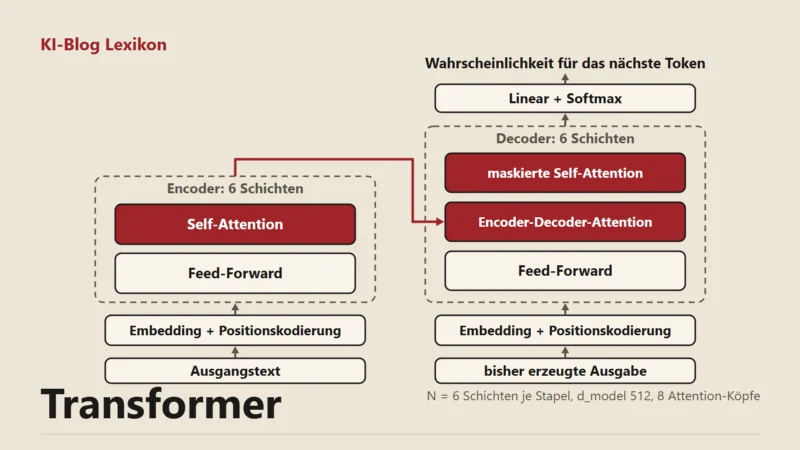
Drei Jahre später machte der Transformer Attention zum einzigen Mechanismus, der Wörter miteinander verbindet2.
Abfrage, Schlüssel und Wert
Technisch bekommt jedes Wort drei Vektoren, die das Modell im Training zu bilden lernt: eine Abfrage (Query), einen Schlüssel (Key) und einen Wert (Value)2. Die Abfrage eines Wortes wird mit den Schlüsseln aller Wörter verglichen, als Skalarprodukt. Je besser beide zusammenpassen, desto größer das Ergebnis. Eine Softmax-Funktion macht aus diesen Ergebnissen Gewichte, die zusammen eins ergeben. Mit ihnen werden die Werte aller Wörter gemischt, und diese Mischung ist die neue Darstellung des Wortes2.
Vor der Softmax teilt das Verfahren durch die Wurzel aus der Länge der Schlüsselvektoren. Ohne diese Skalierung würden die Produkte bei langen Vektoren so groß, dass die Softmax fast nur noch einen einzigen Treffer zulässt und das Training kaum noch vorankommt2.
Self-Attention
Stammen Abfragen, Schlüssel und Werte aus demselben Text, heißt das Self-Attention. Im Encoder eines Transformers darf jede Position auf alle Positionen schauen. Im Decoder, der Text erzeugt, ist die Sicht maskiert: Jedes Wort sieht nur sich selbst und die Wörter davor2. Genau deshalb kann ein Modell wie GPT Text der Reihe nach erzeugen, ein Wort nach dem anderen. Bei Übersetzungsmodellen gibt es zusätzlich Encoder-Decoder-Attention, bei der die Abfragen aus der entstehenden Übersetzung kommen und Schlüssel und Werte aus dem Ausgangstext2.
Mehrere Köpfe gleichzeitig
Eine einzelne Gewichtung kann nur eine Art von Beziehung abbilden. Multi-Head-Attention rechnet deshalb mehrere Gewichtungen parallel, jede in einem eigenen, kleineren Teilraum. Das Originalmodell von 2017 verwendete acht solche Köpfe mit je 64 Dimensionen bei einer Modellbreite von 5122. So kann ein Kopf etwa auf grammatische Bezüge achten, ein anderer auf inhaltlich verwandte Wörter. Die Autoren begründen den Aufbau damit, dass das Modell auf Informationen aus verschiedenen Darstellungsräumen gleichzeitig zugreifen kann2.
Was Attention kostet
Weil jedes Wort mit jedem anderen verglichen wird, wächst der Rechenaufwand einer Schicht mit dem Quadrat der Textlänge2. Doppelt so viel Text heißt grob viermal so viel Arbeit. Das ist ein Grund, warum das Kontextfenster eines Modells begrenzt ist. Beim Erzeugen langer Antworten hilft der KV-Cache: Er hebt Schlüssel und Werte der schon verarbeiteten Token auf, damit sie nicht für jedes neue Token neu berechnet werden müssen.
Häufige Fragen
Ist Attention dasselbe wie Verstehen?
Attention berechnet Gewichte zwischen Textstücken nach Mustern aus dem Training. Hohe Gewichte zeigen, welche Stellen in die Rechnung einfließen. Über Verständnis im menschlichen Sinn sagen sie wenig.
Kann man sehen, worauf ein Modell achtet?
Die Gewichte lassen sich auslesen und als Bögen oder Farbflächen über einem Satz darstellen. Solche Bilder sind anschaulich, erklären die Entscheidung eines großen Modells aber nur zum Teil, weil sehr viele Köpfe und Schichten zusammenwirken.
Quellen
Stand:
- arXiv (Bahdanau, Cho, Bengio): Neural Machine Translation by Jointly Learning to Align and Translate, Stand 01.09.2014, abgerufen am 22.11.2026. zurück
- arXiv (Vaswani u. a.): Attention Is All You Need, Stand 12.06.2017, abgerufen am 22.11.2026. zurück