Lexikon · A
Aktivierungsfunktion
Kurzantwort
Ohne Aktivierungsfunktion wäre ein neuronales Netz mit beliebig vielen Schichten am Ende nur eine lineare Funktion seiner Eingabe1. Die Funktion biegt die Summe, die jedes künstliche Neuron berechnet, und erst dadurch kann das Netz verwickelte Zusammenhänge abbilden. Als Standard in den inneren Schichten empfiehlt das Lehrbuch "Deep Learning" die ReLU1.
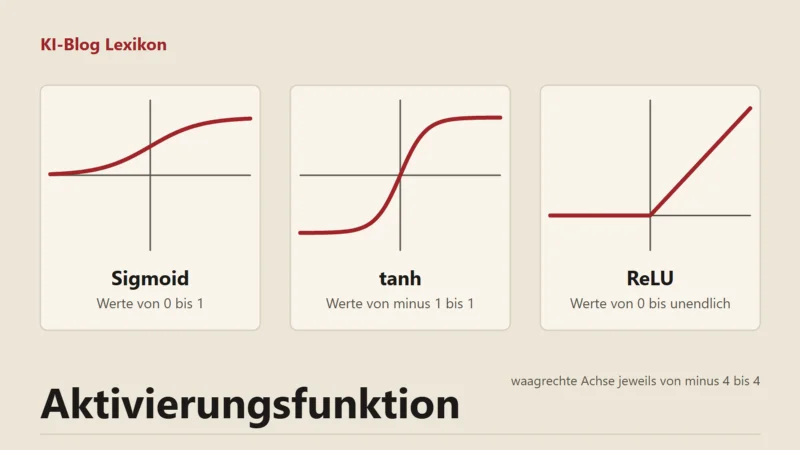
Ein künstliches Neuron in einem neuronalen Netz multipliziert seine Eingänge mit Gewichten und zählt alles zusammen. Bevor das Ergebnis an die nächste Schicht geht, schickt es den Wert durch eine Aktivierungsfunktion, eine kleine Formel mit Knick oder Kurve. Welche Formel das ist, beeinflusst, wie schnell und wie zuverlässig das Netz lernt.
Warum lineare Schichten allein nicht reichen
Im Lehrbuch "Deep Learning" wird das an einem kleinen Netz vorgerechnet: Wäre die erste Schicht linear, bliebe das ganze Netz eine lineare Funktion seiner Eingabe1. Zwei hintereinander geschaltete Multiplikationen mit Gewichten lassen sich zu einer einzigen zusammenfassen, und das gilt für zehn oder hundert Schichten genauso. Ein solches Netz könnte nur gerade Trennlinien ziehen. Erst die nichtlineare Funktion zwischen den Schichten macht aus dem Stapel mehr als eine einzelne Schicht1.
Sigmoid und tanh, die älteren Kurven
Vor der ReLU nutzten die meisten Netze die logistische Sigmoidfunktion, die jeden Wert in den Bereich zwischen 0 und 1 drückt, oder den Tangens hyperbolicus mit Werten zwischen minus 1 und 11. Beide Kurven werden an den Rändern flach. Nur in der Nähe von null reagieren sie deutlich auf ihre Eingabe, sonst sättigen sie, und der Gradient wird winzig. Das erschwert das Lernen mit Gradienten so sehr, dass das Lehrbuch von Sigmoid in verborgenen Schichten abrät1. In der Ausgabeschicht hat die Sigmoidfunktion weiter ihren Platz, wenn das Netz eine Wahrscheinlichkeit für ein Ja oder Nein ausgeben soll. Für mehrere Klassen übernimmt dort meist Softmax, die eine Wahrscheinlichkeitsverteilung über alle Klassen liefert1.
ReLU: ein Knick bei null
Die ReLU (rectified linear unit) gibt negative Werte als null aus und lässt positive unverändert durch1. Bei null ist sie streng genommen nicht ableitbar. Für das Training macht das in der Praxis kaum etwas aus, schreibt das Lehrbuch1. Wie viel die einfache Formel bringt, zeigten Alex Krizhevsky, Ilya Sutskever und Geoffrey Hinton 2012: Ein vierschichtiges Faltungsnetz mit ReLU erreichte auf dem Bilddatensatz CIFAR-10 eine Fehlerquote von 25 Prozent im Training sechsmal schneller als dasselbe Netz mit tanh2.
Die Schwäche der ReLU sind tote Einheiten. Rutscht die gewichtete Summe eines Neurons dauerhaft unter null, gibt es nur noch null aus, und beim Rückwärtsrechnen per Backpropagation kommt kein Gradient mehr an3. Google nennt eine kleinere Lernrate und Varianten wie LeakyReLU, die negativen Werten eine kleine Steigung lassen, als Gegenmittel3.
Was Sprachmodelle verwenden
Für große Sprachmodelle gibt es weichere Verwandte der ReLU. Dan Hendrycks und Kevin Gimpel stellten 2016 die GELU vor, die jede Eingabe mit dem Wert der Verteilungsfunktion der Normalverteilung an dieser Stelle gewichtet, statt sie hart nach dem Vorzeichen abzuschneiden4. Meta baute seine LLaMA-Modelle von 2023 auf der Architektur des Transformers auf und ersetzte darin die ReLU durch SwiGLU, eine Funktion, die Noam Shazeer 2020 eingeführt hatte. Als Grund nennt der Aufsatz bessere Leistung5.
Häufige Fragen
Welche Aktivierungsfunktion gehört in die Ausgabeschicht?
Das hängt von der Aufgabe ab. Für eine Ja-Nein-Wahrscheinlichkeit eignet sich die Sigmoidfunktion, für die Auswahl zwischen mehreren Klassen Softmax1.
Wie finde ich die passende Funktion für die inneren Schichten?
Vorhersagen lässt sich das selten. Das Lehrbuch beschreibt die Wahl als Ausprobieren: ein Netz mit der Funktion trainieren und auf einem Validierungsdatensatz vergleichen; die ReLU ist dabei meist ein brauchbarer Ausgangspunkt1.
Quellen
Stand:
- Goodfellow, Bengio, Courville: Deep Learning, Kapitel 6: Deep Feedforward Networks, Stand 2016, abgerufen am 22.11.2026. zurück
- NeurIPS Proceedings (Krizhevsky, Sutskever, Hinton): ImageNet Classification with Deep Convolutional Neural Networks, Stand 2012, abgerufen am 22.11.2026. zurück
- Google for Developers: Machine Learning Crash Course: Neural networks, Backpropagation, abgerufen am 22.11.2026. zurück
- arXiv (Hendrycks, Gimpel): Gaussian Error Linear Units (GELUs), Stand 06.06.2023, abgerufen am 22.11.2026. zurück
- arXiv (Touvron u. a., Meta): LLaMA: Open and Efficient Foundation Language Models, Stand 27.02.2023, abgerufen am 22.11.2026. zurück