Grundlagen
Wie Sprachmodelle antworten
Kurzantwort
ChatGPT ist ein großes Sprachmodell, das Text in Token zerlegt und immer wieder berechnet, welches Token als Nächstes am besten passt56. Diese Wahrscheinlichkeiten hat es im Vortraining an sehr viel Text gelernt, zum Assistenten wurde es erst durch Feinabstimmung mit menschlichem Feedback34. Weil aus den Wahrscheinlichkeiten gezogen wird, fällt dieselbe Frage nicht jedes Mal gleich aus7.
Wenn du ChatGPT eine Frage schickst, entsteht die Antwort Stück für Stück. Vor jedem Stück bewertet das Programm die möglichen Fortsetzungen, wählt eine aus, hängt sie an den bisherigen Text und beginnt von vorn5. Ein Nachschlagewerk mit fertigen Antworten kommt in diesem Ablauf nicht vor. Was wie Wissen wirkt, steckt in Milliarden von Zahlenwerten, die im Training eingestellt wurden25.
Der Weg einer Anfrage
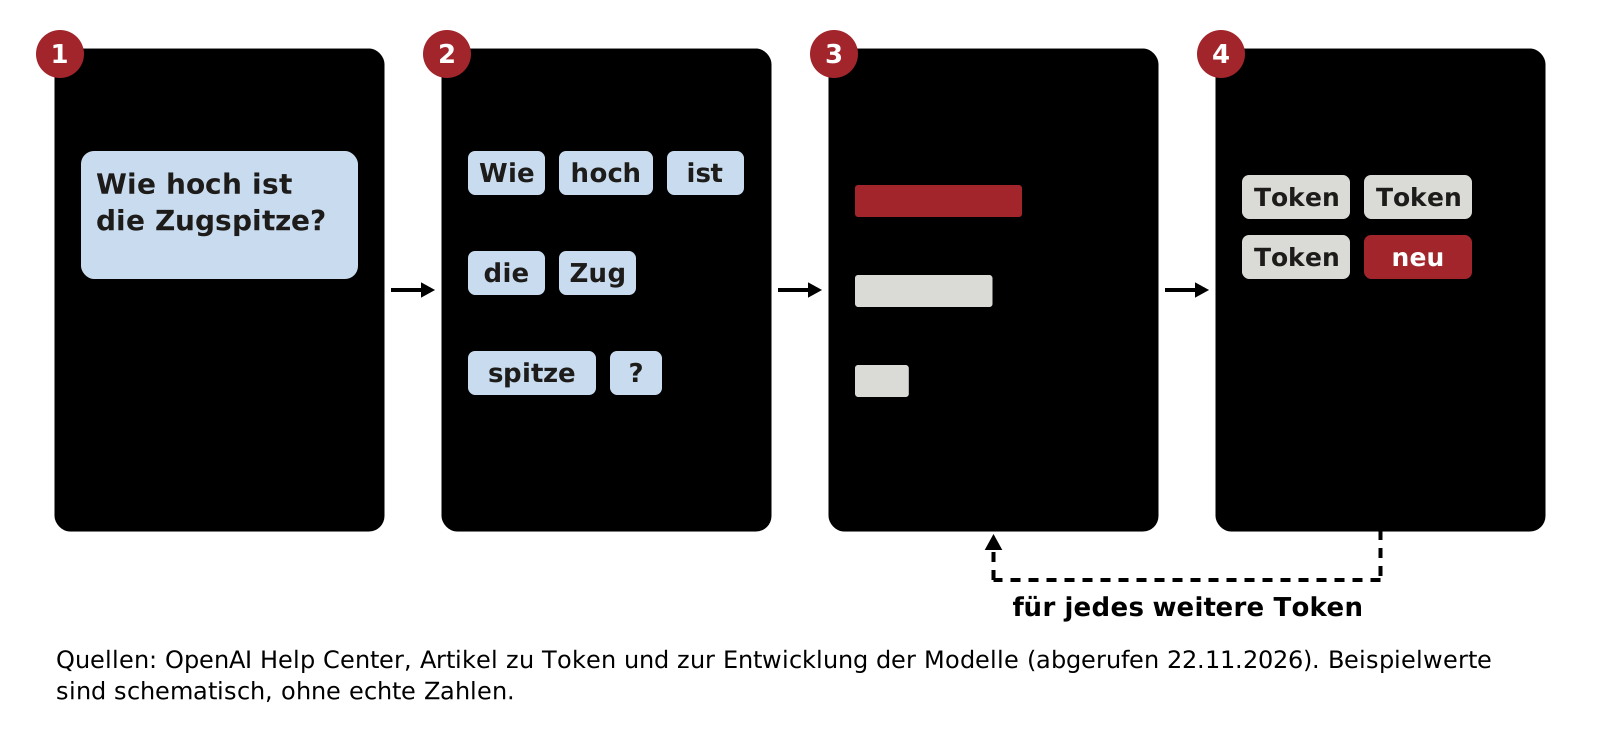
- Eingabe deine Frage als Text
- Token Zerlegung in Textstücke
- Vorhersage Wahrscheinlichkeit je Kandidat
- Ausgabe gewähltes Token wird angehängt
Den Ablauf kann man in vier Schritte teilen. Zuerst wird deine Eingabe in Textstücke zerlegt. Dann rechnet das Modell für jedes mögliche nächste Stück eine Wahrscheinlichkeit aus. Im dritten Schritt wird eines davon ausgewählt, im vierten angehängt und angezeigt. Die Schritte zwei bis vier laufen so lange im Kreis, bis die Antwort fertig ist. Das Programm, das diese Rechnung ausführt, ist ein großes Sprachmodell, in der Fachsprache ein LLM.
Jedes neue Stück hängt von allem ab, was davor steht: von deiner Frage, von früheren Nachrichten im selben Chat und von dem Teil der Antwort, der schon geschrieben ist. Wie viel Text das Modell dabei gleichzeitig berücksichtigt, legt sein Kontextfenster fest. Bei sehr langen Unterlagen gehen Einzelheiten verloren, besonders aus der Mitte, ein bekanntes Problem großer Kontextfenster.
Aus Text werden Token
Ein Sprachmodell arbeitet mit Token, also Textstücken, die ein Wort, ein Wortteil oder ein Satzzeichen sein können. OpenAI gibt als Faustregel für englische Texte an, dass ein Token ungefähr vier Zeichen entspricht und 100 Token etwa 75 Wörtern6. In anderen Sprachen ist das Verhältnis anders, Zahlen dafür nennt die Hilfeseite nicht6. Wie ein deutscher Satz zerfällt, kannst du mit unserem Token-Zähler ausprobieren.
Im Wortschatz des Modells hat jedes Token eine feste Nummer. Intern wird daraus eine lange Liste von Zahlen, mit der das Netz rechnen kann. Token sind außerdem die Einheit, in der Anbieter Nutzungsgrenzen und Preise für ihre Schnittstellen abrechnen. Wer an ein Nutzungslimit stößt oder eine Antwort abgeschnitten bekommt, hat es also mit Token zu tun.
Was im Vortraining passiert
Im ersten und aufwendigsten Abschnitt lernt das Modell an sehr großen Textmengen, das nächste Wort vorherzusagen5. Nach Angaben von OpenAI stammen die Daten aus frei zugänglichen Internetseiten, aus Datensätzen von Partnern und aus Beiträgen von Nutzern, Trainern und Forschenden. OpenAI sammelt nach eigener Angabe nicht absichtlich Daten von Seiten hinter Bezahlschranken oder aus dem Darknet, und Hassrede, Spam und Inhalte für Erwachsene werden herausgefiltert5. Bei jedem Trainingsschritt vergleicht das Verfahren die Vorhersage mit dem Wort, das wirklich im Text stand, und verschiebt die internen Zahlenwerte ein kleines Stück in die passende Richtung.
Diese Zahlenwerte heißen Parameter. GPT-3, ein Vorläufer der Modelle hinter ChatGPT, hatte laut der Veröffentlichung von 2020 rund 175 Milliarden davon2. Die Forschenden zeigten damals, dass ein so großes Modell neue Aufgaben schon mit wenigen Beispielen in der Eingabe lösen kann, ohne eigens dafür trainiert zu werden2.
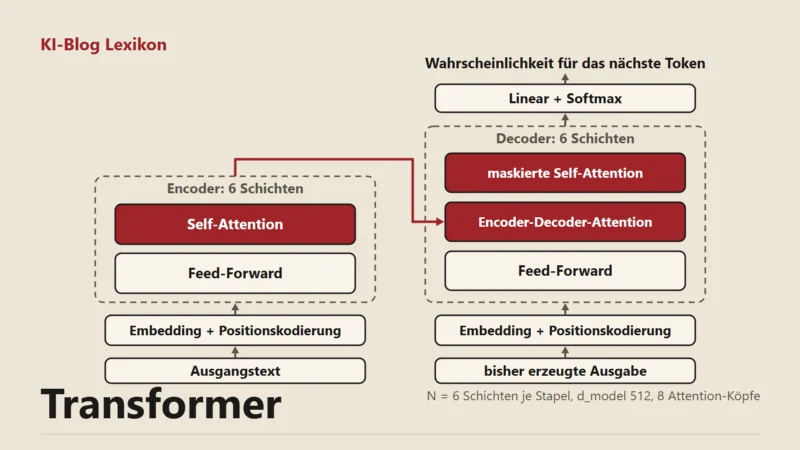
Die Bauweise heißt Transformer. Vorgestellt wurde sie 2017 in dem Aufsatz "Attention Is All You Need"1. Ältere Bausteine wie rekurrente Netze ließen die Autoren weg und setzten ganz auf einen Mechanismus namens Attention, der verrechnet, welche Teile des Textes für das gerade berechnete Stück wichtig sind1. Der praktische Gewinn: Das Training lässt sich gut auf viele Rechenkerne verteilen. Das Übersetzungsmodell aus dem Aufsatz war nach 3,5 Tagen auf acht Grafikkarten fertig trainiert1.
Wofür Attention gut ist, zeigt ein einfacher Satz: "Die Katze sprang nicht auf den Tisch, weil er zu hoch war." Wer "er" richtig fortsetzen will, muss wissen, dass der Tisch gemeint ist. Attention gewichtet dafür die Beziehungen zwischen allen Wörtern im Satz, und im Idealfall bekommt "Tisch" für "er" ein hohes Gewicht. Ein Modell mit vielen solchen Schichten erfasst auf diese Weise Bezüge über ganze Absätze hinweg.
Nach dem Vortraining beherrscht das Modell Grammatik und Stil und hat viele Zusammenhänge gesehen, die in Texten häufig vorkommen. OpenAI schreibt, dass seine Modelle keine Kopien der Trainingsdaten speichern und nicht aus ihnen abschreiben; das Training passe nur Zahlenwerte an5. Ein solches Basismodell kann nur Text fortsetzen. Auf "Wie wird das Wetter morgen?" könnte es eine Liste weiterer Wetterfragen schreiben, denn auch das wäre eine plausible Fortsetzung. Die InstructGPT-Studie hält fest, dass ein größeres Modell allein noch nicht besser tut, was die Nutzer eigentlich wollen3.
Vom Textvervollständiger zum Assistenten
Aus dem Basismodell wird erst durch Feinabstimmung ein Gesprächspartner, der auf Fragen antwortet. OpenAI hat das Verfahren im März 2022 am Beispiel von InstructGPT beschrieben3. Es hat drei Stufen:
- Menschen schreiben vorbildliche Antworten auf Beispielanfragen, und das Modell wird mit diesen Vorführungen weitertrainiert3.
- Dieselben Menschen bringen mehrere Antworten des Modells in eine Rangfolge. Aus diesen Rangfolgen lernt ein zweites Modell, welche Antworten Menschen vorziehen3.
- Mit diesem Bewertungsmodell als Maßstab wird das Sprachmodell durch bestärkendes Lernen weiter angepasst34.
Den ganzen Ablauf nennt man Reinforcement Learning from Human Feedback, kurz RLHF. Wie viel er ausmacht, zeigt ein Ergebnis der Studie: Die Bewertenden zogen die Antworten des kleinen InstructGPT mit 1,3 Milliarden Parametern denen des 175 Milliarden Parameter großen GPT-3 vor3. Nach demselben Muster entstand ChatGPT. OpenAI stellte es am 30.11.2022 vor; feinabgestimmt war es aus einem Modell der Reihe GPT-3.54.
Die Feinabstimmung bringt dem Modell bei, Anweisungen zu befolgen, im Gesprächston zu antworten und schädliche Bitten abzulehnen. Fehlerfrei macht sie es nicht. Die Autoren von InstructGPT schreiben selbst, dass ihr Modell weiterhin einfache Fehler macht3.
Warum dieselbe Frage verschiedene Antworten bekommt
Stell dieselbe Frage zweimal, und du bekommst zwei verschiedene Texte. Das liegt am dritten Schritt jeder Runde, der Auswahl. Für das nächste Token liefert das Modell eine Verteilung: "Hauptstadt" vielleicht mit hoher Wahrscheinlichkeit, "größte Stadt" mit etwas geringerer. Aus dieser Verteilung wird gezogen. OpenAI erklärt es so: Meist sind mehrere Fortsetzungen plausibel, also kann dieselbe Frage unterschiedliche Antworten hervorbringen5.
Wie breit gestreut wird, steuern Einstellungen wie die Temperature. In der Programmierschnittstelle von OpenAI reicht sie von 0 bis 2, voreingestellt ist 1. Höhere Werte wie 0,8 machen die Ausgabe zufälliger, niedrige wie 0,2 fokussierter7. Eine zweite Stellschraube ist top_p, das sogenannte Nucleus Sampling: Bei 0,1 kommen nur die Token in Frage, die zusammen die oberen zehn Prozent der Wahrscheinlichkeitsmasse ausmachen7.
Ganz ausschalten lässt sich die Streuung nicht verlässlich. Für die Einstellung seed verspricht OpenAI nur, sich um gleichbleibende Ergebnisse zu bemühen, und schreibt dazu, dass Determinismus nicht gewährleistet ist7.
Eine einzelne Antwort ist eine Stichprobe, und bei wichtigen Fragen lohnt ein zweiter Versuch oder eine andere Formulierung. Schon beim Start nannte OpenAI als bekannte Schwäche, dass kleine Umformulierungen die Antwort verändern4. Außerdem verrät ein sicherer Tonfall nichts darüber, wie wahrscheinlich die Aussage stimmt; das Modell formuliert eine geratene Angabe genauso flüssig wie eine gut belegte.
Was ein Sprachmodell nicht leistet
Zum Start schrieb OpenAI, ChatGPT gebe manchmal Antworten, die plausibel klingen und trotzdem falsch oder unsinnig sind4. Die Ursache liegt im Verfahren. Belohnt wird im Training die passende Fortsetzung, eine eingebaute Prüfung auf Wahrheit gibt es nicht. Wie oft Modelle Dinge erfinden, hängt stark von der Aufgabe ab, bei offenen Wissensfragen deutlich häufiger als beim Zusammenfassen eines mitgelieferten Textes.
Das gelernte Wissen endet außerdem mit dem Training. Spätere Ereignisse kennt das Modell nur, wenn es über eine Suchfunktion nachschlägt oder du die Information selbst in den Chat gibst. Viele Chatbots koppeln das Sprachmodell heute mit Websuche, Dateien oder Werkzeugen zum Rechnen. Die Antwort entsteht dann aus dem Modell und dem, was diese Werkzeuge zurückliefern; welche dieser Werkzeuge du bei ChatGPT bekommst, hängt vom Tarif ab.
Zwischen dir und dem Modell liegt zudem die Anwendung. Sie schickt mit jeder Anfrage Anweisungen des Anbieters mit, die du nicht siehst, etwa zum Tonfall, zu Sicherheitsregeln oder zum heutigen Datum. Auch deine gespeicherten Vorlieben und der bisherige Gesprächsverlauf landen dort. Darum antwortet dasselbe Modell in zwei Anwendungen unterschiedlich, und darum kann ein Chatbot plötzlich anders klingen, wenn der Anbieter diese Anweisungen ändert.
Bilder entstehen auf anderem Weg. Bildgeneratoren arbeiten meist mit Diffusion und entrauschen ein Bild Schritt für Schritt, gelenkt von deinem Text. Beide Arten von Modellen sind Spielarten des Deep Learning innerhalb des maschinellen Lernens.
Was das für dich heißt
Jede Antwort ist eine Stichprobe aus Wahrscheinlichkeiten, und danach richtest du dein Nachfragen und Prüfen aus.
- Stell wichtige Fragen zweimal oder anders formuliert und vergleich die Antworten.
- Gib Fakten, Zahlen und Texte, auf die es ankommt, selbst in den Chat.
- Prüf Angaben zu neueren Ereignissen nach, wenn die Antwort keine Quelle nennt.
- Lass dir bei Rechnungen den Rechenweg zeigen, statt dem Ergebnis im Fließtext zu trauen.
Häufige Fragen
Versteht ChatGPT, was es schreibt?
Es berechnet Wahrscheinlichkeiten für Textstücke auf Grundlage von Mustern aus dem Training. Ob man das Verstehen nennen will, ist eine Frage der Definition. Eine eingebaute Prüfung, ob eine Aussage stimmt, gibt es jedenfalls nicht.
Lernt ChatGPT aus meinen Chats?
Während eines Gesprächs verändert sich das Modell nicht. In den privaten Plänen Free, Plus und Pro nutzt OpenAI Unterhaltungen aber für das Training, solange du die Einstellung "Improve the model for everyone" nicht abschaltest8. Gibst du einer Antwort Daumen hoch oder runter, kann die ganze Unterhaltung trotzdem ins Training gehen8.
Was ist der Unterschied zwischen GPT und ChatGPT?
GPT ist der Name der Modellreihe von OpenAI. ChatGPT ist die Anwendung, die auf solchen Modellen läuft und für Gespräche feinabgestimmt wurde.
Warum rechnet ChatGPT manchmal falsch?
Auch Ziffern sagt ein Sprachmodell als Token voraus, ein Rechenwerk im eigentlichen Sinn hat es nicht. Bei Zahlen, auf die es ankommt, lass dir den Rechenweg zeigen und prüf ihn mit einem Taschenrechner nach.
Quellen
Stand:
- arXiv (Vaswani u. a.): Attention Is All You Need, Stand 12.06.2017, abgerufen am 22.11.2026. zurück
- arXiv (Brown u. a.): Language Models are Few-Shot Learners, Stand 28.05.2020, abgerufen am 22.11.2026. zurück
- arXiv (Ouyang u. a.): Training language models to follow instructions with human feedback, Stand 04.03.2022, abgerufen am 22.11.2026. zurück
- OpenAI: Introducing ChatGPT, Stand 30.11.2022, abgerufen am 22.11.2026. zurück
- OpenAI Help Center: How ChatGPT and our foundation models are developed, abgerufen am 22.11.2026. zurück
- OpenAI Help Center: What are tokens and how to count them?, abgerufen am 22.11.2026. zurück
- OpenAI: API Reference: Chat Completions (temperature, top_p, seed), abgerufen am 22.11.2026. zurück
- OpenAI Hilfe: Data controls in ChatGPT, abgerufen am 22.11.2026. zurück