Lexikon · D
Diffusionsmodell
Kurzantwort
Ein Diffusionsmodell beginnt mit reinem Zufallsrauschen und trägt es in vielen kleinen Schritten ab, bis ein Motiv übrig bleibt. Gelernt hat es das am umgekehrten Weg: Im Training werden echte Bilder nach und nach verrauscht, und das Modell übt, jeden dieser Schritte rückgängig zu machen2.
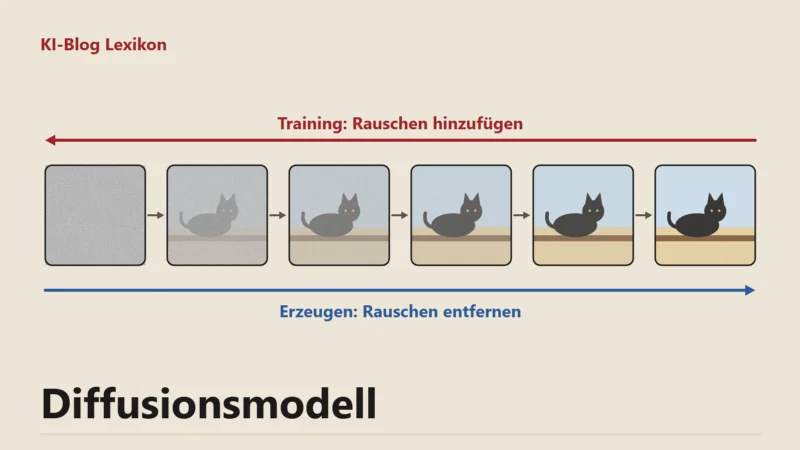
Ein alter Fernseher ohne Empfang zeigt graues Flimmern. Bei genau so einem Feld aus zufälligen Pixeln fängt ein Diffusionsmodell an und rechnet es so lange um, bis daraus zum Beispiel eine Katze auf einer Fensterbank geworden ist. In jedem Schritt schätzt das Modell, welcher Anteil des aktuellen Bildes noch Rauschen ist, und zieht ein Stück davon ab. Was am Ende zu sehen ist, hängt von den Bildern ab, die das Modell im Training gesehen hat, und bei Bildgeneratoren zusätzlich von der Beschreibung, die du eintippst.
Zwei Richtungen: verrauschen und entrauschen
Das Training läuft in der Gegenrichtung. Ein echtes Foto bekommt in vielen kleinen Schritten immer mehr Rauschen beigemischt, bis vom Motiv nichts mehr zu erkennen ist. Diesen Vorwärtsweg muss niemand lernen, er folgt einer festen Rechenvorschrift. Das neuronale Netz lernt nur den Rückweg: Es sieht ein verrauschtes Bild und soll vorhersagen, wie es einen Schritt früher aussah2. Wer das an sehr vielen Bildern geübt hat, kann auch bei reinem Rauschen anfangen und ein Bild herausarbeiten, das in dieser Form nirgends in den Trainingsdaten vorkam.
Zwei Eigenschaften, die du von jedem Bildgenerator kennst, folgen direkt daraus. Jeder zusätzliche Schritt kostet Rechenzeit, also ist die Schrittzahl ein Regler zwischen Tempo und Feinheit. Und weil der Anfang zufällig ist, liefert dieselbe Beschreibung bei jedem Durchlauf ein anderes Bild, solange du den Startwert nicht festhältst.
Von der Physik zum Bildgenerator
Der Name kommt aus der Physik, wo Diffusion das langsame Vermischen von Teilchen beschreibt. Jascha Sohl-Dickstein und seine Mitautoren stellten 2015 ein Lernverfahren vor, das sich an der Thermodynamik von Nichtgleichgewichtsprozessen orientiert: Ein Vorwärtsprozess zerstört die Struktur der Daten allmählich, ein gelernter Rückwärtsprozess baut sie wieder auf1.
2020 zeigten Jonathan Ho, Ajay Jain und Pieter Abbeel, dass solche Modelle Bilder in brauchbarer Qualität erzeugen. Auf dem Bilddatensatz LSUN mit 256 mal 256 Pixeln lagen ihre Ergebnisse etwa gleichauf mit ProgressiveGAN, einem damals verbreiteten Verfahren aus der Familie der GAN2.
Teuer blieb die Sache, solange das Modell direkt auf den Pixeln rechnete. Eine Gruppe um Robin Rombach verlegte den Vorgang 2021 in einen verdichteten Zwischenraum, den ein vorgeschalteter Autoencoder liefert, und kamen so mit deutlich weniger Rechenleistung aus3. Zusätzliche Attention-Schichten erlauben es, das Modell mit Text oder anderen Vorgaben zu steuern3. Aus dieser Forschung ging Stable Diffusion hervor, das die Gruppe als latentes Diffusionsmodell für Text-zu-Bild veröffentlicht hat4.
Wo Diffusionsmodelle heute arbeiten
Viele bekannte Systeme für Text-to-Image setzen auf Diffusion. Googles Forschungsmodell Imagen etwa verbindet ein großes Sprachmodell als Textverständnis mit einem Diffusionsmodell, das die Pixel erzeugt5. Auch das Ausbessern von Fotos klappt mit dem Verfahren gut: Die latenten Diffusionsmodelle aus dieser Arbeit erreichten beim Inpainting, also dem Neufüllen markierter Bildbereiche, Bestwerte3.
Zwischen dem eingetippten Satz und dem fertigen Bild liegen noch weitere Stationen, darunter der Textencoder, der die Beschreibung in Zahlen übersetzt, und der Decoder, der aus dem Zwischenraum wieder sichtbare Pixel macht. Sie gehören zum Bildgenerator als Ganzem, und das Diffusionsmodell erzeugt darin die eigentlichen Bildinhalte.
Häufige Fragen
Worin unterscheidet sich ein Diffusionsmodell von einem GAN?
Ein GAN erzeugt ein Bild in einem einzigen Durchgang und lernt im Wettstreit zweier Netze: Eines erzeugt Bilder, das andere versucht, sie von echten zu unterscheiden6. Ein Diffusionsmodell nähert sich dem Ergebnis dagegen in vielen kleinen Entrauschungsschritten.
Wie viele Schritte braucht ein Bild?
Das legt jedes Modell anders fest. Verdichtete Schnellfassungen kommen mit sehr wenigen aus, Stability AI nennt für Stable Diffusion 3.5 Large Turbo vier Schritte7.
Warum sieht das Ergebnis bei gleicher Beschreibung jedes Mal anders aus?
Jeder Durchlauf beginnt mit neuem Zufallsrauschen. Hältst du den Startwert (englisch Seed) fest und änderst sonst nichts, bekommst du wieder dasselbe Bild.
Quellen
Stand:
- Sohl-Dickstein, Weiss, Maheswaranathan, Ganguli (arXiv): Deep Unsupervised Learning using Nonequilibrium Thermodynamics, Stand 18.11.2015, abgerufen am 22.11.2026. zurück
- Ho, Jain, Abbeel (arXiv): Denoising Diffusion Probabilistic Models, Stand 16.12.2020, abgerufen am 22.11.2026. zurück
- Rombach, Blattmann, Lorenz, Esser, Ommer (arXiv): High-Resolution Image Synthesis with Latent Diffusion Models, Stand 13.04.2022, abgerufen am 22.11.2026. zurück
- CompVis (GitHub): Stable Diffusion: Projektbeschreibung, abgerufen am 22.11.2026. zurück
- Saharia und andere (arXiv): Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding, Stand 23.05.2022, abgerufen am 22.11.2026. zurück
- Goodfellow und andere (arXiv): Generative Adversarial Networks, Stand 10.06.2014, abgerufen am 22.11.2026. zurück
- Stability AI: Introducing Stable Diffusion 3.5, abgerufen am 22.11.2026. zurück