Grundlagen
Wie Bildgeneratoren arbeiten
Kurzantwort
Die meisten KI-Bildgeneratoren sind Diffusionsmodelle: Sie haben gelernt, Rauschen aus Bildern zu entfernen, und bauen ein neues Bild aus zufälligem Rauschen in vielen kleinen Schritten auf12. Dein Text wird dabei von einem Sprachteil in Zahlen übersetzt und lenkt jeden dieser Schritte23. Gelernt haben die Modelle an Milliarden von Bild-Text-Paaren aus dem Internet5.
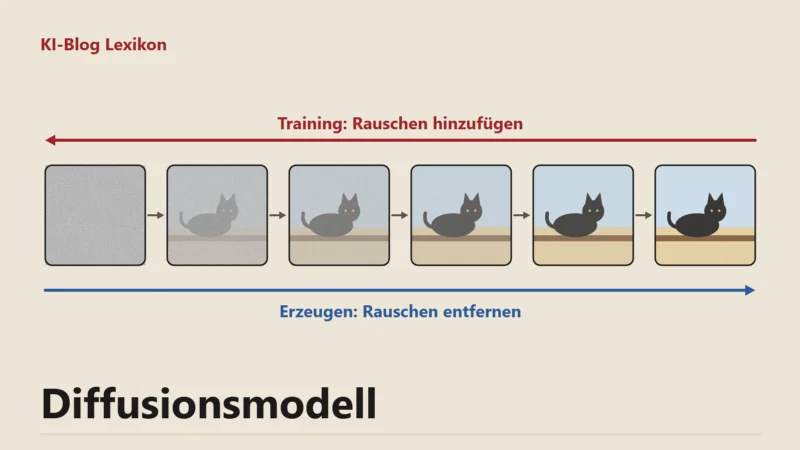
Ein Bildgenerator startet mit einer Fläche aus zufälligem Rauschen, ähnlich dem Schnee eines alten Fernsehers, und rechnet daraus in vielen Durchgängen nach und nach Formen, Farben und Einzelheiten heraus1. Was am Ende zu sehen ist, bestimmt dein Text: Er wird in Zahlen übersetzt und beeinflusst jeden Durchgang2. Das Verfahren heißt Diffusion.
Vom Rauschen zum Bild
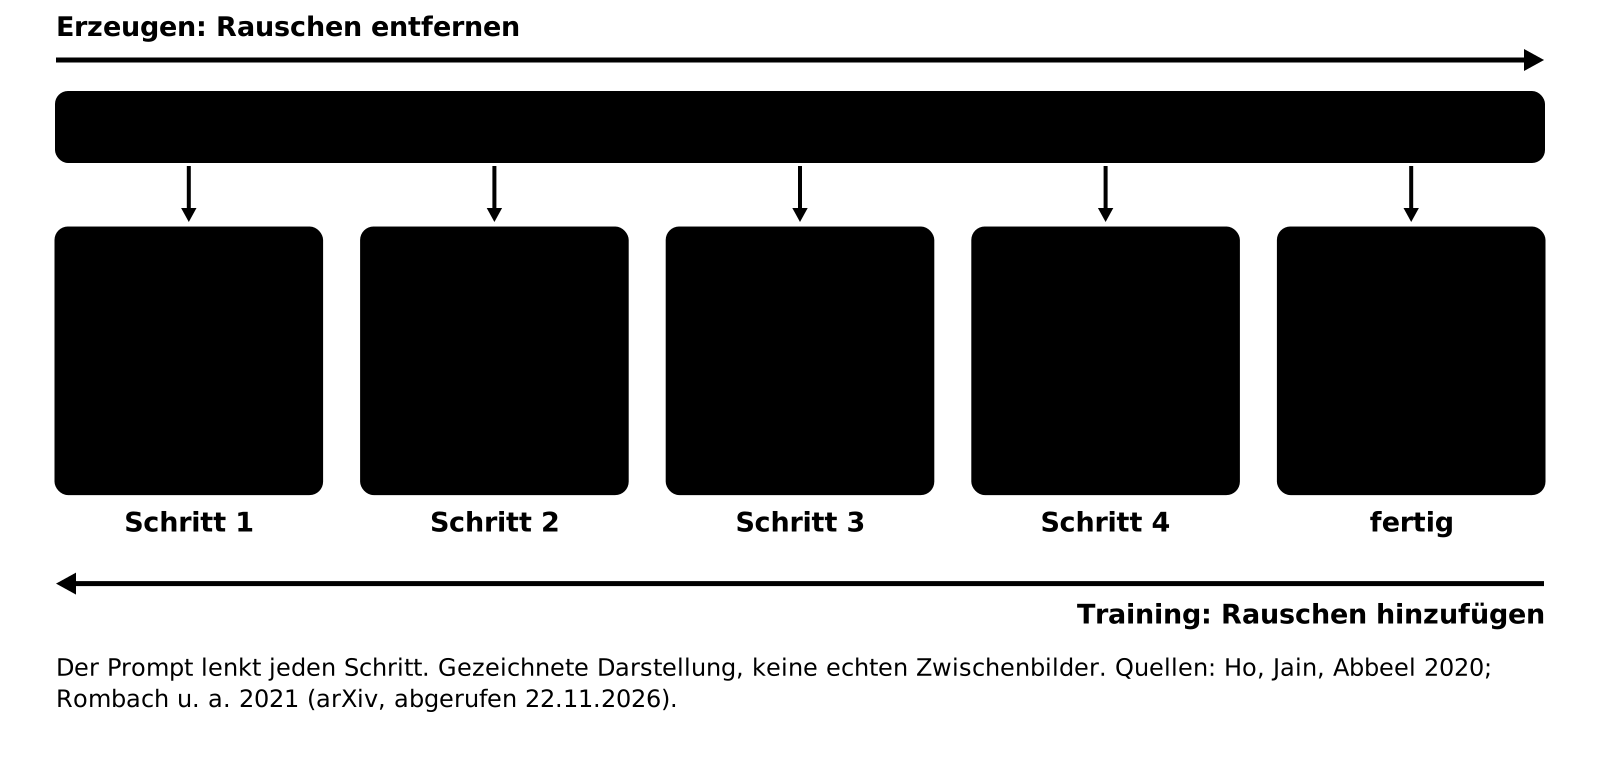
- Rauschen zufälliger Startpunkt
- Entrauschen in vielen kleinen Schritten
- Prompt lenkt jeden Schritt über Cross-Attention
Die Grundlage haben Jonathan Ho, Ajay Jain und Pieter Abbeel im Juni 2020 unter dem Titel "Denoising Diffusion Probabilistic Models" beschrieben1. Das Training läuft rückwärts. Man nimmt echte Fotos und mischt ihnen in vielen kleinen Schritten immer mehr Rauschen bei, bis vom Motiv nichts mehr übrig ist. Ein neuronales Netz lernt dabei die Gegenrichtung: Es soll bei jedem Zwischenstand schätzen, welcher Anteil des Bildes Rauschen ist, damit man ihn abziehen kann.
Hat das Netz das gelernt, braucht es zum Erzeugen kein Foto mehr. Es bekommt reines Zufallsrauschen und zieht Schritt für Schritt ab, was es für Rauschen hält. Aus dem Grau werden zuerst grobe Flächen, dann Umrisse, zuletzt feine Strukturen wie Haare oder Holzmaserung. Weil das Startrauschen bei jedem Durchlauf anders ist, entsteht aus demselben Text jedes Mal ein anderes Bild. Viele Programme zeigen die Zahl, mit der das Rauschen erzeugt wurde, als "Seed" an; mit demselben Seed und denselben Einstellungen lässt sich ein Bild wiederholen.
Die Autoren der Arbeit von 2020 meldeten für den Datensatz CIFAR-10 einen FID-Wert von 3,17 und nannten ihn einen Spitzenwert1. Auf größeren Bildern mit 256 mal 256 Punkten erreichte ihr Verfahren eine ähnliche Qualität wie ProgressiveGAN, ein damals verbreitetes Verfahren aus einer anderen Familie von Bildmodellen1. Der Begriff Diffusionsmodell steht seitdem für eine ganze Familie von Bildgeneratoren.
Warum die Rechnung in einem verkleinerten Raum läuft
Ein Foto mit vielen Millionen Bildpunkten Schritt für Schritt zu entrauschen kostet viel Rechenzeit. Die Lösung beschrieb ein Team um Robin Rombach im Dezember 2021: Der Generator arbeitet in einem komprimierten Zwischenraum, den ein vorher trainierter Autoencoder liefert2. Ein Teil dieses Autoencoders verdichtet Bilder auf eine viel kleinere Darstellung, die nur das Wesentliche enthält. Die Diffusion läuft in diesem kleinen Raum, und erst ganz am Schluss übersetzt der zweite Teil das Ergebnis zurück in ein Bild mit voller Auflösung.
Die Autoren schreiben, dass ihr Verfahren deutlich weniger Rechenleistung braucht als Diffusion direkt auf den Bildpunkten2. Auf dieser Arbeit baut Stable Diffusion nach Angabe der Entwickler auf9, und sie erklärt, warum solche Modelle heute auch auf einer Grafikkarte im eigenen Rechner laufen. Bei lokal erzeugten Bildern bleiben die Prompts auf dem eigenen Rechner.
Dieselbe Arbeit führte Cross-Attention-Schichten ein, über die sich die Entstehung des Bildes an Eingaben wie Text oder Begrenzungsrahmen koppeln lässt2. Außerdem zeigten die Autoren, dass sich das Verfahren für mehr eignet als für neue Bilder. Beim Ausbessern von Bildbereichen erreichten sie einen neuen Bestwert, beim Hochrechnen kleiner Bilder auf höhere Auflösung waren sie konkurrenzfähig2.
Auf demselben Prinzip beruht die Funktion "Bild zu Bild", die viele Programme anbieten. Dort beginnt die Rechnung mit deinem Foto, dem ein Teil Rauschen beigemischt wurde. Je mehr Rauschen, desto freier darf der Generator das Bild umdeuten; bei wenig Rauschen bleiben Aufbau und Farben weitgehend erhalten und nur Stil oder Einzelheiten ändern sich. So lassen sich auch vorhandene Fotos mit KI bearbeiten und erweitern.
Wie der Text das Bild lenkt
Damit ein Satz wie "Ein Leuchtturm bei Sonnenuntergang, Ölgemälde" das Rauschen in die richtige Richtung schiebt, muss der Generator Bild und Sprache zusammenbringen. Dafür sorgt ein Textteil, der den Prompt in eine Folge von Zahlen übersetzt. Ein bekanntes Vorbild ist CLIP, das ein Team um Alec Radford im Februar 2021 vorgestellt hat. CLIP lernte an rund 400 Millionen Bild-Text-Paaren aus dem Internet, welche Bildunterschrift zu welchem Bild gehört3. Dadurch liegen ein Bild und eine passende Beschreibung im Inneren des Modells nah beieinander.
Bei jedem Entrauschungsschritt schaut das Bildnetz über die Cross-Attention auf diese Textdarstellung2. Steht im Prompt "Leuchtturm", werden Bildbereiche bevorzugt, die zu einem Leuchtturm werden können. So wird aus Text ein Bild, im Fachjargon Text-to-Image.
Wie stark der Text das Ergebnis bestimmt, regelt ein Verfahren mit dem sperrigen Namen Classifier-Free Guidance. Jonathan Ho und Tim Salimans haben es im Juli 2022 beschrieben4. Das Modell lernt gleichzeitig, mit und ohne Text zu entrauschen. Beim Erzeugen werden beide Schätzungen gemischt, und je stärker die Mischung zur Textseite gewichtet ist, desto genauer folgt das Bild dem Prompt4. Der Preis: Die Vielfalt sinkt4. In vielen Programmen heißt dieser Regler "Guidance" oder "CFG".
Für Prompts gilt deshalb eine Faustregel. Der Generator kennt Begriffe und Stile so gut, wie sie in den Trainingsdaten mit Bildern verknüpft waren. Häufige Motive klappen zuverlässig, seltene Kombinationen schwanken stärker, und gute Prompts für KI-Bilder nennen Motiv, Stil und Licht ausdrücklich.
Woher die Trainingsbilder stammen
Bildgeneratoren lernen an sehr großen Sammlungen von Bildern mit Beschreibung. Ein offener Datensatz, an dem viele Forschungsmodelle trainiert wurden, ist LAION-5B. Er umfasst laut seiner Veröffentlichung vom Oktober 2022 rund 5,85 Milliarden Bild-Text-Paare, die mit CLIP gefiltert wurden; 2,32 Milliarden davon haben englischen Text5. Die kommerziellen Anbieter legen ihre Trainingsdaten meist nicht im Einzelnen offen.
Ein Generator bildet die Schwerpunkte des Internets ab, aus dem seine Trainingsbilder stammen: Was dort oft und gut beschriftet zu sehen ist, kann er besser. Bittest du um "eine Person in einem Büro", wählt er Alter, Kleidung und Umgebung nach dem, was in solchen Bildern häufig vorkam. Wer etwas anderes sehen will, muss es ausdrücklich in den Prompt schreiben. Außerdem stammen viele Bilder von Menschen, die nie gefragt wurden. Daraus ergeben sich Fragen zum Urheberrecht bei KI-Bildern: ob das Training erlaubt war und wem ein erzeugtes Bild gehört.
Hände und Schrift als Schwachstellen
Zwei Fehler sind so bekannt, dass sie lange als Erkennungszeichen für KI-Bilder galten: verdrehte Hände und unleserliche Schrift. Beide haben eine technische Erklärung.
Für Hände nennt die Forschung die Trainingsbilder selbst als Ursache. Die Autoren der Arbeit HandRefiner vom November 2023 schreiben, dass Diffusionsmodelle Hände oft mit falscher Fingerzahl oder unregelmäßiger Form erzeugen7. Hände seien in Fotos häufig verformt oder verdeckt, darum falle es den Modellen schwer, ihren Aufbau und ihre Haltung zu lernen7. Ihr Gegenmittel ist eine Nachbearbeitung: Ein zweites Modell rekonstruiert eine plausible Hand, und nur dieser Bereich wird neu erzeugt7. Solches gezieltes Neuzeichnen einzelner Bildteile heißt Inpainting.
Bei Schrift liegt das Problem im Textteil. Eine Arbeit vom Dezember 2022 zeigt, dass gängige Generatoren Textkodierer nutzen, die einzelne Buchstaben gar nicht sehen; sie verarbeiten Wortstücke6. Wer nicht weiß, aus welchen Buchstaben ein Wort besteht, kann es kaum richtig hinschreiben. Modelle mit buchstabengenauem Textteil lagen bei seltenen Wörtern im Test um mehr als 30 Prozentpunkte vorn6.
Neuere Modelle haben hier aufgeholt. Eine Arbeit vom März 2024, an der auch Robin Rombach beteiligt war, beschreibt einen Transformer mit getrennten Gewichten für Bild- und Text-Token, der laut den Autoren Text besser versteht und Schrift besser setzt8. Beim Erkennen von KI-Bildern reichen Fehler bei Händen und Schrift deshalb als Merkmal nicht mehr aus.
Was sich seit den ersten Diffusionsmodellen geändert hat
Dieselbe Arbeit vom März 2024 steht für zwei Entwicklungen der letzten Jahre8. Statt des klassischen Entrauschens in vielen kleinen Schritten nutzt sie Rectified Flow, ein Verfahren, das Daten und Rauschen auf einer geraden Linie verbindet. Und an die Stelle des bisherigen Bildnetzes tritt ein Transformer, also die Bauweise, die auch hinter Sprachmodellen wie ChatGPT steckt8.
Am Prinzip ändert das wenig. Auch die neuen Modelle beginnen mit Rauschen und führen es unter Anleitung des Textes zu einem Bild. Die bekannten KI-Bildgeneratoren unterscheiden sich vor allem in Preis, Bildstil und darin, wie gut sie deutsche Prompts verstehen. Für dein erstes eigenes Bild reicht oft ein Gratisangebot, mit dem du KI-Bilder kostenlos erstellen kannst.
Was das für dich heißt
Wer weiß, wie das Rauschen zum Bild wird, versteht besser, warum Prompts, Seed und Guidance so viel ausmachen.
- Notier dir den Seed eines gelungenen Bildes, wenn du später kleine Änderungen ausprobieren willst.
- Beschreib Motiv, Stil und Licht konkret, denn häufige Begriffe kennt der Generator am besten.
- Prüf Hände, Schrift und kleine Details, bevor du ein Bild veröffentlichst.
- Nutz Inpainting für einzelne Fehler, statt das ganze Bild neu zu erzeugen.
Häufige Fragen
Setzt ein Bildgenerator Bilder aus Teilen echter Fotos zusammen?
Nein. Er hat aus vielen Bildern gelernt, wie Rauschen von Motiven zu trennen ist, und erzeugt neue Bildpunkte. Ähnlichkeiten mit einzelnen Trainingsbildern sind trotzdem möglich, vor allem bei sehr bekannten Motiven.
Warum kommt bei demselben Prompt jedes Mal ein anderes Bild heraus?
Jedes Bild beginnt mit neuem Zufallsrauschen. Wenn dein Programm den Seed anzeigt und du ihn mit denselben Einstellungen wiederverwendest, bekommst du dasselbe Bild noch einmal.
Wie lässt sich Diffusion einfach erklären?
Im Training wird Bildern schrittweise Rauschen beigemischt, und das Modell lernt, diesen Vorgang umzukehren. Beim Erzeugen entfernt es Rauschen aus einer zufälligen Fläche, bis ein Bild übrig bleibt.
Versteht ein Bildgenerator deutsche Prompts?
Das hängt vom Textteil des Modells ab. Viele Trainingsdaten sind englisch beschriftet, daher folgen manche Generatoren englischen Prompts genauer; probier im Zweifel beide Sprachen aus.
Quellen
Stand:
- arXiv (Ho, Jain, Abbeel): Denoising Diffusion Probabilistic Models, Stand 19.06.2020, abgerufen am 22.11.2026. zurück
- arXiv (Rombach u. a.): High-Resolution Image Synthesis with Latent Diffusion Models, Stand 20.12.2021, abgerufen am 22.11.2026. zurück
- arXiv (Radford u. a.): Learning Transferable Visual Models From Natural Language Supervision, Stand 26.02.2021, abgerufen am 22.11.2026. zurück
- arXiv (Ho, Salimans): Classifier-Free Diffusion Guidance, Stand 26.07.2022, abgerufen am 22.11.2026. zurück
- arXiv (LAION): LAION-5B: An open large-scale dataset for training next generation image-text models, Stand 16.10.2022, abgerufen am 22.11.2026. zurück
- arXiv (Liu u. a.): Character-Aware Models Improve Visual Text Rendering, Stand 20.12.2022, abgerufen am 22.11.2026. zurück
- arXiv (Lu u. a.): HandRefiner: Refining Malformed Hands in Generated Images by Diffusion-based Conditional Inpainting, Stand 29.11.2023, abgerufen am 22.11.2026. zurück
- arXiv (Esser u. a.): Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, Stand 05.03.2024, abgerufen am 22.11.2026. zurück
- CompVis (LMU München): Repository CompVis/stable-diffusion auf GitHub, abgerufen am 22.11.2026. zurück