Lexikon · T
Text-to-Image
Kurzantwort
Du tippst "Leuchtturm im Nebel, als Aquarell" und erhältst ein passendes Bild: Dieses Prinzip heißt Text-to-Image. Ein Sprachteil übersetzt die Beschreibung in Zahlen, ein Bildteil erzeugt daraus Pixel, bei den meisten heutigen Systemen mit einem Diffusionsmodell.
Auf Deutsch spricht man auch von Text-zu-Bild. Gemeint ist jedes Verfahren, das aus einer Beschreibung in natürlicher Sprache ein neues Bild erzeugt, ohne dass du zeichnest oder ein Foto hochlädst. Bekannte Vertreter sind Stable Diffusion, Midjourney und die Bildmodelle, die OpenAI über seine Schnittstelle für Bilderzeugung und Bildbearbeitung anbietet6. Wer ein vorhandenes Foto verändern will, landet bei verwandten Verfahren wie Bild-zu-Bild oder Inpainting.
Ein Sprachteil und ein Bildteil
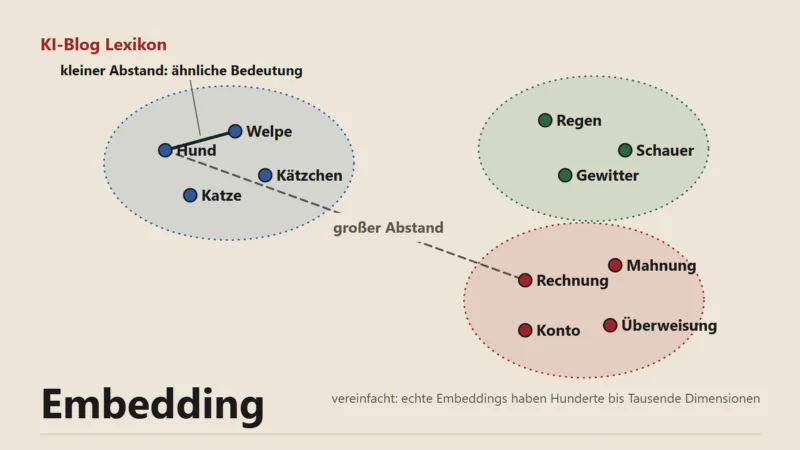
Damit ein Rechner "Leuchtturm" mit dem Aussehen eines Leuchtturms verbinden kann, braucht er eine Brücke zwischen Wörtern und Bildern. Eine wichtige Grundlage dafür lieferte OpenAI 2021 mit CLIP: Das Modell lernte an 400 Millionen Bild-Text-Paaren aus dem Internet, welche Bildunterschrift zu welchem Bild gehört1. Ein solcher Textencoder macht aus deiner Beschreibung einen Zahlenvektor, ein Embedding, das den Bildteil durch die Erzeugung lenkt.
Wie viel vom Textverständnis abhängt, zeigte Google 2022 mit Imagen. Das Team nahm ein großes Sprachmodell, das nur mit Text trainiert war, als Encoder. Ein größeres Sprachmodell verbesserte Bildqualität und Treue zur Beschreibung stärker als ein größeres Bildmodell3. Für dich heißt das: Ein Generator mit gutem Sprachverständnis setzt Mengenangaben, Farben und Positionen eher so um, wie du sie geschrieben hast.
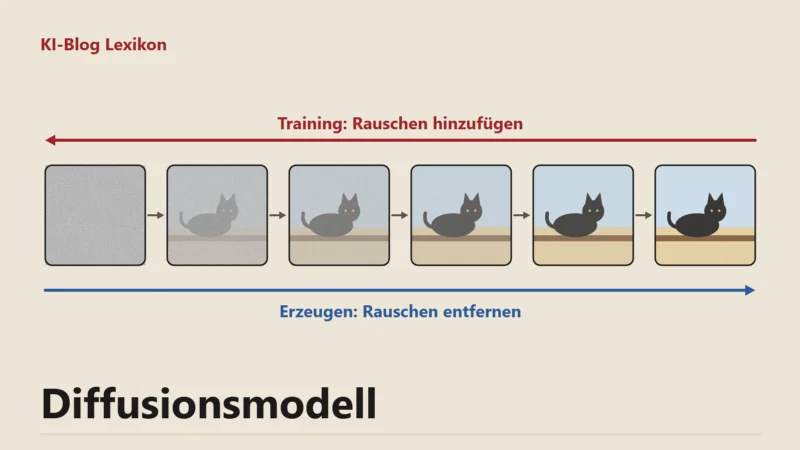
Der Bildteil ist heute oft ein Diffusionsmodell. Es beginnt mit Rauschen und entfernt es Schritt für Schritt, wobei der Textvektor in jedem Schritt mitbestimmt, in welche Richtung das Bild sich entwickelt. Latente Diffusionsmodelle erledigen das in einem verdichteten Zwischenraum und werden über Attention-Schichten an den Text gekoppelt4.
Von DALL-E zu den Diffusionsmodellen
Ein früher bekannter Ansatz war DALL-E. OpenAI stellte 2021 ein Transformer-Modell vor, das Text und Bild als eine einzige Folge von Bausteinen behandelt und das Bild Stück für Stück anhängt2. Danach kamen Diffusionsmodelle wie Imagen und die latenten Diffusionsmodelle, auf denen Stable Diffusion beruht34. Imagen erreichte auf dem Bilddatensatz COCO einen FID-Wert von 7,27, ohne mit COCO trainiert worden zu sein; je niedriger dieser Wert, desto ähnlicher sind die erzeugten Bilder echten Fotos3.
Was du über die Beschreibung steuerst
Den größten Einfluss hat dein Prompt. Offene Modelle bieten weitere Regler. Die Bibliothek Diffusers etwa beschreibt einen Wert namens Guidance Scale, der festlegt, wie streng das Bild der Beschreibung folgt, und einen Negativ-Prompt für Dinge, die nicht auftauchen sollen5. Mit einem festen Startwert (englisch Seed) lässt sich ein Ergebnis wiederholen. Bei geschlossenen Diensten wie Midjourney oder den Bildfunktionen in Chat-Programmen sind viele dieser Regler verborgen, dort steuerst du fast alles über die Wortwahl.
Ob ein Modell Schrift im Bild, Hände oder genaue Anzahlen trifft, prüfst du am besten mit ein paar eigenen Testbildern, bevor du dich festlegst. Manches lässt sich mit genaueren Bild-Prompts ausgleichen, bei anderem hilft nur der Wechsel zu einem anderen der KI-Bildgeneratoren.
Häufige Fragen
Ist Text-to-Image dasselbe wie ein KI-Bildgenerator?
Fast. Text-to-Image beschreibt die Aufgabe, aus Text ein Bild zu machen. Ein Bildgenerator ist das Programm oder der Dienst, der das anbietet und oft noch weitere Funktionen hat, etwa das Bearbeiten hochgeladener Fotos.
Quellen
Stand:
- Radford und andere (arXiv): Learning Transferable Visual Models From Natural Language Supervision, Stand 26.02.2021, abgerufen am 22.11.2026. zurück
- Ramesh und andere (arXiv): Zero-Shot Text-to-Image Generation, Stand 26.02.2021, abgerufen am 22.11.2026. zurück
- Saharia und andere (arXiv): Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding, Stand 23.05.2022, abgerufen am 22.11.2026. zurück
- Rombach, Blattmann, Lorenz, Esser, Ommer (arXiv): High-Resolution Image Synthesis with Latent Diffusion Models, Stand 13.04.2022, abgerufen am 22.11.2026. zurück
- Hugging Face: Diffusers: Inpainting (Abschnitte Guidance Scale, Negative Prompt), abgerufen am 22.11.2026. zurück
- OpenAI: Image generation (API-Dokumentation), abgerufen am 22.11.2026. zurück