Lexikon · T
Textklassifikation
Kurzantwort
Textklassifikation ordnet einen ganzen Text automatisch einer oder mehreren festen Kategorien zu, etwa "Spam" oder "erwünscht", "Rechnung" oder "Reklamation". Das Verfahren lernt die Zuordnung meist aus Beispielen, die Menschen vorher einsortiert haben5.
Posteingang, Werbeordner oder Spam? Diese Frage beantwortet ein Klassifikator bei jeder Mail, bevor du sie zu sehen bekommst. Dieselbe Technik verteilt in Firmen Kundenanfragen an die richtige Abteilung, erkennt die Sprache eines Dokuments oder sortiert Nachrichten nach Ressort. Sie gehört zu den ältesten Anwendungen der Sprachverarbeitung, und die Sentimentanalyse, die nur die Stimmung eines Textes bestimmt, ist ein Sonderfall von ihr.
Der Spamfilter als Lehrbeispiel
Bekannt gemacht hat das Verfahren ein Aufsatz des Programmierers Paul Graham vom August 2002. Er sammelte rund 4.000 Spam-Mails und ebenso viele erwünschte Nachrichten, berechnete für jedes Wort, wie oft es in der einen oder anderen Sammlung vorkam, und verrechnete bei jeder neuen Mail die 15 auffälligsten Wörter nach dem Satz von Bayes1. Bei seiner eigenen Post rutschten danach weniger als 5 von 1.000 Spam-Mails durch, und keine erwünschte Nachricht landete fälschlich im Spam1.
Heute arbeiten die großen Anbieter mit viel größeren Modellen. Google schrieb im Dezember 2024, Gmail halte mehr als 99,9 Prozent von Spam, Phishing und Schadsoftware fern, und ein neues, eigens trainiertes Sprachmodell blockiere 20 Prozent mehr Spam als zuvor2.
Wie ein Klassifikator rechnet
Ein Programm kann mit Wörtern nicht rechnen, also wird der Text zuerst in Zahlen übersetzt. Die einfachste Form ist der Bag of Words: Jedes Dokument wird zu einer Zeile, jedes Wort zu einer Spalte, und in den Zellen steht, wie oft das Wort vorkommt. Dabei geht die Reihenfolge der Wörter verloren, und weil jeder Text nur einen kleinen Teil des Wortschatzes nutzt, sind laut scikit-learn-Dokumentation oft mehr als 99 Prozent der Zellen leer3. Die Gewichtung tf-idf sorgt dafür, dass Allerweltswörter wie "und" weniger zählen als seltene, aussagekräftige3.
Auf diesen Zahlen lernt ein Verfahren wie die logistische Regression, welche Wörter für welche Klasse sprechen; Jurafsky und Martin führen logistische Regression und Textklassifikation in ihrem Lehrbuch gemeinsam ein5. Dafür braucht es überwachtes Lernen mit beschrifteten Beispielen. Neuere Ansätze ersetzen die Wortzählung durch Vektoren aus neuronalen Netzen oder fragen ein Sprachmodell direkt, ganz ohne Training (Zero-Shot-Learning). Cloud-Dienste haben eigene Grenzen: Die Inhaltsklassifizierung von Google Cloud verlangt mindestens 20 Wörter je Text4.
Wie Einteilungen scheitern
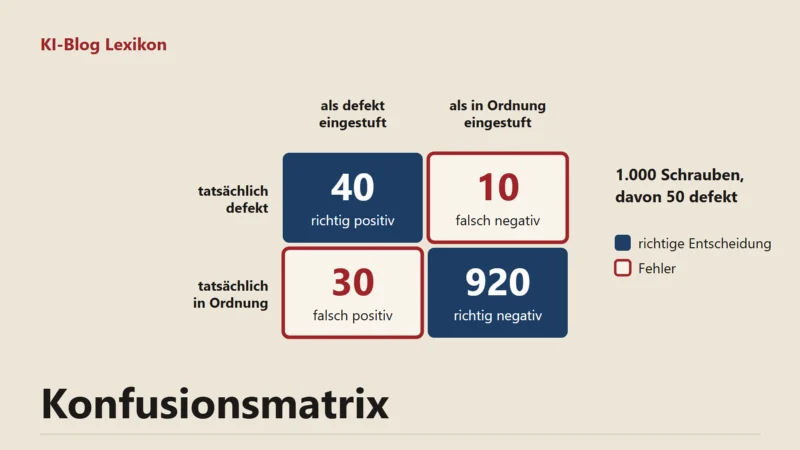
Wenn die Trefferquote nicht steigt, lohnt ein Blick auf die Kategorien, bevor du das Verfahren wechselst. Zwei Klassen, die auch Fachleute im Team nicht sauber auseinanderhalten, trennt ein Modell ebenfalls schlecht. Hilfreich ist eine Restklasse "unklar", die solche Fälle an einen Menschen weitergibt, gerade wenn ein Betrieb Anfragen im Rahmen der Automatisierung von Abläufen verteilen lässt. Wo genau die Verwechslungen liegen, zeigt eine Konfusionsmatrix, die für jede Klasse aufschlüsselt, wohin ihre Texte tatsächlich sortiert wurden.
Häufige Fragen
Wie viele Beispiele braucht ein Klassifikator?
Das hängt von der Zahl der Klassen und davon ab, wie deutlich sie sich unterscheiden. Klar getrennte Kategorien kommen mit weniger Beispielen aus als ähnliche. Mit einem großen Sprachmodell lässt sich ein erster Versuch auch ganz ohne Beispiele starten.
Kann ein Text mehreren Klassen angehören?
Ja, das heißt Mehrfachklassifikation. Eine Mail kann zugleich "Rechnung" und "dringend" sein. Das Verfahren entscheidet dann für jede Klasse einzeln, ob sie zutrifft.
Warum landen erwünschte Mails trotzdem im Spam?
Jeder Filter wägt ab zwischen durchgelassenem Spam und fälschlich aussortierter Post, und auf beiden Seiten bleiben Fehler. Ein gelegentlicher Blick in den Spamordner lohnt sich deshalb, gerade wenn du auf eine wichtige Antwort wartest.
Quellen
Stand:
- Paul Graham: A Plan for Spam, Stand 08/2002, abgerufen am 22.11.2026. zurück
- Google (The Keyword): Email scams surge over the holiday: here's how Gmail keeps you safe, Stand 18.12.2024, abgerufen am 22.11.2026. zurück
- scikit-learn: Feature extraction, Text feature extraction (Version 1.9.1), abgerufen am 22.11.2026. zurück
- Google Cloud: Natural Language API Basics, abgerufen am 22.11.2026. zurück
- Stanford University (Jurafsky, Martin): Speech and Language Processing, 3rd edition draft, Stand 19.08.2026, abgerufen am 22.11.2026. zurück