Lexikon · K
Konfusionsmatrix
Kurzantwort
In einer Konfusionsmatrix steht, wie oft ein Klassifikator jede Klasse richtig erkannt und mit welcher anderen er sie verwechselt hat. Bei zwei Klassen sind das vier Felder: richtig positiv, falsch positiv, falsch negativ und richtig negativ1.
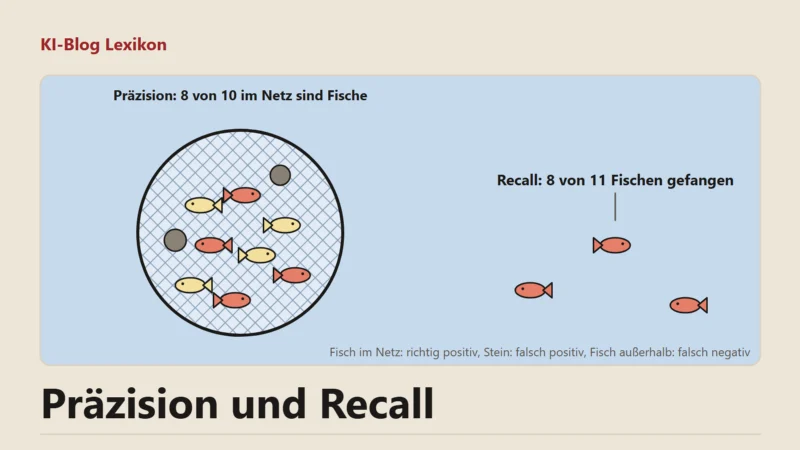
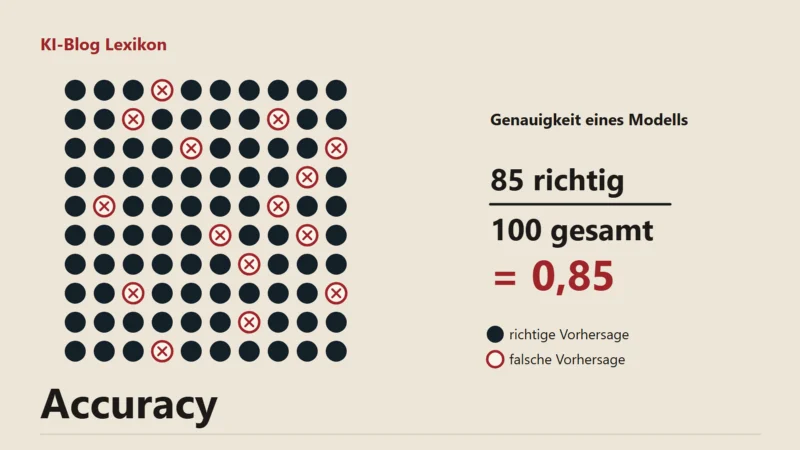
Die Tabelle zeigt auf einen Blick, wo ein Klassifikator Klassen durcheinanderbringt. Auf Englisch heißt sie Confusion Matrix, im Deutschen liest man gelegentlich auch Wahrheitsmatrix. Aus ihren Feldern lassen sich die üblichen Kennzahlen eines Klassifikators ausrechnen, von der Accuracy bis zu Präzision und Recall12.
Die vier Felder
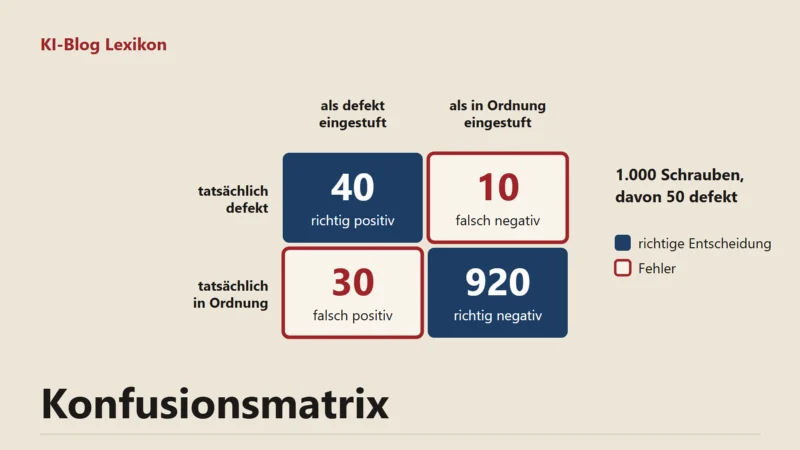
Stell dir eine Qualitätskontrolle vor, die Schrauben als "defekt" (positiv) oder "in Ordnung" (negativ) einstuft. Jede geprüfte Schraube landet in genau einem von vier Feldern:
- Richtig positiv: defekt und als defekt erkannt.
- Falsch positiv: in Ordnung, trotzdem aussortiert, also ein Fehlalarm.
- Falsch negativ: defekt, aber durchgelassen.
- Richtig negativ: in Ordnung und durchgelassen.
Google führt dieselben vier Felder in seinem Lernkurs an einem Spamfilter vor1. Die Summe einer Zeile oder Spalte hat jeweils eine eigene Bedeutung: Einmal ergeben sich alle tatsächlich positiven Fälle, einmal alle Fälle, die das Modell als positiv gemeldet hat1.
Lesebeispiel aus der Schraubenprüfung
| Wahrheit | als defekt eingestuft | als in Ordnung eingestuft |
|---|---|---|
| tatsächlich defekt | 40 (richtig positiv) | 10 (falsch negativ) |
| tatsächlich in Ordnung | 30 (falsch positiv) | 920 (richtig negativ) |
Für dieses Rechenbeispiel sind von 1.000 Schrauben 50 tatsächlich defekt. Das Modell erkennt 40 davon, 10 rutschen durch. Von den 950 guten Schrauben sortiert es 30 aus. Daraus ergibt sich eine Accuracy von 960 von 1.000, also 0,96, und ein Recall von 40 von 50, also 0,8. Die Präzision beträgt dagegen nur 40 von 70, rund 0,57: Von sieben aussortierten Schrauben sind drei gut, obwohl die Accuracy so hoch liegt.
Zeilen und Spalten: erst die Beschriftung lesen
Ob die Wahrheit in den Zeilen oder in den Spalten steht, ist nicht einheitlich geregelt. In scikit-learn stehen die tatsächlichen Klassen in den Zeilen und die Vorhersagen in den Spalten, so wie in der Tabelle oben2. Googles Kurs zeichnet die Tafel umgekehrt, mit der Wahrheit in den Spalten1. Die Dokumentation von scikit-learn weist selbst darauf hin, dass andere Quellen die Achsen anders anordnen2. Bei einer fremden Matrix prüfst du deshalb zuerst, was an den Rändern steht.
Wenn ein Modell drei oder mehr Klassen kennt
Bei mehreren Klassen wächst die Tafel auf so viele Zeilen und Spalten, wie es Klassen gibt2. Auf der Diagonale stehen die richtigen Zuordnungen, jedes Feld daneben zählt eine bestimmte Verwechslung. Ein Modell für Bilderkennung, das Hunde, Katzen und Füchse unterscheiden soll, kann insgesamt gut abschneiden und trotzdem Füchse regelmäßig für Hunde halten. In der Matrix fällt das als volles Feld abseits der Diagonale sofort auf, in der Accuracy geht es unter.
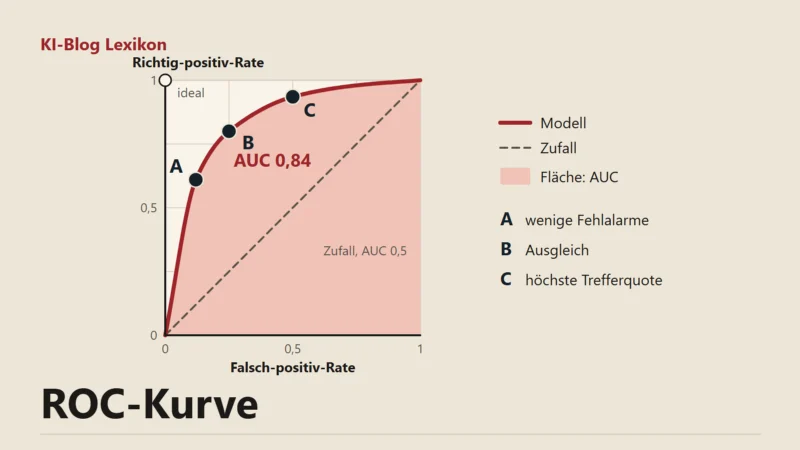
Die Zahlen einer Matrix gelten immer für eine bestimmte Schwelle. Wird sie verschoben, wandern Fälle zwischen den Feldern: Eine höhere Schwelle verringert die richtig und die falsch positiven Fälle zugleich1. Das Verhalten über alle Schwellen hinweg zeichnet die ROC-Kurve nach.
Häufige Fragen
Warum heißt sie Konfusionsmatrix?
Weil sie zeigt, welche Klassen ein Modell verwechselt, auf Englisch "confuses".
Welche Kennzahlen lassen sich aus ihr berechnen?
Wie entsteht eine Konfusionsmatrix in Python?
In scikit-learn übergibst du der Funktion confusion_matrix die wahren und die vorhergesagten Klassen. Bei zwei Klassen liefert das abgeflachte Ergebnis die Felder in der Reihenfolge richtig negativ, falsch positiv, falsch negativ, richtig positiv2.
Quellen
Stand:
- Google for Developers: Machine Learning Crash Course: Thresholds and the confusion matrix, abgerufen am 22.11.2026. zurück
- scikit-learn: Metrics and scoring: quantifying the quality of predictions (Version 1.9.1), abgerufen am 22.11.2026. zurück