Lexikon · W
Word2Vec
Kurzantwort
Word2Vec ordnet jedem Wort eine feste Liste von Zahlen zu, einen Vektor, und zwar so, dass Wörter mit ähnlicher Verwendung nah beieinanderliegen1. Ein Team um Tomas Mikolov stellte das Verfahren im Januar 2013 vor; es lernte gute Vektoren aus 1,6 Milliarden Wörtern in weniger als einem Tag1.
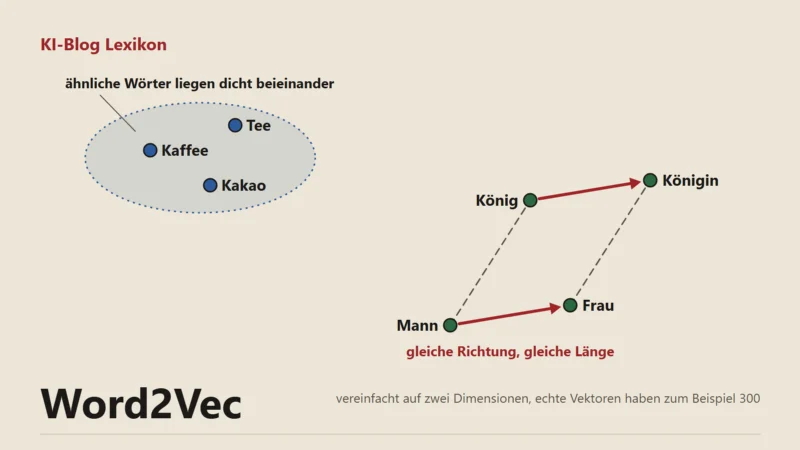
König minus Mann plus Frau ergibt ungefähr Königin. Mit diesem Rechenbeispiel zeigten Tomas Mikolov, Wen-tau Yih und Geoffrey Zweig im Juni 2013, dass gelernte Wortvektoren Beziehungen zwischen Wörtern als feste Richtungen im Zahlenraum speichern2. Word2Vec, im selben Jahr von Mikolovs Team veröffentlicht, lernte solche Vektoren für die Sprachverarbeitung mit wenig Rechenaufwand aus sehr großen Textmengen1.
Bedeutung als Nähe
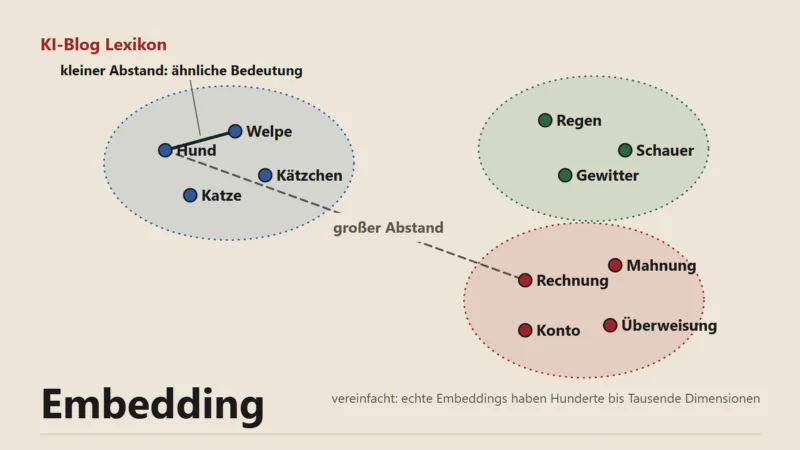
Ein Wort lässt sich durch die Wörter beschreiben, neben denen es steht. "Kaffee" taucht in der Nähe von "trinken", "Tasse" und "heiß" auf, "Tee" ebenfalls, also bekommen beide ähnliche Vektoren. Word2Vec lernt diese Vektoren mit einem flachen neuronalen Netz, das an großen Textmengen übt, Wörter aus ihrer Umgebung vorherzusagen. Nach dem Training wird das Netz weggeworfen; was bleibt, ist eine Tabelle mit einem Vektor je Wort. Laut der ersten Arbeit erreichten die Verfahren deutlich höhere Genauigkeit bei Ähnlichkeitstests als frühere neuronale Ansätze, bei viel geringerem Rechenaufwand1.
Wie nah sich zwei Vektoren sind, misst man meist über den Winkel zwischen ihnen, die Kosinus-Ähnlichkeit. Zeigen zwei Vektoren fast in dieselbe Richtung, gelten die Wörter als verwandt. Ob auch die Richtungen stimmen, prüften die Forscher mit Analogieaufgaben nach dem Muster "Mann verhält sich zu Frau wie König zu ?". In der Arbeit von Mikolov, Yih und Zweig lösten die Vektoren knapp 40 Prozent der Aufgaben zur Grammatik richtig2.
Das Werkzeug kennt zwei Bauarten3. CBOW sagt ein Wort aus seinen Nachbarn vorher, Skip-gram geht umgekehrt vor und sagt die Nachbarn aus dem Wort vorher. In einer zweiten Arbeit beschleunigten die Autoren das Training unter anderem mit Negative Sampling und mit dem Ausdünnen sehr häufiger Wörter. Außerdem lernten sie Vektoren für feste Wortgruppen wie "Air Canada", deren Bedeutung sich nicht aus "Air" und "Canada" zusammensetzen lässt4.
Fertige Vektoren zum Herunterladen
Google stellte den Code als freies Werkzeug bereit, zusammen mit vortrainierten Vektoren3. Sie wurden auf einem Datensatz aus Google News mit rund 100 Milliarden Wörtern trainiert und decken 3 Millionen Wörter und Wortgruppen mit je 300 Zahlen ab3.
Ein Vektor pro Wort
Jedes Wort bekommt genau einen Vektor, egal in welchem Satz es steht. "Bank" als Sitzgelegenheit und "Bank" als Geldinstitut landen im selben Punkt, irgendwo zwischen beiden Bedeutungen. Die Wortstellung geht ebenfalls verloren: Die Autoren nennen selbst die Gleichgültigkeit gegenüber der Reihenfolge der Wörter und die Schwierigkeit mit Redewendungen als Schwächen solcher Wortvektoren4. Für Wörter, die im Training nie vorkamen, gibt es überhaupt keinen Vektor.
Wortvektoren übernehmen außerdem, was in den Texten steckt, auch Vorurteile. Tolga Bolukbasi und Kollegen zeigten 2016, dass Vektoren aus Google-News-Artikeln deutliche Geschlechterklischees enthalten, eine Form von KI-Bias. Sie schlugen ein Verfahren vor, um solche Zuordnungen herauszurechnen, ohne nützliche wie die zwischen Königin und weiblich zu verlieren6.
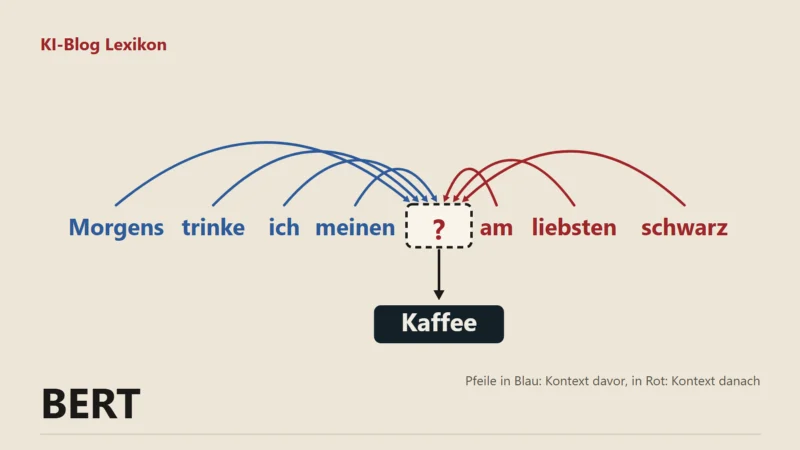
Spätere Modelle berechnen den Vektor eines Wortes aus dem ganzen Satz. BERT bezog 2018 den Kontext links und rechts eines Wortes in allen Schichten ein5. Heutige Embeddings für die semantische Suche stammen aus solchen kontextabhängigen Modellen und bilden ganze Sätze oder Absätze ab.
Häufige Fragen
Ist Word2Vec ein Sprachmodell?
Im heutigen Sinn nicht. Es erzeugt keine Texte und liefert nur Vektoren für einzelne Wörter, die andere Programme weiterverwenden.
Wie viele Zahlen hat ein Word2Vec-Vektor?
Das legt man beim Training fest. Die von Google veröffentlichten Vektoren haben je 300 Werte3.
Funktioniert Word2Vec auch mit deutschen Texten?
Ja, das Verfahren ist an keine Sprache gebunden und lernt aus jedem ausreichend großen Textbestand. Die mitgelieferten Vektoren stammen aus dem Google-News-Datensatz3, für Deutsch trainiert man besser auf deutschen Texten.
Quellen
Stand:
- arXiv (Mikolov u. a.): Efficient Estimation of Word Representations in Vector Space, Stand 09/2013, abgerufen am 22.11.2026. zurück
- ACL Anthology (Mikolov, Yih, Zweig): Linguistic Regularities in Continuous Space Word Representations, Stand 06/2013, abgerufen am 22.11.2026. zurück
- Google Code Archive: word2vec, abgerufen am 22.11.2026. zurück
- arXiv (Mikolov u. a.): Distributed Representations of Words and Phrases and their Compositionality, Stand 16.10.2013, abgerufen am 22.11.2026. zurück
- arXiv (Devlin u. a.): BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, Stand 05/2019, abgerufen am 22.11.2026. zurück
- arXiv (Bolukbasi u. a.): Man is to Computer Programmer as Woman is to Homemaker? Debiasing Word Embeddings, Stand 21.07.2016, abgerufen am 22.11.2026. zurück