Lexikon · B
BERT
Am Beispiel der Suchanfrage "2019 brazil traveler to usa need a visa" erklärte Google im Oktober 2019, was BERT in der Suche ändert2. Frühere Systeme übergingen das kleine Wort "to" und lieferten Ergebnisse für US-Bürger, die nach Brasilien reisen. Mit BERT erkannte die Suche, dass jemand aus Brasilien in die USA will2. Laut Google half das Modell damals bei etwa jeder zehnten englischsprachigen Suchanfrage in den USA, beim Ranking und bei den hervorgehobenen Snippets2.
Für diese Snippets setzte Google BERT gleich in rund zwei Dutzend Ländern ein und nannte deutliche Verbesserungen etwa auf Koreanisch, Hindi und Portugiesisch2. Was das Modell an englischen Texten gelernt hatte, ließ sich nach Googles Darstellung auf andere Sprachen übertragen2.
In beide Richtungen lesen
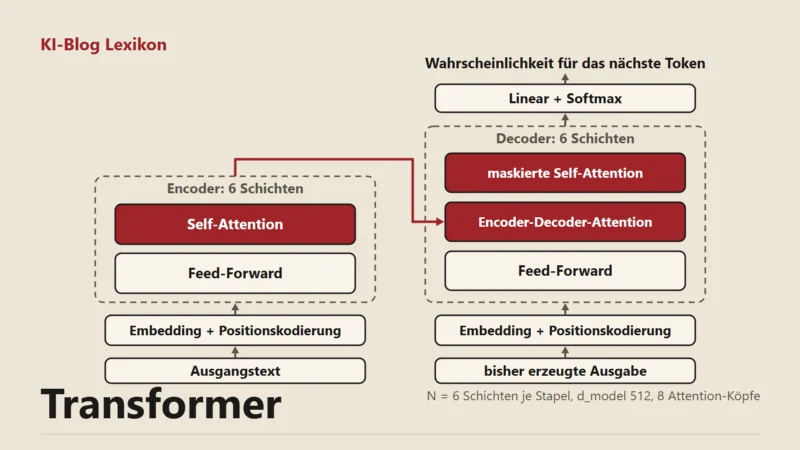
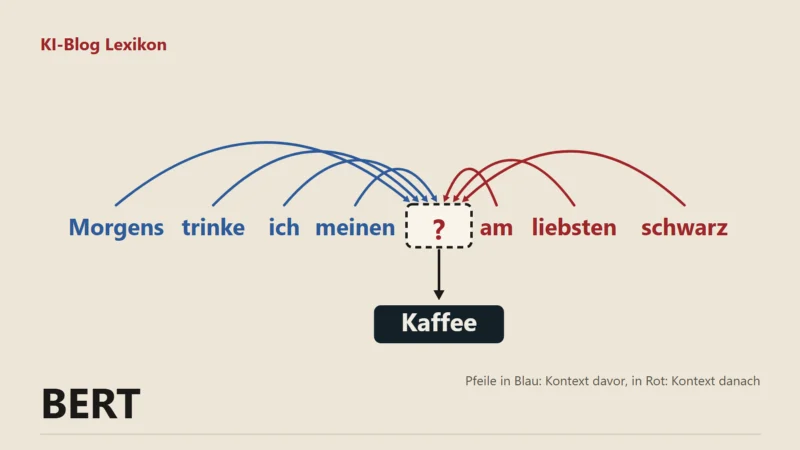
BERT steht für Bidirectional Encoder Representations from Transformers3. Wie der Name sagt, arbeitet das Modell mit dem Encoder des Transformers und bezieht in allen Schichten den Kontext auf beiden Seiten eines Wortes ein1. Im Training werden Wörter im Text verdeckt, und das Modell muss sie aus den Nachbarn links und rechts erraten3. Bei der mehrsprachigen Fassung trifft das etwa 15 Prozent der Wörter4.
Ein GPT-Modell liest dagegen nur in eine Richtung und sagt jeweils das nächste Wort voraus, deshalb kann es Texte fortschreiben. Die Modellkarte der mehrsprachigen BERT-Fassung verweist für das Erzeugen von Text ausdrücklich auf Modelle wie GPT-24.
Vortrainieren und anpassen
Die ursprünglichen Modelle gab es in zwei Größen. BERT-Base hat 12 Schichten und 110 Millionen Parameter, BERT-Large 24 Schichten und 340 Millionen6. Später kamen eine mehrsprachige Fassung, ein chinesisches Modell und im März 2020 eine Reihe von 24 kleineren englischen Modellen hinzu6.
Im November 2018 veröffentlichte Google den Programmcode und vortrainierte englische Modelle als Open Source3. Für eine neue Aufgabe genügt eine zusätzliche Ausgabeschicht, die per Fine-Tuning mit eigenen Beispielen trainiert wird1. Nach Angabe der Entwickler ließ sich so ein Frage-Antwort-System in etwa 30 Minuten auf einer einzelnen Cloud-TPU oder in wenigen Stunden auf einer Grafikkarte trainieren3.
Im ursprünglichen Aufsatz erzielte BERT in elf Aufgaben der Sprachverarbeitung Bestwerte, darunter einen GLUE-Wert von 80,5 Prozent und beim Frage-Antwort-Test SQuAD 1.1 einen Wert von 93,2, gemessen als F1-Score1.
Wo BERT heute arbeitet
Die Modellkarte der mehrsprachigen Fassung nennt als Einsatz Aufgaben, die den ganzen Satz verwenden: das Einordnen von Sätzen, das Einordnen einzelner Wörter und die Fragebeantwortung4. Dazu gehören Textklassifikation, etwa das Sortieren von Kundenanfragen, und die Named Entity Recognition, die Namen, Orte und Firmen im Text findet. Diese Fassung wurde auf Wikipedia-Texten der 104 Sprachen mit den größten Wikipedias trainiert4.
Die Entwickler von ModernBERT nannten solche Encoder im Dezember 2024 ein Arbeitspferd zahlreicher Produktivsysteme für Suche und Klassifikation5. Ihre überarbeitete Fassung verarbeitet 8192 Tokens am Stück, wurde mit 2 Billionen Tokens trainiert und ist für die Ausführung auf verbreiteten Grafikkarten ausgelegt5.
Häufige Fragen
Was bedeutet die Abkürzung BERT?
Bidirectional Encoder Representations from Transformers. "Bidirectional" heißt, dass das Modell den Kontext auf beiden Seiten eines Wortes nutzt3.
Kann BERT Texte schreiben wie ChatGPT?
Nein. BERT ist für das Verstehen und Einordnen gebaut; für das Erzeugen von Text verweist die Modellkarte auf Modelle wie GPT-24.
Nutzt Google BERT noch in der Suche?
Google hat BERT im Oktober 2019 für Ranking und hervorgehobene Snippets eingeführt2. Welche Modelle heute im Einzelnen in der Suche arbeiten, legt Google nicht vollständig offen.
Quellen
Stand:
- arXiv (Devlin u. a.): BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, Stand 05/2019, abgerufen am 22.11.2026. zurück
- Google (Pandu Nayak): Understanding searches better than ever before, Stand 25.10.2019, abgerufen am 22.11.2026. zurück
- Google Research (Devlin, Chang): Open Sourcing BERT: State-of-the-Art Pre-training for Natural Language Processing, Stand 02.11.2018, abgerufen am 22.11.2026. zurück
- Hugging Face (Google): Modellkarte bert-base-multilingual-cased, abgerufen am 22.11.2026. zurück
- arXiv (Warner u. a.): Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference, Stand 19.12.2024, abgerufen am 22.11.2026. zurück
- GitHub (google-research): bert: TensorFlow code and pre-trained models for BERT, abgerufen am 22.11.2026. zurück