Werkzeuge · Vergleich
Sprachmodelle im Vergleich
Kurzantwort
Die Spitzenmodelle von Anthropic, OpenAI und Google verarbeiten heute rund eine Million Token Kontext und kosten über die API zwischen 0,10 und 8 US-Dollar je Million Eingabetoken13524. In der Text-Arena lagen am 20.11.2026 drei Gemini-4-Modelle vorn, auf Platz 4 folgte ein Modell von Meta, auf Platz 5 Claude Opus 5.57. Von den verglichenen Hauptmodellen hat nur DeepSeek offene Gewichte; OpenAI bietet daneben getrennt die Modelle gpt-oss an814.
Wer Sprachmodelle vergleicht, schaut meist zuerst auf eine Rangliste.Die aktuellen Spitzenmodelle von Anthropic, OpenAI und Google liegen in öffentlichen Bewertungen nah beieinander, unterscheiden sich aber im Preis teils um das Achtzigfache und in ihren Stärken deutlich724. Für die Auswahl zählen deshalb Aufgabe, Preis, Kontextlänge, Datenschutz und die Frage, ob du ein Modell selbst betreiben willst.
Der Betreiber dieser Website, SEO NW, bietet selbst KI- und GEO-Dienste an. Die Angaben unten stammen von den Modellseiten der Anbieter und aus einer öffentlichen Rangliste.
Die aktuellen Modelle der großen Anbieter
Anthropic führt vier aktuelle Modelle. Claude Fable 5.2 ist für besonders anspruchsvolles Denken und lange, eigenständige Aufgaben gedacht, Claude Opus 5.5 für lang laufende Programmier- und Wissensarbeit, Claude Sonnet 5.5 als beste Verbindung aus Tempo und Intelligenz und Claude Haiku 5.5 für große Mengen schneller Aufgaben wie Einordnen, Herausziehen und Weiterleiten1. Wer unsicher ist, soll laut Anthropic mit Opus 5.5 beginnen1.
OpenAI nennt ebenfalls vier aktuelle Modelle. GPT-6.2 Astra ist das leistungsfähigste für die schwierigsten Projekte, GPT-6.2 Sol das Modell für den Arbeitsalltag einschließlich Programmieren und Agenten, GPT-6.1 Terra ein schnelles Modell für visuelles Denken, Computerbedienung und natürliches Schreiben und GPT-6 Luna das sparsamste für große Mengen einfacher Aufgaben3.
Bei Google heißt die aktuelle Reihe Gemini 4. Gemini 4 Carbon ist das stärkste Modell für komplexe Softwareentwicklung, Wissensarbeit und Wissenschaft, Gemini 4 Neon soll Spitzenleistung mit schneller Erledigung verbinden, Gemini 4 Hydrogen ist auf alltägliches Programmieren und Tempo ausgelegt, und Gemini 4 Argon denkt effizient mit weniger Token je Antwort als Carbon5. Dazu kommen günstigere Flash-Modelle wie Gemini 3.8 Flash5.
DeepSeek aus China veröffentlicht seine Modelle mit offenen Gewichten. DeepSeek-V4.1-Flash hat insgesamt 763 Milliarden Parameter, von denen je Rechenschritt nur 8 bis 16 Milliarden aktiv sind, und steht unter der MIT-Lizenz8. Das größere DeepSeek-V4-Pro-0813 hat 1,7 Billionen Parameter9.
Mehr als Text: Bilder, Ton und Werkzeuge
Alle aktuellen Claude-Modelle verarbeiten Text und Bilder als Eingabe, antworten mit Text, beherrschen mehrere Sprachen und können Werkzeuge aufrufen1. Die Modelle der Reihe Gemini 4 nehmen zusätzlich Ton, Video und PDF-Dateien entgegen5. Bei OpenAI hebt die Modellseite für GPT-6.1 Terra visuelles Denken und die Bedienung eines Computers hervor3.
Für die Auswahl heißt das: Wer Videos oder Tonaufnahmen direkt auswerten will, findet bei Google die breiteste Eingabe. Für reine Textarbeit spielen diese Unterschiede kaum eine Rolle.
Auch beim Nachdenken unterscheiden sich die Modelle. Anthropic lässt seine aktuellen Modelle selbst entscheiden, wie lange sie nachdenken, gesteuert über eine Einstellung für den Aufwand; bei Fable 5.2 und Opus 5.5 ist das Denken immer eingeschaltet1. In der Arena tauchen deshalb viele Modelle mehrfach auf, etwa mit hohem oder maximalem Aufwand, und jede Stufe verbraucht unterschiedlich viele Token7.
Kontextlänge und Antwortlänge
Beim Kontextfenster haben die großen Anbieter fast gleichgezogen. Alle vier aktuellen Claude-Modelle verarbeiten eine Million Token und schreiben bis zu 128.000 Token Antwort1. Die vier aktuellen Modelle von OpenAI kommen auf 1,05 Millionen Token Kontext und ebenfalls 128.000 Token Ausgabe3. Die vier Modelle der Reihe Gemini 4 verarbeiten eine Million Token5. DeepSeek-V4.1-Flash nennt bis zu eine Million Token Kontext8.
Was eine Million Token bedeutet, rechnet Anthropic vor: rund 555.000 Wörter oder 2,5 Millionen Zeichen mit dem aktuellen Tokenizer1. Damit passt ein ganzes Fachbuch in eine einzelne Anfrage. Wie viele Token dein eigener Text hat, schätzt der Token-Zähler.
Lange Eingaben kosten auch mehr. Rechenbeispiel: Eine Anfrage mit 500.000 Eingabetoken kostet bei Claude Sonnet 5.5 allein für die Eingabe rund 1 US-Dollar; bei Haiku 5.5 gilt über 100.000 Token Prompt ein höherer Preis, bei OpenAI über 272.000 Token24. Ein großes Fenster heißt außerdem nicht, dass ein Modell alles darin gleich gut berücksichtigt. Bei sehr langen Eingaben lohnt es sich, gezielt nach Abschnitten zu fragen.
Preis und Leistung
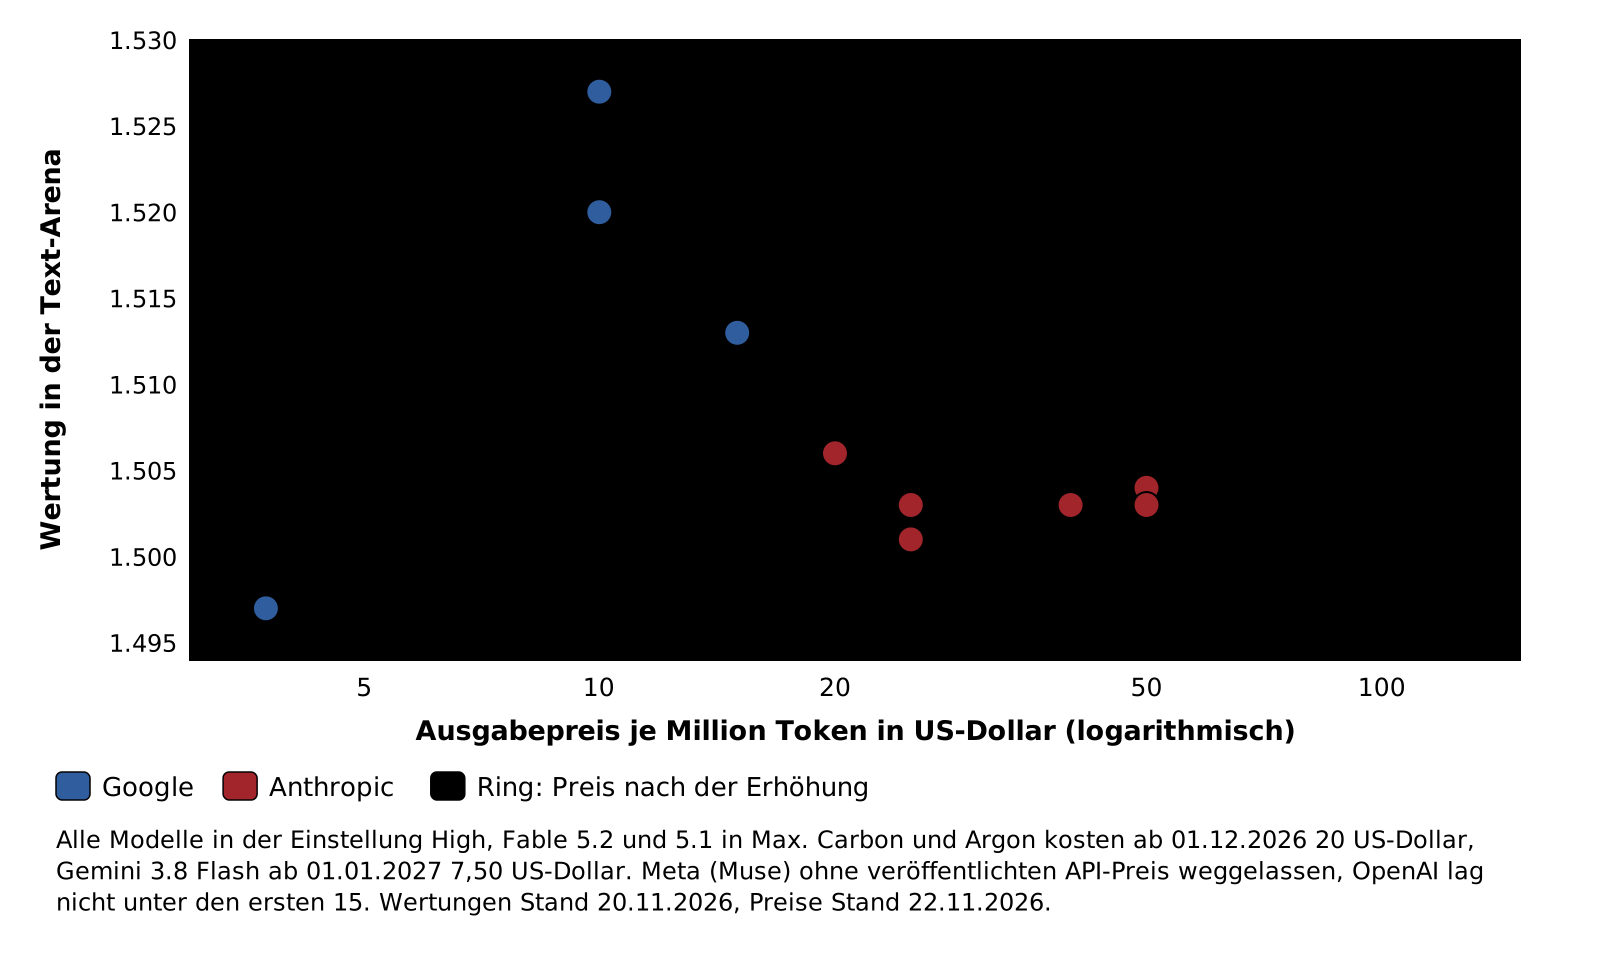
- Blau Google
- Rot Anthropic
Über die API zahlst du je Million Token, getrennt nach Eingabe und Ausgabe, und bei allen hier verglichenen Modellen kostet die Ausgabe das Fünffache der Eingabe246. Die Spanne zwischen den Klassen ist groß. Die kleinsten Modelle von Anthropic und OpenAI, Haiku 5.5 und GPT-6 Luna, kosten 0,10 US-Dollar je Million Eingabetoken, die größten, Fable 5.2 und GPT-6.2 Astra, das Achtzigfache24. Googles Gemini-4-Reihe liegt mit Eingabepreisen von 1,50 bis 3 US-Dollar dazwischen; für Gemini 4 Carbon steigt der Preis am 01.12.2026 von 2 und 10 auf 4 und 20 US-Dollar6.
Die Grafik setzt den Ausgabepreis gegen die Wertung in der Text-Arena. Sie zeigt ein Muster, das sich in vielen Vergleichen wiederholt: Die teuersten Modelle sind nicht automatisch die am besten bewerteten. Gemini 4 Carbon lag am 20.11.2026 auf Platz 1 und kostet zum Einführungspreis ein Viertel von Claude Fable 5.2, das auf Platz 7 stand762. Die Arena misst aber nur, welche Antworten Menschen in einem direkten Vergleich lieber mögen.
Vorsicht beim Vergleich nach Listenpreis: Verschiedene Modelle zerlegen denselben Text in unterschiedlich viele Token. Anthropic schreibt, dass Claude ab Version 4.7 für denselben Text ungefähr 30 Prozent mehr Token erzeugt als frühere Modelle2. Den Preis für deine eigene Aufgabe rechnet der API-Preisvergleich aus; dort stehen auch alle Preisstufen.
Kosten im Betrieb senken
Wer Modelle in eigenen Anwendungen einsetzt, zahlt den Listenpreis selten voll. Anthropic und OpenAI geben für Stapelanfragen, die nicht sofort beantwortet werden müssen, 50 Prozent Nachlass24. Wiederkehrende Teile einer Anfrage, etwa eine lange Anweisung, lassen sich zwischenspeichern; ein Treffer im Zwischenspeicher kostet bei den meisten Claude-Modellen ein Zehntel des Eingabepreises, bei Opus 5.5 und Sonnet 5.5 ein Zwanzigstel2.
Den Wechsel gleich einplanen
Modelle veralten schnell. Anthropic nennt für jedes Modell ein frühestes Abschaltdatum, und neue Fassungen erscheinen in kurzen Abständen1. Baue eine Anwendung deshalb so, dass sich das Modell austauschen lässt, ohne alles neu zu schreiben: Anweisungen und Testfälle getrennt vom Code halten, die Ergebnisse regelmäßig mit denselben Testfällen prüfen und bei einem neuen Modell erst vergleichen, dann umstellen.
Wie du Benchmarks und Ranglisten liest
Ein Benchmark ist ein standardisierter Test mit festen Aufgaben, etwa Matheaufgaben, Programmieraufgaben oder Wissensfragen. Eine Rangliste wie die Text-Arena funktioniert anders: Nutzer stellen eine Frage, bekommen zwei anonyme Antworten und wählen die bessere7. Aus vielen solchen Duellen entsteht eine Wertung; die Seite nennt insgesamt 9.213.799 Stimmen7.
Vier Punkte helfen beim Lesen. Erstens die Abstände: Am 20.11.2026 trennten Platz 1 mit 1.527 Punkten und Platz 12 mit 1.497 Punkten nur 30 Punkte7. Die Arena zeigt für die Wertungen Vertrauensbereiche; liegen zwei Modelle innerhalb dieser Bereiche, ist der Unterschied nicht belastbar. Zweitens die Einstellung: Viele Modelle tauchen mehrfach auf, etwa mit hoher oder maximaler Denkleistung, und diese Varianten kosten unterschiedlich viel. Drittens die Lücken: Unter den ersten 15 stand am 20.11.2026 kein Modell von OpenAI, was eher über die Methode als über die Modelle sagt7. Viertens die Herkunft: Zahlen, die ein Anbieter selbst über sein Modell veröffentlicht, sind schwerer zu prüfen als unabhängige Messungen.
Ein eigener Test ist am aussagekräftigsten: Nimm zehn typische Aufgaben aus deinem Alltag, lass zwei oder drei Modelle sie lösen und bewerte die Ergebnisse, ohne zu wissen, welches Modell welche Antwort geschrieben hat.
Modellkarten lesen
Jeder große Anbieter veröffentlicht zu seinen Modellen eine Beschreibung mit technischen Daten, die man Model Card oder Modellkarte nennt. Dort findest du Kontextlänge, maximale Ausgabe, Preise, den Wissensstand und den geplanten Ruhestand eines Modells. Für die aktuellen Claude-Modelle nennt Anthropic als verlässlichen Wissensstand Juni 2026 und eine Abschaltung je nach Modell frühestens zwischen September und November 20271. OpenAI nennt für GPT-6.2 Astra den 18.05.2026 und für GPT-6.2 Sol den 01.06.2026 als Wissensstand3.
Der Wissensstand ist wichtig, wenn du nach aktuellen Ereignissen fragst. Alles, was danach geschah, kennt das Modell nur, wenn es im Netz sucht oder du ihm die Informationen mitgibst.
Datenschutz als Auswahlkriterium
Über die API trainieren Anthropic und OpenAI standardmäßig nicht mit den Daten ihrer Kunden1011. Beim Ort unterscheiden sie sich: OpenAI lässt berechtigte API-Kunden Europa als Verarbeitungsort wählen, Anthropic nennt für Arbeitsbereiche der API als Speicherort derzeit nur die USA1112. DeepSeek speichert die Daten seines eigenen Dienstes nach eigener Angabe in China13. Wer personenbezogene Daten verarbeitet, sollte diese Punkte vor der Modellwahl klären; eine Übersicht über Firmentarife steht bei den datenschutzkonformen Chatbots.
Offene Gewichte und eigener Betrieb
Offene Gewichte bedeuten, dass du die Modelldateien herunterladen und selbst betreiben darfst. Für die oben genannten Modelle von Anthropic, OpenAI und Google nennen die Modellseiten keine offenen Gewichte; du nutzt sie über deren Dienste135. DeepSeek stellt seine Modelle samt Gewichten unter der MIT-Lizenz auf Hugging Face bereit8. OpenAI hat mit gpt-oss zusätzlich eigene offene Modelle veröffentlicht, die nicht zu den oben genannten Hauptmodellen gehören14.
Wer ein Modell selbst betreibt, behält die Daten im Haus. Die Größe der DeepSeek-Modelle sprengt aber jeden normalen Rechner; für den eigenen PC kommen kleinere offene Modelle infrage, die die Übersicht zu lokalen Sprachmodellen vorstellt. Was der Datenschutz bei DeepSeeks eigenem Dienst bedeutet, steht im Vergleich DeepSeek oder ChatGPT.
Welches Modell für welche Aufgabe
Bei großen Mengen einfacher Aufgaben, etwa Texte einordnen oder Daten aus Formularen ziehen, reichen die kleinen Modelle: Claude Haiku 5.5, GPT-6 Luna oder ein Flash-Modell von Google135. Für den Arbeitsalltag mit Texten und Programmieren sind die Mittelklassemodelle Claude Sonnet 5.5, GPT-6.2 Sol und Gemini 4 Hydrogen ein guter Ausgangspunkt135. Schwierige, lange Aufgaben rechtfertigen die großen Modelle Claude Opus 5.5 oder Fable 5.2, GPT-6.2 Astra und Gemini 4 Carbon135.
Wer die Modelle als Chat-App nutzt, findet Apps und Abos im Vergleich der KI-Chatbots.
| Modell | Gedacht für | Kontext | Preis je Million Token (Ein und Aus) | Offene Gewichte |
|---|---|---|---|---|
| Claude Fable 5.2 | anspruchsvolles Denken, lange eigenständige Aufgaben | 1 Million, Ausgabe 128.000 | 8 und 40 US-Dollar | nein |
| Claude Opus 5.5 | lang laufende Programmier- und Wissensarbeit | 1 Million, Ausgabe 128.000 | 4 und 20 US-Dollar | nein |
| Claude Sonnet 5.5 | Tempo und Intelligenz im Alltag | 1 Million, Ausgabe 128.000 | 2 und 10 US-Dollar | nein |
| Claude Haiku 5.5 | große Mengen schneller Aufgaben | 1 Million, Ausgabe 128.000 | ab 0,10 und 0,50 US-Dollar | nein |
| GPT-6.2 Astra | schwierigste Projekte | 1,05 Millionen, Ausgabe 128.000 | 8 und 40 US-Dollar | nein |
| GPT-6.2 Sol | Arbeitsalltag, Programmieren, Agenten | 1,05 Millionen, Ausgabe 128.000 | 2 und 10 US-Dollar | nein |
| GPT-6 Luna | große Mengen einfacher Aufgaben | 1,05 Millionen, Ausgabe 128.000 | 0,10 und 0,50 US-Dollar | nein |
| Gemini 4 Carbon | komplexe Softwareentwicklung, Wissenschaft | 1 Million | 2 und 10 US-Dollar, ab 01.12.2026 4 und 20 | nein |
| Gemini 4 Neon | Spitzenleistung mit Tempo | 1 Million | 3 und 15 US-Dollar | nein |
| Gemini 4 Hydrogen | alltägliches Programmieren, Tempo | 1 Million | 1,50 und 7,50 US-Dollar | nein |
| DeepSeek-V4.1-Flash | Chat und Programmieren | 1 Million | über DeepSeek-API ab 0,15 und 0,60 US-Dollar außerhalb der Spitzenzeit | ja, MIT-Lizenz |
Stand: 22.11.2026 Angaben laut Modellseiten und Preisseiten der Anbieter am 22.11.2026, API-Standardpreise ohne Steuer. "Nein" bei offenen Gewichten heißt: Die Modellseite nennt keine.
Was das für dich heißt
Teste zwei oder drei Modelle mit deinen eigenen Aufgaben, bevor du dich nach einer Rangliste richtest.
- Fang für den Alltag mit einem Mittelklassemodell an und steig nur bei Bedarf auf.
- Lies bei Ranglisten die Abstände und die Varianten mit, nicht nur den Platz.
- Rechne den Preis mit deiner eigenen Tokenmenge aus.
- Prüf den Wissensstand des Modells, wenn du nach aktuellen Themen fragst.
Häufige Fragen
Welches Sprachmodell ist das beste?
Ein bestes für alle gibt es nicht. In der Text-Arena lag am 20.11.2026 Gemini 4 Carbon vorn, die Abstände zu den folgenden Modellen waren aber klein7. Für deine Aufgabe entscheidet ein eigener Test.
Was sagt ein LLM-Benchmark aus?
Ein Benchmark misst, wie gut ein Modell feste Testaufgaben löst. Er sagt wenig darüber, wie es mit deinen eigenen Aufgaben, deiner Sprache und deinem Fachgebiet zurechtkommt.
Welche Modelle kann ich selbst betreiben?
Warum unterscheiden sich die Preise so stark?
Größere Modelle brauchen mehr Rechenleistung je Antwort. Bei Anthropic kostet das größte aktuelle Modell je Million Ausgabetoken 40 US-Dollar, das kleinste 0,50 US-Dollar2.
Quellen
Stand:
- Anthropic: Claude Models Overview, abgerufen am 22.11.2026. zurück
- Anthropic: Claude API: Pricing, abgerufen am 22.11.2026. zurück
- OpenAI: Models, abgerufen am 22.11.2026. zurück
- OpenAI: API Pricing: Standard, abgerufen am 22.11.2026. zurück
- Google: Gemini API: Models, abgerufen am 22.11.2026. zurück
- Google: Gemini Developer API: Pricing, abgerufen am 22.11.2026. zurück
- Arena: Text Arena Leaderboard, Stand 20.11.2026, abgerufen am 22.11.2026. zurück
- Hugging Face: DeepSeek-V4.1-Flash: Modellkarte, abgerufen am 22.11.2026. zurück
- Hugging Face: Modelle von deepseek-ai, abgerufen am 22.11.2026. zurück
- Anthropic: Is my data used for model training? (kommerzielle Produkte), Stand 18.08.2026, abgerufen am 22.11.2026. zurück
- OpenAI: Enterprise privacy at OpenAI, abgerufen am 22.11.2026. zurück
- Anthropic: Data residency, abgerufen am 22.11.2026. zurück
- DeepSeek: Privacy Policy (Datenschutzerklärung), Stand 10.02.2026, abgerufen am 22.11.2026. zurück
- OpenAI: Introducing gpt-oss, Stand 05.08.2025, abgerufen am 22.11.2026. zurück