Lexikon · B
Benchmark
Kurzantwort
Ein fester Satz aus Aufgaben und Bewertungsregeln, an dem sich KI-Modelle vergleichen lassen, heißt Benchmark. Bekannt sind etwa MMLU mit Fragen aus 57 Fachgebieten1 und die Arena, in der Menschen über Antworten zweier Modelle abstimmen2. Ein hoher Wert zeigt, was ein Modell in genau diesem Test leistet, und lässt sich durch auswendig gelernte Aufgaben oder gezieltes Optimieren aufblähen34.
In den Tabellen, mit denen Hersteller neue Sprachmodelle vorstellen, steht hinter jeder Zeile ein Benchmark. Gemeint ist eine feste Sammlung von Aufgaben mit bekannten Lösungen und eine Regel, nach der gezählt wird. Weil alle Modelle dieselben Aufgaben bekommen, lassen sich die Ergebnisse nebeneinanderstellen.
Was klassische Tests messen
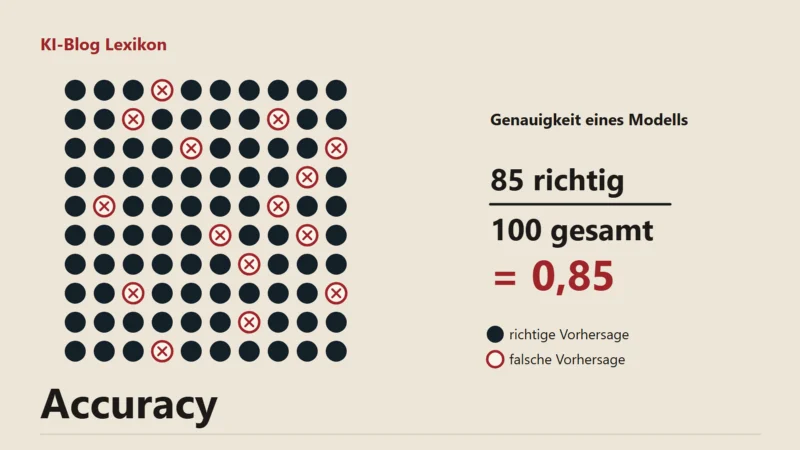
Die meisten Benchmarks prüfen Wissen oder Können mit Aufgaben, die eine eindeutige Lösung haben. MMLU stellt seit 2020 Fragen aus 57 Gebieten, darunter Grundschulmathematik, Informatik, Recht und Geschichte der USA1. Das größte GPT-3-Modell lag bei der Vorstellung im Schnitt knapp 20 Prozentpunkte über dem Zufall1. GSM8k besteht aus Textaufgaben mit Rechenwegen auf Grundschulniveau3. Gezählt wird meist die Accuracy, also der Anteil richtig gelöster Aufgaben. Bei offenen Aufgaben wie Programmcode prüfen Tests, ob das Ergebnis läuft und die erwarteten Ausgaben liefert.
Arena: Menschen stimmen ab
Einen anderen Weg geht die Arena, die als Forschungsprojekt an der University of California in Berkeley begann und lange Chatbot Arena hieß5. Nutzer stellen eine Frage, bekommen Antworten zweier Modelle und wählen die bessere; aus vielen solchen Paarvergleichen entsteht eine Rangliste2. In ihrem Aufsatz vom März 2024 berichteten die Betreiber von über 240.000 gesammelten Stimmen und einer guten Übereinstimmung zwischen den Urteilen der Nutzer und denen von Fachleuten2. Zuletzt hieß das Angebot LMArena, seit dem 28.01.2026 nur noch Arena5. Nach eigener Angabe nutzen es mehr als fünf Millionen Menschen im Monat, die Ranglisten sind nach Bereichen wie Text, Webentwicklung, Bildverstehen und Suche getrennt5.
Wie Ergebnisse geschönt werden
Ein Test verliert seinen Wert, sobald seine Aufgaben in den Trainingsdaten eines Modells stecken. Forschende um Hugh Zhang haben 2024 deshalb eine neue Aufgabensammlung namens GSM1k gebaut, die GSM8k in Stil und Schwierigkeit entspricht3. Unter den geprüften offenen und geschlossenen Modellen sank die Trefferquote darauf um bis zu 8 Prozentpunkte, mehrere Modellfamilien zeigten Anzeichen von systematischer Überanpassung an den alten Test3. Wer GSM8k-Aufgaben besonders leicht wiedergeben konnte, hatte tendenziell die größere Lücke; viele Spitzenmodelle zeigten dagegen kaum solche Anzeichen3.
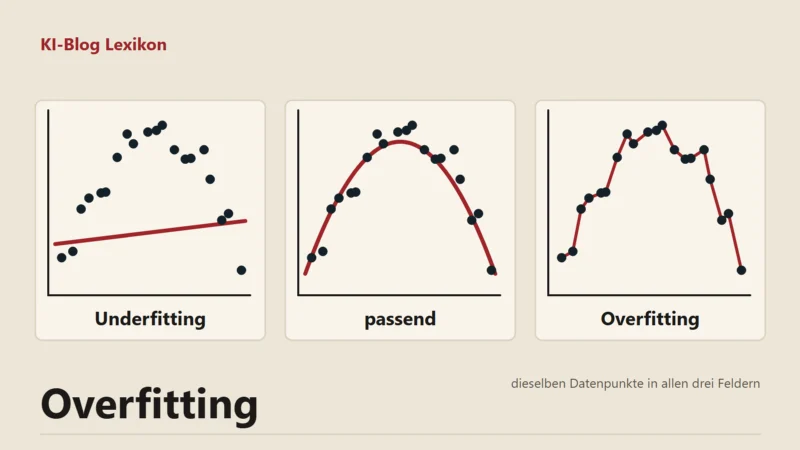
Bei der Arena liegt das Problem woanders. Die Studie "The Leaderboard Illusion" von 2025 beschreibt, dass einzelne Anbieter viele Varianten privat testen und nur die Ergebnisse veröffentlichen konnten, die ihnen gefielen; vor dem Start von Llama 4 zählten die Autoren 27 private Varianten von Meta4. Google und OpenAI erhielten nach ihrer Schätzung jeweils rund ein Fünftel aller Arena-Daten4. Ein Modell, das so gezielt auf eine Rangliste hin optimiert wird, steigt dort auf, ohne allgemein besser zu werden4. Das ist eine Form von Overfitting, nur am Test statt an den Trainingsdaten.
Was du aus den Zahlen mitnehmen kannst
Ein Benchmarkwert gilt für genau diese Aufgaben unter genau diesen Bedingungen: mit welchem Prompt, wie vielen Beispielen darin und wie vielen Versuchen je Aufgabe. Stammen Werte aus den Tabellen verschiedener Hersteller, können sich diese Bedingungen unterscheiden; das gilt auch für die Zahlen im Vergleich der KI-Modelle. Aussagekräftig ist ein Test mit Aufgaben aus deinem eigenen Einsatz, etwa zwanzig echte Anfragen, deren gute Antworten du kennst und die du jedem Kandidaten gleich stellst.
Häufige Fragen
Was ist die LLM Arena?
Kann ein Modell einen Benchmark auswendig lernen?
Ja, wenn die Testaufgaben im Trainingsmaterial stecken. Neue, gleich schwere Aufgaben wie bei GSM1k decken das auf3.
Welcher Benchmark ist der beste?
Keiner deckt alles ab. Wissensfragen, Rechenaufgaben, Programmieraufgaben und menschliche Abstimmungen messen Verschiedenes; für eine Entscheidung zählt der Test, der deiner Aufgabe am nächsten kommt.
Quellen
Stand:
- arXiv (Hendrycks u. a.): Measuring Massive Multitask Language Understanding, Stand 12.01.2021, abgerufen am 22.11.2026. zurück
- arXiv (Chiang u. a.): Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference, Stand 07.03.2024, abgerufen am 22.11.2026. zurück
- arXiv (Zhang u. a.): A Careful Examination of Large Language Model Performance on Grade School Arithmetic, Stand 22.11.2024, abgerufen am 22.11.2026. zurück
- arXiv (Singh u. a.): The Leaderboard Illusion, Stand 12.05.2025, abgerufen am 22.11.2026. zurück
- Arena: LMArena is now Arena, Stand 28.01.2026, abgerufen am 22.11.2026. zurück