Lokale KI · Vergleich
Welches lokale Modell?
Kurzantwort
Welches lokale Modell passt, entscheidet zuerst dein Grafikspeicher: Die Modelldatei muss samt Kontext hineinpassen17. Mit 8 GB laufen Modelle bis etwa neun Milliarden Parameter wie Qwen3.5 9B oder Llama 3.1 8B, mit 24 GB Modelle bis gut 30 Milliarden wie Gemma 4 31B234. Deutsch nennen Llama und Mistral ausdrücklich, Qwen3.5 und Gemma 4 werben mit über hundert Sprachen, und Qwen, Gemma und Mistral stehen unter der freien Apache-Lizenz9101213.
Eine Rangliste "bestes lokales Modell" gibt es nicht, denn drei Fragen entscheiden: Wie viel Grafikspeicher hast du, in welcher Sprache arbeitest du, und was darfst du mit dem Modell machen? Die Ollama-Bibliothek allein listet Dutzende Familien, von Llama über Qwen und Gemma bis zu DeepSeek und gpt-oss, jede in mehreren Größen1. Wir ordnen die wichtigsten nach diesen drei Fragen. Alle Größenangaben stammen aus der Ollama-Bibliothek und meinen die Datei in der voreingestellten Fassung, meist vier Bit1; Lizenz und Sprachen kommen aus den Modellkarten der Hersteller.
Wie viel Speicher ein Modell braucht
Ein Sprachmodell rechnet nur dann schnell, wenn es vollständig im VRAM der Grafikkarte liegt. Dort muss neben der Modelldatei auch der Speicher für den Kontext Platz finden, und der wächst mit der Kontextlänge17. Wie viel das ausmacht, zeigt unsere Probe: Llama 3.2 3B ist als Datei 2,0 GB groß, belegte mit 8192 Token Kontext auf der RTX 4090 aber rund 3,2 GB Grafikspeicher518. Plane also immer einen Puffer über der Dateigröße ein, bei langen Dokumenten einen großen.
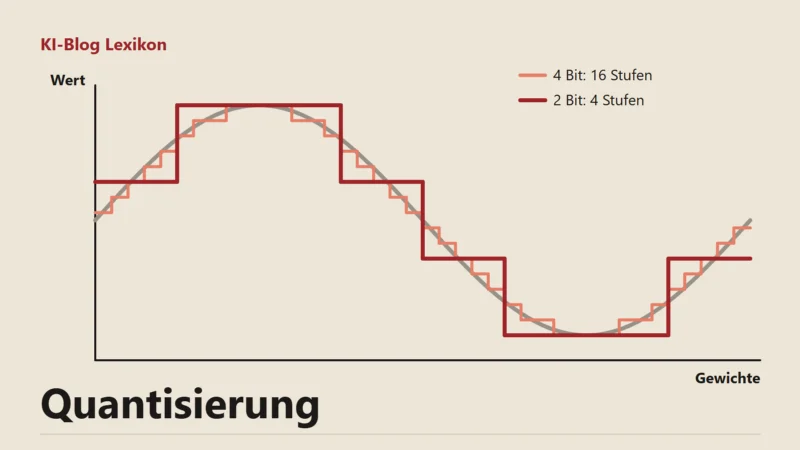
Die Dateigröße hängt an der Zahl der Parameter und an der Quantisierung. Ein Beispiel aus der Dokumentation von llama.cpp: Llama 3.1 8B schrumpft von 32,1 GB im Original auf 4,9 GB in der Stufe Q4_K_M, die 70-Milliarden-Fassung von 280,9 GB auf 43,1 GB16. Vier Bit sind deshalb der übliche Kompromiss für den Heimrechner. Der VRAM-Rechner schätzt den Bedarf eines Modells; wie sich die Stufen auf Qualität und Tempo auswirken, steht im Praxistest Quantisierung.
Die Familien im Überblick
Llama von Meta ist die älteste der großen offenen Familien. In der Ollama-Bibliothek gehören Llama 3.1 mit 8, 70 und 405 Milliarden Parametern und Llama 3.2 mit 1 und 3 Milliarden zu den meistgeladenen Modellen1. Llama 3.1 8B ist 4,9 GB groß, die 70B-Fassung 43 GB; beide verarbeiten bis zu 128K Token Kontext4. Meta nennt für Llama 3.1 und 3.2 acht offiziell unterstützte Sprachen, darunter Deutsch510.
Qwen von Alibaba erscheint in schneller Folge; die Bibliothek führt Qwen3.5 mit Größen von 0,8 bis 122 Milliarden Parametern2 und daneben neuere Fassungen wie Qwen3.6 und Qwen3.8, von dem es eine Variante mit 27 Milliarden Parametern gibt120. Qwen3.5 verarbeitet Bilder und Text, kann Werkzeuge aufrufen und vor der Antwort nachdenken2. Laut Modellkarte unterstützt Qwen3.5 9B 201 Sprachen und Dialekte und einen Kontext von 262.144 Token9. Wer "Qwen lokal" sucht, landet in Ollama mit qwen3.5:9b bei einer Datei von 6,6 bis 7,6 GB, mit qwen3.5:27b bei 17 bis 20 GB2.
Gemma von Google gibt es in der vierten Generation in fünf Größen: E2B, E4B, 12B, 26B A4B und 31B12. Die kleinen Fassungen haben 128K Token Kontext, die mittleren 256K12. Laut Modellkarte unterstützt Gemma 4 mehr als 35 Sprachen direkt und wurde mit über 140 Sprachen trainiert12. In Ollama ist gemma4:12b 7,7 bis 8,0 GB groß, gemma4:31b 19 bis 20 GB3.
Mistral aus Frankreich ist mit Mistral Small 3.2 vertreten, einem Modell mit 24 Milliarden Parametern, das Text und Bilder verarbeitet; in Ollama belegt es 15 GB814. Für die Vorgängerversion Mistral Small 3.1 nennt die Modellkarte Deutsch ausdrücklich und schreibt, das Modell passe quantisiert auf eine einzelne RTX 409013. Die Karte von Version 3.2 spricht von 24 Sprachen, ohne sie aufzuzählen14.
DeepSeek-R1 ist ein Reasoning-Modell, das vor der Antwort einen Denkweg ausgibt. Das vollständige Modell hat 671 Milliarden Parameter und ist in Ollama 404 GB groß, also nichts für den Heimrechner615. Für den Heimrechner kommen die abgeleiteten Fassungen mit 1,5 bis 70 Milliarden Parametern in Frage. Sie bauen auf Qwen 2.5 und Llama auf; DeepSeek hat sie mit Antworten des großen Modells nachtrainiert15. Die 14B-Fassung ist 9,0 GB groß, die 32B-Fassung 20 GB6.
gpt-oss ist die offene Modellreihe von OpenAI mit 20 und 120 Milliarden Parametern7. Die kleinere Fassung ist 14 GB groß und läuft laut Ollama schon auf Systemen mit 16 GB Speicher, die größere passt auf eine einzelne Karte mit 80 GB7.
| Familie | Größen in Ollama | Dateigröße (Beispiele) | Deutsch laut Modellkarte | Lizenz |
|---|---|---|---|---|
| Llama 3.1 und 3.2 (Meta) | 1B, 3B, 8B, 70B, 405B | 3B: 2,0 GB, 8B: 4,9 GB, 70B: 43 GB | ausdrücklich, eine von acht Sprachen | Llama Community License, multimodale 3.2-Modelle in der EU ausgenommen |
| Qwen3.5 (Alibaba) | 0,8B bis 122B | 9B: 6,6 bis 7,6 GB, 27B: 17 bis 20 GB | 201 Sprachen und Dialekte | Apache 2.0 |
| Gemma 4 (Google) | E2B, E4B, 12B, 26B, 31B | 12B: 7,7 bis 8,0 GB, 31B: 19 bis 20 GB | über 35 direkt, über 140 trainiert | Apache 2.0 |
| Mistral Small 3.2 (Mistral AI) | 24B | 15 GB | 24 Sprachen, Deutsch genannt bei Version 3.1 | Apache 2.0 |
| DeepSeek-R1 (abgeleitete Fassungen) | 1,5B bis 70B, voll 671B | 14B: 9,0 GB, 32B: 20 GB | keine Angabe | MIT plus Lizenz des Ausgangsmodells |
| gpt-oss (OpenAI) | 20B, 120B | 20B: 14 GB, 120B: 65 GB | nicht geprüft | Apache 2.0 |
Stand: 22.11.2026 Größen und Dateigrößen laut Ollama-Bibliothek (meist vier Bit), Sprachen und Lizenzen laut Modellkarten der Hersteller, abgerufen am 22.11.2026.
Modelle nach Grafikspeicher
Die folgende Einteilung richtet sich nach der Dateigröße in Ollama und lässt Platz für einen mittleren Kontext. Unsere Messwerte für Tempo und Speicher je Modell folgen in den Praxistests auf der RTX 4090 und der RTX 5060 Ti.
Mit 8 GB Grafikspeicher bleibst du bei Modellen bis etwa neun Milliarden Parameter. Llama 3.1 8B mit 4,9 GB und DeepSeek-R1 in der 8B-Fassung mit 5,2 GB lassen Raum für Kontext; Qwen3.5 9B mit 6,6 bis 7,6 GB füllt die Karte schon fast246. Für einfache Aufgaben auf schwacher Hardware reichen auch Llama 3.2 3B mit 2,0 GB oder Qwen3.5 4B mit 3,3 bis 4,0 GB25.
Mit 12 bis 16 GB, wie auf unserer RTX 5060 Ti, passen Gemma 4 12B mit 7,7 bis 8,0 GB und DeepSeek-R1 14B mit 9,0 GB bequem36. gpt-oss 20B mit 14 GB liegt an der Grenze einer 16-GB-Karte, ebenso Mistral Small 3.2 mit 15 GB78. Hier hilft ein kurzer Kontext, sonst rutscht ein Teil in den Arbeitsspeicher.
Mit 24 GB wie auf der RTX 4090 öffnet sich die Klasse um 30 Milliarden Parameter. Qwen3.5 27B mit 17 bis 20 GB, Gemma 4 31B mit 19 bis 20 GB und DeepSeek-R1 32B mit 20 GB passen hinein, lassen aber nur wenig Platz für lange Texte236. Mistral Small 3.2 hat hier mit 15 GB reichlich Luft für Kontext8.
Darüber beginnt die Klasse für Rechner mit mehreren Karten oder viel gemeinsamem Speicher, etwa einem Mac mit großem Arbeitsspeicher (Lokale KI auf dem Mac). Llama 3.1 70B und DeepSeek-R1 70B belegen je 43 GB, gpt-oss 120B 65 GB, Qwen3.5 122B 81 GB2467.
- Ausdrücklich genannt Deutsch steht in der Modellkarte
- Viele Sprachen Zahl der Sprachen ohne Einzelnennung geprüft
- Keine Angabe Modellkarte schweigt zu Sprachen, bei gpt-oss nicht geprüft
Deutsch laut Modellkarte
Ob ein Modell gutes Deutsch schreibt, hängt an seinen Trainingsdaten, und die Hersteller geben das unterschiedlich genau an. Meta führt Deutsch für Llama 3.1 und 3.2 unter acht offiziell unterstützten Sprachen510. Mistral nennt Deutsch für Small 3.1 ausdrücklich13. Qwen3.5 und Gemma 4 werben mit der Zahl der Sprachen, 201 Sprachen und Dialekte bei Qwen, mehr als 35 direkt unterstützte und über 140 trainierte Sprachen bei Gemma912. Für die abgeleiteten DeepSeek-Modelle macht die Modellkarte keine Angabe zu Sprachen; beim Vorläufer R1-Zero beschreibt DeepSeek das Problem, dass Sprachen in einer Antwort durcheinandergeraten15.
Eine Herstellerangabe ersetzt keinen Test, und eine lange Sprachliste sagt nichts darüber, wie natürlich ein Modell formuliert. Was veröffentlichte Ranglisten über lokale und Cloud-Modelle sagen und wo ihre Grenzen liegen, fasst der Ratgeber lokal gegen Cloud zusammen. Für den Anfang ist ein Modell, dessen Karte Deutsch ausdrücklich nennt und das mit den meisten Parametern noch in deinen Speicher passt, ein vernünftiger Ausgangspunkt für eigene Tests.
Was die Lizenzen erlauben
"Offen" heißt bei Sprachmodellen meist, dass die Gewichte frei herunterladbar sind (Open Weights). Was du damit tun darfst, regelt die Lizenz, und die unterscheidet sich deutlich.
Qwen3.5, Gemma 4 und Mistral Small stehen unter der Apache-Lizenz 2.0, die Nutzung, Änderung und kommerziellen Einsatz erlaubt91213. gpt-oss steht ebenfalls unter Apache 2.07. DeepSeek-R1 steht unter MIT-Lizenz; für die abgeleiteten Fassungen gelten zusätzlich die Lizenzen ihrer Ausgangsmodelle, also Apache 2.0 bei den Qwen-Fassungen und die Llama-Lizenz bei den Llama-Fassungen15.
Llama nutzt eine eigene Lizenz von Meta, die Llama Community License. Sie erlaubt kommerzielle Nutzung, verlangt aber eine eigene Lizenz von Meta, sobald ein Angebot im Vormonat mehr als 700 Millionen monatlich aktive Nutzer hatte10. Wichtiger für Leser in Deutschland: Für die multimodalen Modelle von Llama 3.2, die auch Bilder verstehen, gewährt die Lizenz Personen mit Wohnsitz und Firmen mit Hauptsitz in der EU die Nutzungsrechte nicht11. Die reinen Textmodelle mit 1 und 3 Milliarden Parametern betrifft das nicht.
Zwei Modelle selbst gegeneinander testen
Am Ende zählt, wie ein Modell mit deinen eigenen Aufgaben umgeht. Ein kleiner Test dauert keine halbe Stunde. Nimm drei oder vier Aufgaben aus deinem Alltag, etwa eine E-Mail auf Deutsch, eine Zusammenfassung eines bekannten Textes und eine Sachfrage, deren Antwort du sicher kennst. Stelle sie jedem Kandidaten wortgleich und in einem neuen Chat.
In Ollama zeigt der Zusatz --verbose nach jeder Antwort die Zeiten an, etwa wie viele Token je Sekunde das Modell erzeugt hat18. So siehst du gleich, ob ein größeres Modell noch flüssig genug läuft. Achte bei den Antworten auf drei Dinge: ob das Deutsch natürlich klingt, ob die Sachfrage stimmt und ob das Modell bei der Zusammenfassung Dinge erfindet. Fehlt ein Modell in der Ollama-Bibliothek, lädst du eine GGUF-Fassung direkt von Hugging Face mit ollama run hf.co/nutzer/repository19.
Notiere dir die Ergebnisse kurz. Nach zwei oder drei Durchgängen erkennst du meist, welches Modell für welche Art von Aufgabe taugt, und kannst ein zweites für Sonderfälle wie Bilder oder Rechenaufgaben behalten. Platz auf der SSD kostet das wenig im Vergleich zum Grafikspeicher.
Welches Modell für welche Aufgabe
Für Texte auf Deutsch, Zusammenfassungen und E-Mails ist ein Modell mit ausdrücklich genanntem Deutsch in der größten Fassung sinnvoll, die dein Speicher trägt: auf 8 GB Llama 3.1 8B, auf 24 GB Mistral Small 3.2 mit Platz für längere Texte481013. Wer Bilder, Tabellen als Foto oder Bildschirmfotos auswerten will, braucht ein Modell mit Bildeingang wie Qwen3.5, Gemma 4 oder Mistral Small 3.2238.
Für Rechenaufgaben und Logik bieten sich Reasoning-Modelle wie DeepSeek-R1 an; sie brauchen für ihre Denkschritte allerdings mehr Zeit und mehr Kontext. Für Programmierarbeit gibt es eigene Code-Modelle, die wir unter Programmieren mit lokalen Modellen vorstellen. Und wer wissen will, wie die lokalen Modelle gegen die großen Cloud-Modelle dastehen, findet die Übersicht der Anbieter im KI-Modelle-Vergleich.
Auf unserem Testrechner liegen derzeit Llama 3.2 3B, Qwen3.5 9B und eine Fassung von Qwen3.8 27B mit zusammen rund 26 GB18. Laden lassen sich alle genannten Modelle mit einem Befehl in Ollama oder über die Suche in LM Studio.
Was das für dich heißt
Starte mit der größten Fassung, die mit etwas Puffer in deinen Grafikspeicher passt, und teste sie an deinen eigenen Aufgaben.
- Schau vor dem Download in der Ollama-Bibliothek auf die Dateigröße und rechne Platz für den Kontext dazu.
- Prüfe nach dem Laden mit ollama ps, ob das Modell ganz auf der Grafikkarte liegt.
- Lies vor dem Einsatz im Betrieb die Lizenz in der Modellkarte.
- Vergleiche zwei Modelle mit denselben drei bis vier Fragen aus deinem Alltag.
Häufige Fragen
Was ist das beste lokale Modell für 16 GB Grafikspeicher?
Darf ich lokale Modelle kommerziell nutzen?
Reicht der Arbeitsspeicher statt Grafikspeicher?
Ein Modell läuft auch ganz oder teilweise im Arbeitsspeicher, dann aber deutlich langsamer. Ollama zeigt die Aufteilung mit ollama ps an17.
Quellen
Stand:
- Ollama: Modellbibliothek, sortiert nach Beliebtheit, Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- Ollama: Qwen3.5 in der Modellbibliothek, abgerufen am 22.11.2026. zurück
- Ollama: Gemma 4 in der Modellbibliothek, abgerufen am 22.11.2026. zurück
- Ollama: Llama 3.1 in der Modellbibliothek, abgerufen am 22.11.2026. zurück
- Ollama: Llama 3.2 in der Modellbibliothek, abgerufen am 22.11.2026. zurück
- Ollama: DeepSeek-R1 in der Modellbibliothek, abgerufen am 22.11.2026. zurück
- Ollama: gpt-oss in der Modellbibliothek, abgerufen am 22.11.2026. zurück
- Ollama: Mistral Small 3.2 in der Modellbibliothek, abgerufen am 22.11.2026. zurück
- Qwen auf Hugging Face: Qwen3.5-9B, Modellkarte, Stand 02/2026, abgerufen am 22.11.2026. zurück
- Meta auf Hugging Face: Llama 3.1 8B Instruct, Modellkarte, Stand 23.07.2024, abgerufen am 22.11.2026. zurück
- Meta auf Hugging Face: Llama 3.2 11B Vision Instruct, Modellkarte und Lizenz, abgerufen am 22.11.2026. zurück
- Google: Gemma 4, Modellkarte, Stand 2026, abgerufen am 22.11.2026. zurück
- Mistral AI auf Hugging Face: Mistral Small 3.1 24B Instruct 2503, Modellkarte, abgerufen am 22.11.2026. zurück
- Mistral AI auf Hugging Face: Mistral Small 3.2 24B Instruct 2506, Modellkarte, abgerufen am 22.11.2026. zurück
- DeepSeek auf Hugging Face: DeepSeek-R1, Modellkarte, abgerufen am 22.11.2026. zurück
- ggml-org: llama.cpp: llama-quantize (README), abgerufen am 22.11.2026. zurück
- Ollama: Kontextlänge (Dokumentation), abgerufen am 22.11.2026. zurück
- Eigene Messung: Eigene Installation Ollama 0.40.0 auf RTX 4090: ollama list, ollama --help und Probemessung llama3.2:3b Q4_K_M mit Kontext 8192 (VRAM vor dem Lauf 1820 MiB, Spitze im Mittel 4847 MiB), Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- Hugging Face: Ollama mit GGUF-Modellen vom Hub nutzen, abgerufen am 22.11.2026. zurück
- Ollama: Qwen3.8 in der Modellbibliothek, abgerufen am 22.11.2026. zurück