Grundlagen
Erklärbare KI
Kurzantwort
Erklärbare künstliche Intelligenz, kurz XAI, umfasst Verfahren, die das Verhalten eines KI-Modells nachvollziehbar machen sollen8. Bei tiefen neuronalen Netzen entstehen solche Erklärungen meist nachträglich, etwa als Gewichtung der Eingabemerkmale mit SHAP oder LIME134. Das BSI warnt, dass verschiedene Verfahren sich widersprechen und manipuliert werden können2.
Ein Kreditantrag wird abgelehnt, eine Bewerbung aussortiert, eine Netzwerkverbindung als Angriff gemeldet, und die Entscheidung hat ein KI-Modell getroffen. Erklärbare KI soll in solchen Fällen sichtbar machen, welche Angaben das Ergebnis getragen haben. Die Plattform Lernende Systeme beschreibt das Ziel so: Erklärbarkeit soll das Verhalten eines KI-Modells nachvollziehbar machen und zeigen, wie Ergebnisse, Vorhersagen oder Einstufungen zustande kommen8. Bei einfachen Modellen gelingt das direkt. Bei großen neuronalen Netzen bleibt jede Erklärung eine Annäherung von außen, mit eigenen Fehlern.
Warum große Modelle schwer zu erklären sind
Das BSI unterscheidet zwei Arten von Modellen1. Manche sind von sich aus erklärbar, etwa eine lineare Regression oder ein Entscheidungsbaum. Ihre Entscheidungsfunktion ist so einfach, dass man sie lesen kann: Ein Baum zeigt Schritt für Schritt, welche Schwelle bei welchem Merkmal den Ausschlag gab. Bei tiefen neuronalen Netzen ist das anders. Das BSI nennt sie funktionale Blackboxen, weil sich ihre Funktionsweise selbst bei vollem Zugriff auf das System nicht erfassen lässt1.
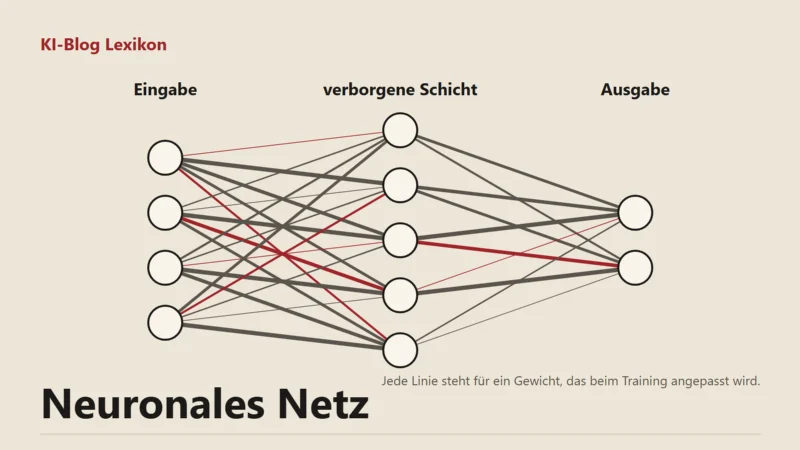
Der Grund liegt in der Bauweise. Ein neuronales Netz verteilt sein Wissen auf Millionen oder Milliarden von Gewichten, die über viele Schichten zusammenwirken. Keine einzelne Zahl steht für eine Regel wie "Einkommen unter einem Grenzwert führt zur Ablehnung". Die Regel, falls es eine gibt, ergibt sich erst aus dem Zusammenwirken unzähliger Werte, darum spricht man bei solchen Modellen von einer Black Box.
Für die Erklärung solcher Modelle setzt die Forschung auf nachträgliche Verfahren, englisch post hoc: Eine eigene Methode untersucht das fertige Modell von außen und liefert eine Annäherung an die Gründe für eine Vorhersage1.
Verfahren im Überblick
Nach dem BSI lassen sich die Verfahren nach zwei Merkmalen ordnen1. Lokale Verfahren erklären eine einzelne Vorhersage, globale beschreiben das Verhalten des ganzen Modells. Modellspezifische Verfahren funktionieren nur bei einer bestimmten Bauart, modellagnostische bei beliebigen Modellen. Dazu kommt die Art der Daten: Für Bilder gibt es andere Verfahren als für Texte oder Zahlen1.
Eine große Gruppe bilden die Verfahren der Merkmalswichtigkeit. Sie berechnen für jedes Eingabemerkmal, wie stark es zu einer Vorhersage beigetragen hat und in welche Richtung.
- SHAP stellten Scott Lundberg und Su-In Lee im Mai 2017 vor4. Das Verfahren weist jedem Merkmal für eine bestimmte Vorhersage einen Wichtigkeitswert zu und stützt sich auf die Shapley-Werte aus der Spieltheorie. Die Autoren zeigten, dass ihr Ansatz sechs ältere Erklärungsmethoden unter einem Dach vereint4.
- LIME von Marco Tulio Ribeiro, Sameer Singh und Carlos Guestrin aus dem Februar 2016 baut um eine einzelne Vorhersage herum ein einfaches, lesbares Ersatzmodell, das das große Modell in dieser Umgebung nachahmt3. Getestet wurde es an Text- und Bildklassifikation3.
- Salienzkarten markieren bei Bildern die Bildpunkte, die für die Einstufung besonders wichtig waren, meist als farbige Wärmekarte über dem Foto.
- Kontrafaktische Erklärungen suchen die kleinste Änderung an der Eingabe, mit der das Modell anders entschieden hätte1. Sie beantworten die Frage, die Betroffene meist stellen: Was hätte anders sein müssen?
Ein Beispiel aus der Netzwerksicherheit stammt aus demselben Papier. Ein KI-gestütztes System zur Angriffserkennung meldet ein verdächtiges Datenpaket, und eine lokale SHAP-Erklärung zeigt für vier Merkmale, welches am stärksten für die Meldung sprach und welche dagegen wirkten1. Erst eine solche Erklärung versetzt Fachleute nach Ansicht des BSI in die Lage, die Grundlage der Entscheidung nachzuvollziehen und zu entscheiden, ob sie dem Alarm folgen1.
Ein Beispiel: die abgelehnte Kreditanfrage
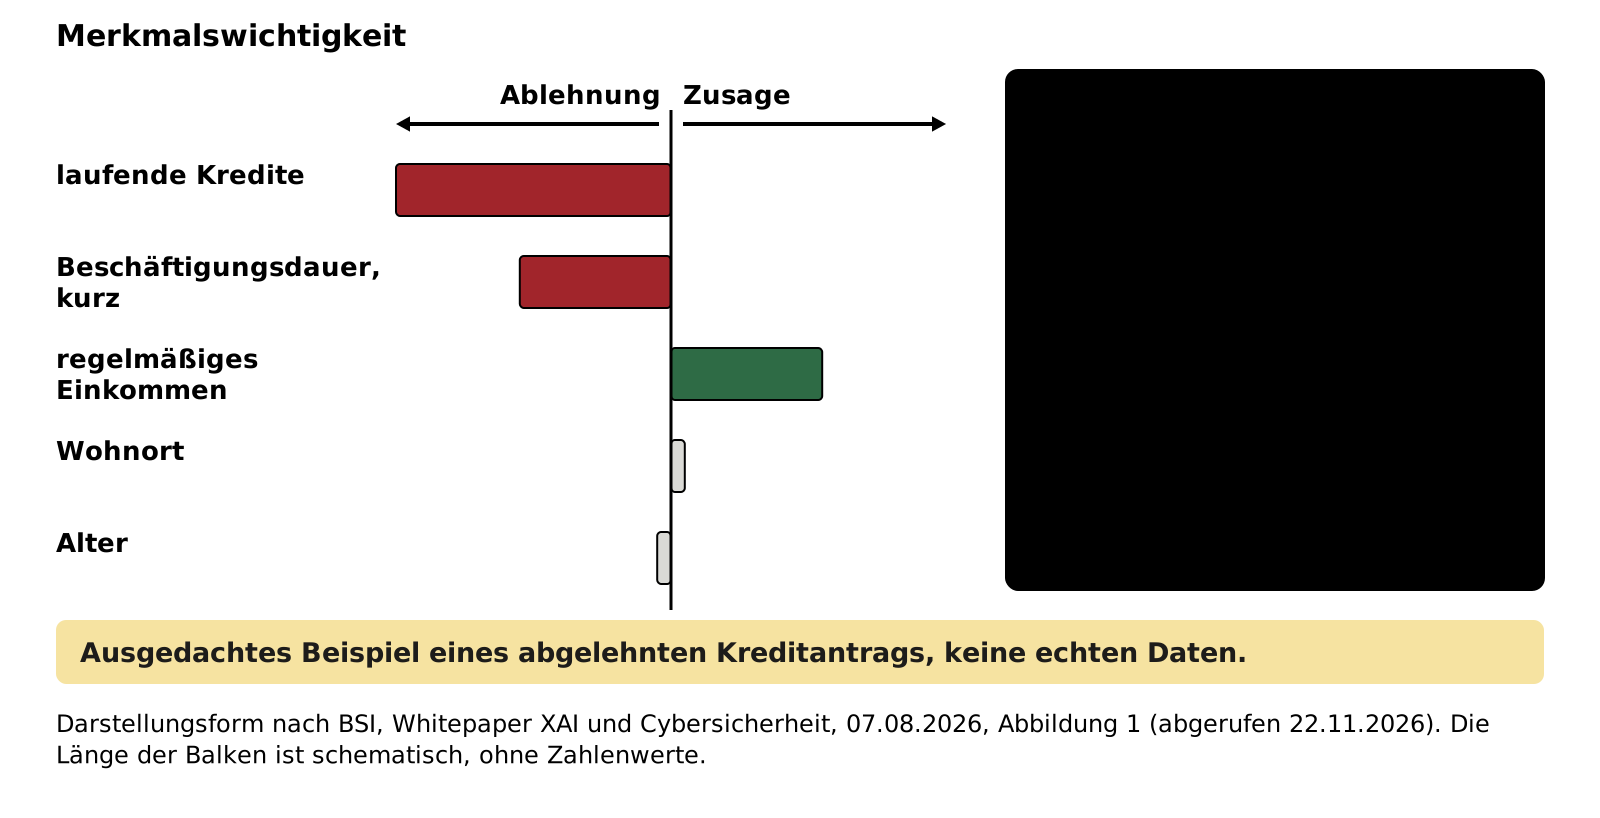
- Balken nach links spricht für Ablehnung
- Balken nach rechts spricht für Zusage
- Kasten kleinste Änderung mit anderem Ergebnis
Wie eine Erklärung aussieht, lässt sich an einem ausgedachten Fall zeigen, angenommen ein Modell hat einen Kreditantrag abgelehnt. Eine SHAP-Erklärung ordnet jedem Merkmal einen Balken zu. Die laufenden Kredite drücken das Ergebnis am stärksten in Richtung Ablehnung, die kurze Beschäftigungsdauer ebenfalls. Das regelmäßige Einkommen spricht für eine Zusage, reicht aber nicht aus. Wohnort und Alter haben in diesem Beispiel kaum Gewicht.
Eine kontrafaktische Erklärung formuliert dasselbe als Bedingung: Mit einem laufenden Kredit weniger, angenommen etwa 200 Euro geringerer monatlicher Belastung, wäre der Antrag bewilligt worden. Für die betroffene Person ist das oft verständlicher als eine Liste von Balken. Beide Erklärungen sagen etwas darüber, wie das Modell reagiert. Ob seine Gründe fair oder sachlich richtig sind, beantworten sie nicht. Fällt in der Erklärung etwa auf, dass der Wohnort viel Gewicht hat, kann das auf eine versteckte Benachteiligung hindeuten, und genau solchen Spuren geht man nach, wenn Diskriminierung durch KI vermutet wird.
Grenzen der Erklärungen
In einem Whitepaper vom November 2024 hat das BSI die Schwächen nachträglicher Erklärungen zusammengefasst2. Als erstes Problem nennt es das Uneinigkeitsproblem: Verschiedene Methoden berechnen für dieselbe Vorhersage unterschiedliche, teils widersprüchliche Erklärungen, und dieser Widerspruch lässt sich in der Regel nicht einfach auflösen2. Hinzu kommt die Gefahr der Manipulation. Viele Verfahren lassen sich so angreifen, dass die Erklärung den tatsächlichen Entscheidungsweg nicht mehr abbildet; Prüfstellen und Verbraucher könnten so über das wahre Verhalten eines Produkts getäuscht werden2. Das BSI folgert, dass nachträgliche Erklärungen derzeit keinen sicheren Einsatz in Bewertungsverfahren für KI-Produkte erlauben, und schlägt stattdessen etwa Prüfungen mit vollem Einblick in das Modell vor2.
Eine Studie aus dem Oktober 2018 hat Salienzkarten einem Plausibilitätstest unterzogen5. Einige Verfahren lieferten Karten, die gar nicht vom trainierten Modell oder von den Daten abhingen; die Autoren verglichen sie mit einer einfachen Kantenerkennung, die weder Modell noch Training braucht5. Solche Karten sehen überzeugend aus und erklären trotzdem nichts über das Modell.
Im August 2026 legte das BSI ein zweites Papier vor, diesmal zur Cybersicherheit1. Es beschreibt neben Chancen auch, wie Erklärungen Angreifern helfen. Wer viele Erklärungen eines Modells sammelt, kann dessen Entscheidungsgrenzen leichter nachbauen, ein sogenannter Modelldiebstahl braucht dann weniger Abfragen1. Kontrafaktische Verfahren lassen sich missbrauchen, um Schadsoftware gezielt so zu verändern, dass ein KI-gestützter Virenscanner sie nicht mehr erkennt1. Verwandt damit sind gezielt manipulierte Eingaben, sogenannte Adversarial Examples. Betriebe sollten Erklärungen deshalb nicht ungeprüft nach außen geben und sie in ihre KI-Sicherheit einbeziehen.
Was der AI Act verlangt
Die europäische KI-Verordnung schreibt kein bestimmtes Erklärverfahren vor, stellt aber Anforderungen an Transparenz und Aufsicht bei Hochrisiko-KI. Nach Artikel 13 Absatz 1 müssen Hochrisiko-Systeme so gebaut sein, dass ihr Betrieb hinreichend transparent ist, damit die Betreiber die Ausgaben angemessen interpretieren und verwenden können7. Die Betriebsanleitung muss unter anderem Merkmale, Fähigkeiten und Leistungsgrenzen des Systems nennen7. Artikel 14 Absatz 4 verlangt, dass die Menschen, die ein solches System beaufsichtigen, seine Ausgaben richtig interpretieren können, wobei vorhandene Interpretationswerkzeuge und Methoden zu berücksichtigen sind7.
Für Betroffene gibt es Artikel 86. Wer von einer Entscheidung betroffen ist, die ein Betreiber auf Grundlage eines Hochrisiko-Systems aus Anhang III getroffen hat, kann von ihm eine klare und aussagekräftige Erläuterung verlangen7. Voraussetzung ist, dass die Entscheidung rechtliche Wirkung hat oder die Person in ähnlicher Weise erheblich beeinträchtigt, nach ihrer Ansicht an Gesundheit, Sicherheit oder Grundrechten7. Sie soll die Rolle des KI-Systems im Entscheidungsprozess und die wichtigsten Elemente der Entscheidung umfassen7. Ausgenommen sind Systeme aus Nummer 2 des Anhangs7.
Die Anforderungen aus den Artikeln 13 und 14 hat der Digital-Omnibus zeitlich verschoben. Nach dem geänderten Artikel 113 gelten die Anforderungen an Hochrisiko-Systeme (Kapitel III Abschnitte 1 bis 3) ab dem 02.12.2027 für Systeme nach Anhang III und ab dem 02.08.2028 für Systeme nach Anhang I7. Ob ein System überhaupt hochriskant ist, ergibt sich aus den Risikoklassen des AI Act; weitere Termine enthält der Zeitplan des AI Act. Ob ein bestimmtes System darunter fällt, klärt im Zweifel eine Anwältin oder ein Anwalt.
Wann ein einfaches Modell die bessere Wahl ist
Aus den Grenzen der nachträglichen Erklärungen zieht die Informatikerin Cynthia Rudin eine klare Folgerung. In einem Aufsatz vom November 2018 rät sie, für folgenschwere Entscheidungen von vornherein Modelle zu bauen, die selbst verständlich sind, statt Black Boxes nachträglich zu erklären6. Das Erklären von Black Boxes könne schlechte Praktiken festigen und der Gesellschaft schaden6. Als Einsatzfelder nennt sie Strafjustiz, Medizin und Bilderkennung6.
Für Betriebe ergibt sich daraus eine einfache Prüffrage. Muss eine Entscheidung gegenüber Kunden, Bewerbern oder einer Behörde begründet werden, lohnt zuerst der Versuch mit einem von sich aus erklärbaren Modell, etwa einem Entscheidungsbaum. Bei Tabellendaten liegen solche Verfahren in der Genauigkeit oft nah an tiefen Netzen oder sogar vorn, wie ein Vergleich von Baumverfahren und Deep Learning zeigt. Erst wenn ein einfaches Modell die Aufgabe nicht löst, kommt ein neuronales Netz mit nachträglicher Erklärung in Frage, und dann mit dem Wissen, dass diese Erklärung eine Annäherung ist.
Was das für dich heißt
Eine Erklärung zeigt, worauf ein Modell reagiert hat, und ersetzt keine Prüfung, ob die Entscheidung richtig war.
- Frag bei folgenreichen KI-Entscheidungen nach den wichtigsten Gründen und nach der Rolle des Systems.
- Prüf im Betrieb zuerst, ob ein einfaches, lesbares Modell die Aufgabe löst.
- Vergleich bei wichtigen Fällen mehrere Erklärverfahren, statt einem einzigen zu trauen.
- Halte in der Dokumentation fest, welches Erklärverfahren ihr nutzt und wo seine Grenzen liegen.
Häufige Fragen
Was ist Explainable AI?
Explainable AI, deutsch erklärbare KI, bezeichnet Verfahren, die nachvollziehbar machen sollen, wie ein KI-Modell zu einem Ergebnis kommt. Dazu gehören von sich aus lesbare Modelle und nachträgliche Erklärungen für komplexe Netze.
Was ist der Unterschied zwischen SHAP und LIME?
Beide erklären einzelne Vorhersagen über die Wichtigkeit von Merkmalen. SHAP stützt sich auf Shapley-Werte aus der Spieltheorie, LIME baut um die Vorhersage herum ein einfaches Ersatzmodell, das das große Modell lokal nachahmt.
Kann man ChatGPT erklärbar machen?
Nur sehr eingeschränkt. Große Sprachmodelle können zwar eine Begründung formulieren, diese Begründung ist aber selbst erzeugter Text und muss nicht dem tatsächlichen Rechenweg entsprechen. In einem Test von Anthropic erwähnte Claude 3.7 Sonnet einen Hinweis, den es für seine Antwort genutzt hatte, nur in 25 Prozent der Fälle9.
Habe ich ein Recht auf Erklärung einer KI-Entscheidung?
Die KI-Verordnung gibt Betroffenen bei bestimmten Hochrisiko-Systemen ein Recht auf Erläuterung durch den Betreiber. Daneben können andere Gesetze, etwa der Datenschutz, eigene Auskunftsrechte vorsehen; im Einzelfall hilft eine Beratungsstelle oder eine Anwältin.
Quellen
Stand:
- Bundesamt für Sicherheit in der Informationstechnik: Erklärbare künstliche Intelligenz (XAI): Chancen und Risiken für die Cybersicherheit, Version 1.0, Stand 07.08.2026, abgerufen am 22.11.2026. zurück
- Bundesamt für Sicherheit in der Informationstechnik: Erklärbarkeit von KI im adversarialen Kontext, Stand 28.11.2024, abgerufen am 22.11.2026. zurück
- arXiv (Ribeiro, Singh, Guestrin): "Why Should I Trust You?": Explaining the Predictions of Any Classifier, Stand 16.02.2016, abgerufen am 22.11.2026. zurück
- arXiv (Lundberg, Lee): A Unified Approach to Interpreting Model Predictions, Stand 22.05.2017, abgerufen am 22.11.2026. zurück
- arXiv (Adebayo u. a.): Sanity Checks for Saliency Maps, Stand 08.10.2018, abgerufen am 22.11.2026. zurück
- arXiv (Rudin): Stop Explaining Black Box Machine Learning Models for High Stakes Decisions and Use Interpretable Models Instead, Stand 26.11.2018, abgerufen am 22.11.2026. zurück
- EUR-Lex: Verordnung (EU) 2024/1689 (KI-Verordnung), konsolidierte Fassung, Artikel 13, 14, 86 und 113, Stand 27.07.2026, abgerufen am 22.11.2026. zurück
- Plattform Lernende Systeme: Glossar: Erklärbarkeit, abgerufen am 22.11.2026. zurück
- Anthropic: Reasoning models don't always say what they think, Stand 03.04.2025, abgerufen am 22.11.2026. zurück