Lexikon · A
Adversarial Examples
Kurzantwort
Schon kaum sichtbare, gezielt berechnete Änderungen an einer Eingabe können ein KI-Modell zu einer falschen Erkennung bringen, während ein Mensch keinen Unterschied bemerkt; solche Eingaben heißen Adversarial Examples. Bekannt wurden sie 2013 durch eine Arbeit über Bildklassifikatoren1. Die KI-Verordnung zählt sie zu den Angriffen, gegen die Hochrisiko-Systeme gewappnet sein müssen4.
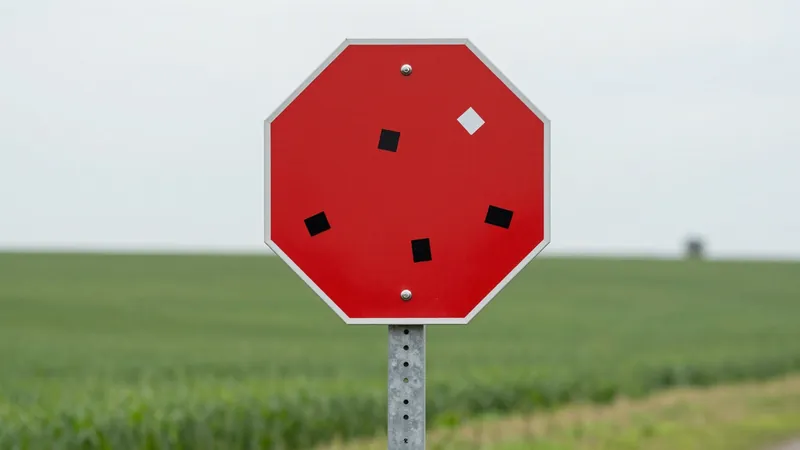
Ein paar schwarze und weiße Klebestreifen auf einem Stoppschild genügten 2017 einer Forschergruppe, um ein Programm zur Verkehrszeichenerkennung zu täuschen. Im Labor ordnete das Programm das präparierte Schild auf allen Aufnahmen falsch ein, bei Videobildern aus einem fahrenden Auto in 84,8 Prozent der Fälle3. Für Menschen blieb es ein gewöhnliches Stoppschild mit etwas Klebeband. Solche gezielt manipulierten Eingaben heißen Adversarial Examples, auf Deutsch etwa feindselige oder gegnerische Beispiele.
Wie die Täuschung entdeckt wurde
Christian Szegedy und sechs Mitautoren beschrieben das Phänomen Ende 2013. Sie fanden, dass eine winzige, für das Auge kaum wahrnehmbare Veränderung an einem Bild ein neuronales Netz zu einer falschen Einordnung bringen kann, wenn man die Veränderung gezielt so berechnet, dass der Fehler des Netzes möglichst groß wird1. Überraschend war ein zweiter Befund: Dieselbe Veränderung täuschte oft auch ein anderes Netz, das mit einem anderen Teil der Daten trainiert worden war, die Schwäche steckte also nicht nur in einem einzelnen Modell1.
Ein Jahr später lieferten Ian Goodfellow, Jonathon Shlens und Christian Szegedy eine Erklärung. Die Anfälligkeit komme vor allem daher, dass sich die Netze in hohem Maß linear verhalten, und daraus ergebe sich ein einfaches, schnelles Verfahren, solche Beispiele zu erzeugen2. Sie nutzten die erzeugten Beispiele auch im Training und senkten so die Fehlerrate eines Netzes auf einem Standarddatensatz handgeschriebener Ziffern2. Diesen Ansatz nennt man adversariales Training. Auch das BSI, die Cybersicherheitsbehörde des Bundes, hält ihn in seinem Grundlagenpapier zu Angriffen auf Deep Learning für die am besten umsetzbare Abwehr und rät dazu bei allen Modellen, die Eingaben von außen verarbeiten6. Als zweite Verteidigungslinie empfiehlt es Verfahren, die verdächtige Eingaben im Betrieb erkennen6.
Wo das zum Problem wird
Für die Bilderkennung im Fotoalbum ist eine falsch erkannte Katze ärgerlich, aber folgenlos. Ernst wird es, wo eine Erkennung über Sicherheit, Zugang oder Geld entscheidet: beim Erkennen von Verkehrszeichen, bei der Gesichtserkennung an einer Tür, bei der Prüfung von Ausweisen. Das Stoppschild-Experiment hat gezeigt, dass solche Angriffe auch außerhalb des Rechners unter wechselndem Blickwinkel funktionieren können3.
Die KI-Verordnung nennt das Problem ausdrücklich. Hochrisiko-KI-Systeme müssen widerstandsfähig gegen Versuche Unbefugter sein, Schwachstellen auszunutzen, und die technischen Lösungen sollen unter anderem Eingabedaten abwehren, die das Modell zu Fehlern verleiten sollen; der Text nennt dafür die englischen Begriffe "adversarial examples" und "model evasions"4.
Verwandte Angriffe auf Sprachmodelle
Bei Sprachmodellen spricht das BSI allgemein von Evasion-Attacks, also Angriffen, die das Modell während des Betriebs manipulieren. Je nach Zusammenhang heißen sie auch Prompt Injection, Jailbreak oder adversarialer Angriff5. Das Prinzip ist verwandt: Eine gezielt gebaute Eingabe nutzt aus, dass das Modell anders entscheidet als ein Mensch.
Häufige Fragen
Lassen sich Adversarial Examples vollständig verhindern?
Bisher nicht. Adversariales Training und andere Verfahren machen Modelle robuster, doch das BSI weist darauf hin, dass manche Abwehr durch neuere Angriffe wieder gebrochen wird6. Wo viel auf dem Spiel steht, gehören deshalb weitere Prüfungen dazu, zum Beispiel ein zweiter Sensor oder ein Mensch, der Grenzfälle bestätigt.
Gibt es Adversarial Examples nur bei Bildern?
Nein. Das Prinzip gilt für alle Arten von Eingaben, die ein Modell auswertet, auch für Ton und Text. Das BSI behandelt Prompt Injections und Jailbreaks bei Sprachmodellen als Spielarten derselben Angriffsklasse5.
Quellen
Stand:
- Szegedy, Zaremba, Sutskever, Bruna, Erhan, Goodfellow, Fergus (arXiv): Intriguing properties of neural networks, Stand 19.02.2014, abgerufen am 22.11.2026. zurück
- Goodfellow, Shlens, Szegedy (arXiv): Explaining and Harnessing Adversarial Examples, Stand 20.03.2015, abgerufen am 22.11.2026. zurück
- Eykholt und andere (arXiv): Robust Physical-World Attacks on Deep Learning Models, Stand 10.04.2018, abgerufen am 22.11.2026. zurück
- EUR-Lex: Verordnung (EU) 2024/1689 (KI-Verordnung), konsolidierte Fassung vom 27.07.2026, Artikel 15 Absatz 5, Stand 27.07.2026, abgerufen am 22.11.2026. zurück
- Bundesamt für Sicherheit in der Informationstechnik (BSI): Evasion-Attacks auf LLMs: Gegenmaßnahmen in der Praxis, Version 1.0, Stand 15.01.2026, abgerufen am 22.11.2026. zurück
- Bundesamt für Sicherheit in der Informationstechnik (BSI): Security of AI-Systems: Fundamentals, Adversarial Deep Learning, Version 0.9, Stand 14.06.2022, abgerufen am 22.11.2026. zurück