Grundlagen
Maschinelles Lernen oder Deep Learning
Kurzantwort
Maschinelles Lernen ist der Teil der KI, in dem Programme aus Beispieldaten Modelle ableiten, statt jeden Schritt vorgegeben zu bekommen1. Deep Learning ist eine Methode davon, die mit mehrschichtigen neuronalen Netzen arbeitet und so auch aus Bildern, Sprache und Text abstrakte Muster lernt1. Bei Tabellen mittlerer Größe liegen klassische Verfahren wie Entscheidungsbäume oft vorn3.

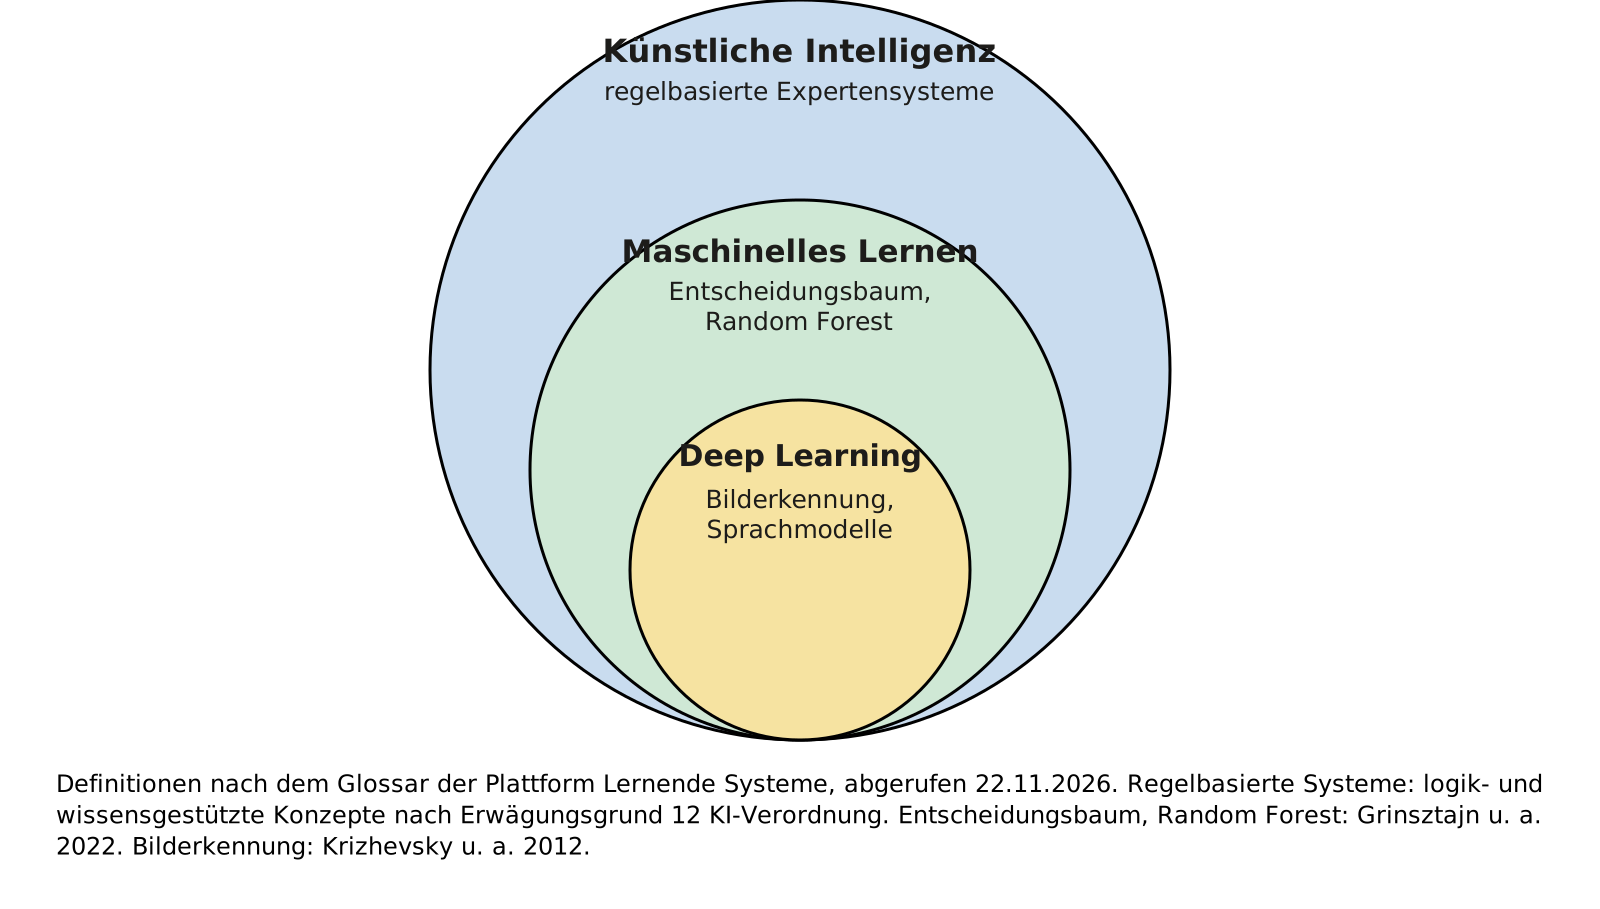
Machine Learning und Deep Learning stecken ineinander wie die Ringe einer Zielscheibe. Deep Learning ist eine bestimmte Art, maschinell zu lernen, und maschinelles Lernen ist eine von mehreren Methoden der künstlichen Intelligenz1. Der praktische Unterschied liegt darin, wer die Merkmale festlegt, auf die ein Modell achtet. Beim klassischen maschinellen Lernen bereiten meist Menschen sie vor, beim Deep Learning findet ein mehrschichtiges neuronales Netz sie selbst in den Rohdaten. Das macht Deep Learning stark bei Bildern, Sprache und Text und oft unnötig aufwendig bei Tabellen.
Drei Kreise ineinander
- Künstliche Intelligenz Oberbegriff, auch regelbasiert
- Maschinelles Lernen lernt aus Beispieldaten
- Deep Learning mehrschichtige neuronale Netze
Am leichtesten merkt man sich das Verhältnis als drei Kreise. Der äußere ist die künstliche Intelligenz. Eine allgemein anerkannte Definition dafür gibt es nicht; die Plattform Lernende Systeme beschreibt KI als Teilgebiet der Informatik, das Fähigkeiten wie Lernen oder Problemlösen mit Algorithmen in Computern umsetzen will1. Zur KI gehören auch Ansätze, die gar nicht lernen. Die europäische KI-Verordnung nennt in ihrem Erwägungsgrund 12 neben dem maschinellen Lernen ausdrücklich logik- und wissensgestützte Konzepte, die aus kodierten Informationen oder symbolischen Darstellungen ableiten4. Ein klassisches Expertensystem mit Hunderten von Regeln, die Fachleute aufgeschrieben haben, wäre so ein Fall.
Im mittleren Kreis liegt das maschinelle Lernen. Die Plattform Lernende Systeme nennt es eine grundlegende Methode der KI: Aus Beispieldaten werden Modelle abgeleitet, die sich auf neue, unbekannte Daten anwenden lassen, ohne dass jeder Lösungsschritt programmiert wird1. Der innere Kreis ist Deep Learning, laut derselben Quelle eine Methode des maschinellen Lernens in künstlichen neuronalen Netzen mit mehreren Schichten, die abstraktere Muster erfassen können1.
Wer also "KI oder Machine Learning" fragt, vergleicht ein Ganzes mit einem Teil. Jedes Deep-Learning-System ist maschinelles Lernen und jedes maschinelle Lernen KI, umgekehrt gilt das nicht.
Was klassisches maschinelles Lernen ausmacht
Ein klassisches Lernverfahren bekommt Daten in Tabellenform: eine Zeile je Fall, eine Spalte je Merkmal. Ein Online-Händler, der Rücksendungen vorhersagen will, hätte etwa Spalten für Warengruppe, Preis, Größe, Zahl früherer Rücksendungen und Zahlungsart. Beim überwachten Lernen kommt eine Spalte mit dem bekannten Ergebnis dazu, also ob die Ware zurückkam. Das Verfahren sucht dann die Regeln, nach denen Merkmale und Ergebnis zusammenhängen.
Bekannte Verfahren dieser Art sind Entscheidungsbäume und ihre Weiterentwicklungen wie Random Forests oder XGBoost3. Ein Entscheidungsbaum fragt der Reihe nach Merkmale ab, etwa "Preis über einer Schwelle?" und dann "Kleidung oder Technik?", bis er bei einer Vorhersage landet. Viele solcher Bäume zusammen ergeben einen Random Forest. Andere Verfahren ziehen eine Trennlinie durch die Daten.
Neben dem überwachten Lernen gibt es zwei weitere Grundformen. Beim unüberwachten Lernen fehlt die Spalte mit dem Ergebnis; das Verfahren sucht selbst nach Gruppen, etwa nach Kunden mit ähnlichem Kaufverhalten. Beim bestärkenden Lernen probiert ein Programm Handlungen aus und erhält dafür Belohnungen oder Abzüge. So trainierte zum Beispiel AlphaGo in Partien gegen eigene Versionen6. Alle drei Grundformen gibt es mit klassischen Verfahren und mit tiefen Netzen, die Einteilung liegt also quer zur Frage "klassisch oder Deep Learning".
Beim klassischen Lernen leisten Menschen die wichtigste Vorarbeit. Sie wählen aus, welche Merkmale in die Tabelle kommen, rechnen aus Rohdaten sinnvolle Größen, etwa die Rücksendequote der letzten zwölf Monate, und entfernen, was nur Rauschen ist. Diese Arbeit heißt Feature Engineering. Sie verlangt Wissen über das Fachgebiet und beeinflusst die Qualität des Ergebnisses stark. Grundlage bleiben gute Daten, denn schlechte Datenqualität gleicht auch das beste Verfahren kaum aus.
Was Deep Learning anders macht
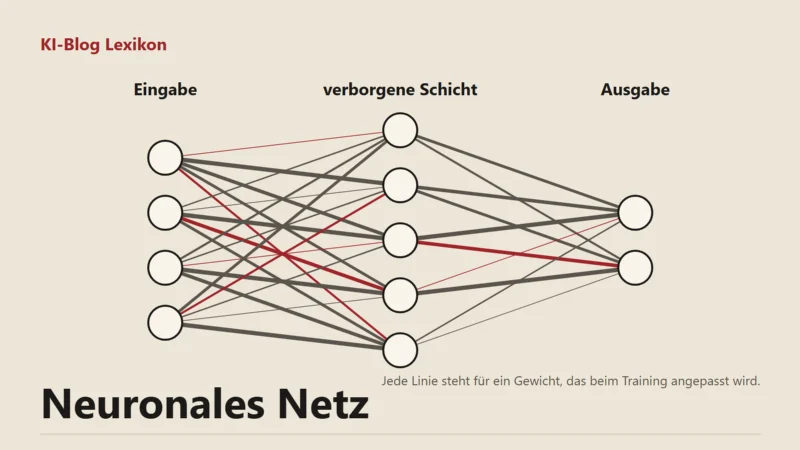
Bei Bildern, Tonaufnahmen oder freiem Text funktioniert dieses Vorgehen schlecht. Welche Spalten sollte man für ein Foto anlegen, damit ein Programm darauf eine Katze erkennt? Deep Learning umgeht die Frage. Ein neuronales Netz mit vielen Schichten bekommt die Rohdaten, also die Bildpunkte, und lernt selbst, welche Merkmale nützlich sind. Die ersten Schichten reagieren auf einfache Muster wie Kanten, spätere auf Formen, noch spätere auf ganze Gegenstände. Genau diese Fähigkeit meint die Plattform Lernende Systeme, wenn sie schreibt, die Komplexität der Netze ermögliche abstraktere Muster1.
Die Idee ist älter, als der Begriff vermuten lässt: Schon 1958 führte die US-Marine das Perzeptron von Frank Rosenblatt vor, ein einschichtiges neuronales Netz5. Wie es danach weiterging, erzählt die Geschichte der KI. Was fehlte, waren Daten und Rechenleistung in der nötigen Größenordnung.
Den Durchbruch zeigte 2012 ein Netz von Alex Krizhevsky, Ilya Sutskever und Geoffrey Hinton, das Objekte auf Bildern erkannte und nach Angaben der Autoren deutlich vor den bisherigen Verfahren lag2. Trainiert wurde es auf Grafikprozessoren2. Seitdem gilt als Regel: Deep Learning braucht viele Daten und viel Rechenleistung und liefert dafür bei Bildern, Sprache und Text meist die besseren Ergebnisse.
Heute steckt Deep Learning in fast allem, was im Alltag als KI wahrgenommen wird: in der Gesichtserkennung der Fotogalerie, in Spracherkennung und Übersetzung, in Bildgeneratoren und in Sprachmodellen wie ChatGPT, die ihre Antworten mit einem tiefen Netz Stück für Stück berechnen.
Ein Beispiel, zwei Wege
Wie verschieden die Ansätze arbeiten, zeigt eine Aufgabe aus der Fertigung: Ein Betrieb will fehlerhafte Bauteile am Band aussortieren.
Auf dem klassischen Weg messen Sensoren Länge, Gewicht, Temperatur und Oberflächenrauheit jedes Teils. Fachleute wissen aus Erfahrung, welche Werte auf Fehler hindeuten, und legen die Messgrößen als Merkmale fest. Ein Entscheidungsbaum lernt aus einigen Tausend geprüften Teilen, wo die Grenzen liegen. Das Ergebnis lässt sich nachvollziehen: Der Baum zeigt, dass etwa ein bestimmtes Gewicht zusammen mit hoher Temperatur ein Warnzeichen ist.
Auf dem Weg mit Deep Learning fotografiert eine Kamera jedes Teil. Ein neuronales Netz lernt aus vielen Bildern guter und schlechter Teile, Risse, Kratzer oder Verformungen zu erkennen, auch solche, für die niemand eine Messgröße definiert hat. Dafür braucht es deutlich mehr Beispielbilder, eine Grafikkarte für das Training und meist eine Nachkontrolle, warum das Netz ein Teil aussortiert hat. Verfahren der erklärbaren KI machen solche Entscheidungen zumindest teilweise nachvollziehbar.
Beide Wege können in der Praxis nebeneinander laufen: Messwerte für die bekannten Fehler, Kamerabilder für die unbekannten.
Wann was eingesetzt wird
Die wichtigste Frage ist die nach der Form der Daten. Für Tabellen mittlerer Größe gibt es eine aufschlussreiche Studie von Léo Grinsztajn, Edouard Oyallon und Gaël Varoquaux aus dem Juli 2022. Sie verglichen klassische Baumverfahren mit verschiedenen Deep-Learning-Ansätzen auf 45 Datensätzen und kamen zu dem Schluss, dass baumbasierte Modelle bei Daten mittlerer Größe, rund 10.000 Fällen, Stand der Technik bleiben, schon ohne ihren Geschwindigkeitsvorteil3. Als Gründe nennen sie unter anderem, dass neuronale Netze schlechter mit unwichtigen Merkmalen umgehen und unregelmäßige Zusammenhänge schwerer lernen3.
| Kriterium | Klassisches maschinelles Lernen | Deep Learning |
|---|---|---|
| Typische Daten | Tabellen mit festen Spalten | Bilder, Ton, Text, Video |
| Merkmale | von Menschen ausgewählt und aufbereitet | vom Netz selbst gelernt |
| Datenmenge | kommt mit weniger Beispielen aus | braucht meist sehr viele Beispiele |
| Rechenaufwand | läuft oft auf einem normalen Rechner | Training meist auf Grafikkarten |
| Nachvollziehbarkeit | bei einfachen Modellen gut | schwierig, braucht eigene Verfahren |
| Beispiele | Kreditprüfung, Absatzprognose, Betrugserkennung in Zahlungsdaten | Bilderkennung, Spracherkennung, Sprachmodelle |
Daraus ergibt sich eine einfache Faustregel. Liegen deine Daten als Tabelle vor und sind es Tausende oder Zehntausende Fälle, probier zuerst ein Baumverfahren; es ist schneller trainiert, braucht keine Grafikkarte und lässt sich leichter erklären. Geht es um Fotos, Sprache oder Texte, führt an Deep Learning kaum ein Weg vorbei, wobei du heute selten selbst trainierst: Meist nutzt du ein vortrainiertes Modell und passt es an. Fürs eigene Training braucht es eine passende Grafikkarte für lokale KI mit ausreichend Speicher.
Beide Ansätze zählen zur schwachen KI, weil sie jeweils eng umrissene Aufgaben lösen. Ein Baumverfahren, das Kreditanträge bewertet, kann keine Fotos sortieren, und ein Netz für Bilderkennung erstellt keine Absatzprognose.
Was das für dich heißt
Welcher Ansatz passt, entscheidet vor allem die Form deiner Daten.
- Prüf zuerst, ob deine Daten als Tabelle vorliegen oder als Bilder, Ton und Text.
- Probier bei Tabellen ein Baumverfahren aus, bevor du ein neuronales Netz trainierst.
- Nutz für Bilder und Sprache vortrainierte Modelle, statt bei null anzufangen.
- Plan Zeit für saubere Daten ein, sie entscheiden bei beiden Ansätzen über das Ergebnis.
Häufige Fragen
Ist Deep Learning besser als Machine Learning?
Es kommt auf die Daten an. Bei Bildern, Sprache und Text liefert Deep Learning meist die besseren Ergebnisse, bei Tabellen mittlerer Größe sind klassische Verfahren wie Entscheidungsbäume oft gleich gut oder besser und dazu schneller.
Was ist der Unterschied zwischen KI und Machine Learning?
KI ist der Oberbegriff für Systeme, die Aufgaben wie Lernen oder Problemlösen übernehmen. Machine Learning ist eine Methode darunter, bei der Programme aus Beispieldaten lernen; es gibt auch regelbasierte KI ohne Lernen.
Ist ChatGPT maschinelles Lernen oder Deep Learning?
Beides. ChatGPT beruht auf einem großen neuronalen Netz mit vielen Schichten, ist also Deep Learning und damit zugleich eine Form des maschinellen Lernens.
Brauche ich für Machine Learning eine Grafikkarte?
Für klassische Verfahren auf Tabellendaten reicht in der Regel ein normaler Rechner. Eine Grafikkarte lohnt sich vor allem, wenn du neuronale Netze trainierst oder große Modelle lokal ausführst.
Quellen
Stand:
- Plattform Lernende Systeme: Glossar: Maschinelles Lernen, Deep Learning, Künstliche Intelligenz, abgerufen am 22.11.2026. zurück
- NeurIPS Proceedings: Krizhevsky, Sutskever, Hinton: ImageNet Classification with Deep Convolutional Neural Networks, Stand 2012, abgerufen am 22.11.2026. zurück
- arXiv (Grinsztajn, Oyallon, Varoquaux): Why do tree-based models still outperform deep learning on tabular data?, Stand 18.07.2022, abgerufen am 22.11.2026. zurück
- EUR-Lex: Verordnung (EU) 2024/1689 (KI-Verordnung), Erwägungsgrund 12, Stand 12.07.2024, abgerufen am 22.11.2026. zurück
- Cornell Chronicle: Professor's perceptron paved the way for AI, 60 years too soon, Stand 25.09.2019, abgerufen am 22.11.2026. zurück
- Google DeepMind: AlphaGo, abgerufen am 22.11.2026. zurück