Unternehmen
Schutz vor Prompt Injection
Kurzantwort
Bei einer Prompt Injection bringen Angreifer ein Sprachmodell mit eigenen Anweisungen dazu, seine Regeln zu brechen, entweder direkt im Chat oder versteckt in Dokumenten, Webseiten und Mails, die das Modell verarbeitet3. Das BSI hält das Problem für nicht abschließend lösbar und empfiehlt fünf Basismaßnahmen von der Eingabebereinigung bis zum Filter für ausgehende Links1. Wo die KI selbst handeln darf, gehören knappe Rechte und menschliche Bestätigung dazu.
Ein Gedankenbeispiel: Eine Personalabteilung lässt eingehende Bewerbungen von einem Sprachmodell vorsortieren. In einem Lebenslauf steht, in weißer Schrift auf weißem Grund, ein Satz, der das Modell auffordert, diesen Bewerber als besonders geeignet einzustufen. Kein Mensch sieht ihn, das Modell liest ihn mit. Weiße Schrift auf weißem Grund nennt das BSI als Versteck1. OWASP führt Lebensläufe mit eingeschleusten Anweisungen als Beispiel für Prompt Injection, bis hin zu Anweisungen, die über mehrere Stellen verteilt sind und erst zusammen wirken3. Diese Art Angriff heißt Prompt Injection.
Direkte Angriffe: wenn der Nutzer selbst angreift
Bei der direkten Form tippt der Angreifer seine Anweisung selbst in den Chat. Angreifer und Nutzer sind dieselbe Person1. Das klassische Beispiel aus der OWASP-Liste: Jemand fordert einen Kundenchatbot auf, seine Regeln zu ignorieren, private Daten abzufragen und Mails zu verschicken3. Verwandt damit ist der Jailbreak, bei dem jemand die Schutzregeln des Modells selbst aushebeln will.
Direkte Angriffe sind oft gut getarnt. OWASP nennt angehängte Zeichenfolgen ohne erkennbaren Sinn, die Sicherheitsregeln umgehen, sowie Anweisungen in mehreren Sprachen oder in Kodierungen wie Base64, die an Filtern vorbeischlüpfen3. Für einen Chatbot auf der Website heißt das: Jeder Besucher kann ausprobieren, ob sich der Bot zu Rabatten, Beleidigungen oder der Herausgabe seiner Systemanweisung überreden lässt. Solange der Bot nur Text ausgibt, bleibt der Schaden meist peinlich. Gefährlich wird es, sobald er Werkzeuge bedienen kann.
Indirekte Angriffe: wenn das Dokument angreift
Bei der indirekten Form sind die Rollen getrennt. Die schädliche Anweisung steckt in einer externen Quelle, die das Modell verarbeitet, etwa in einem Dokument oder einer Webseite, und der Nutzer gibt sie unwissentlich weiter1. Beschrieben wurde diese Form zuerst von Greshake und Kollegen im Jahr 20231.
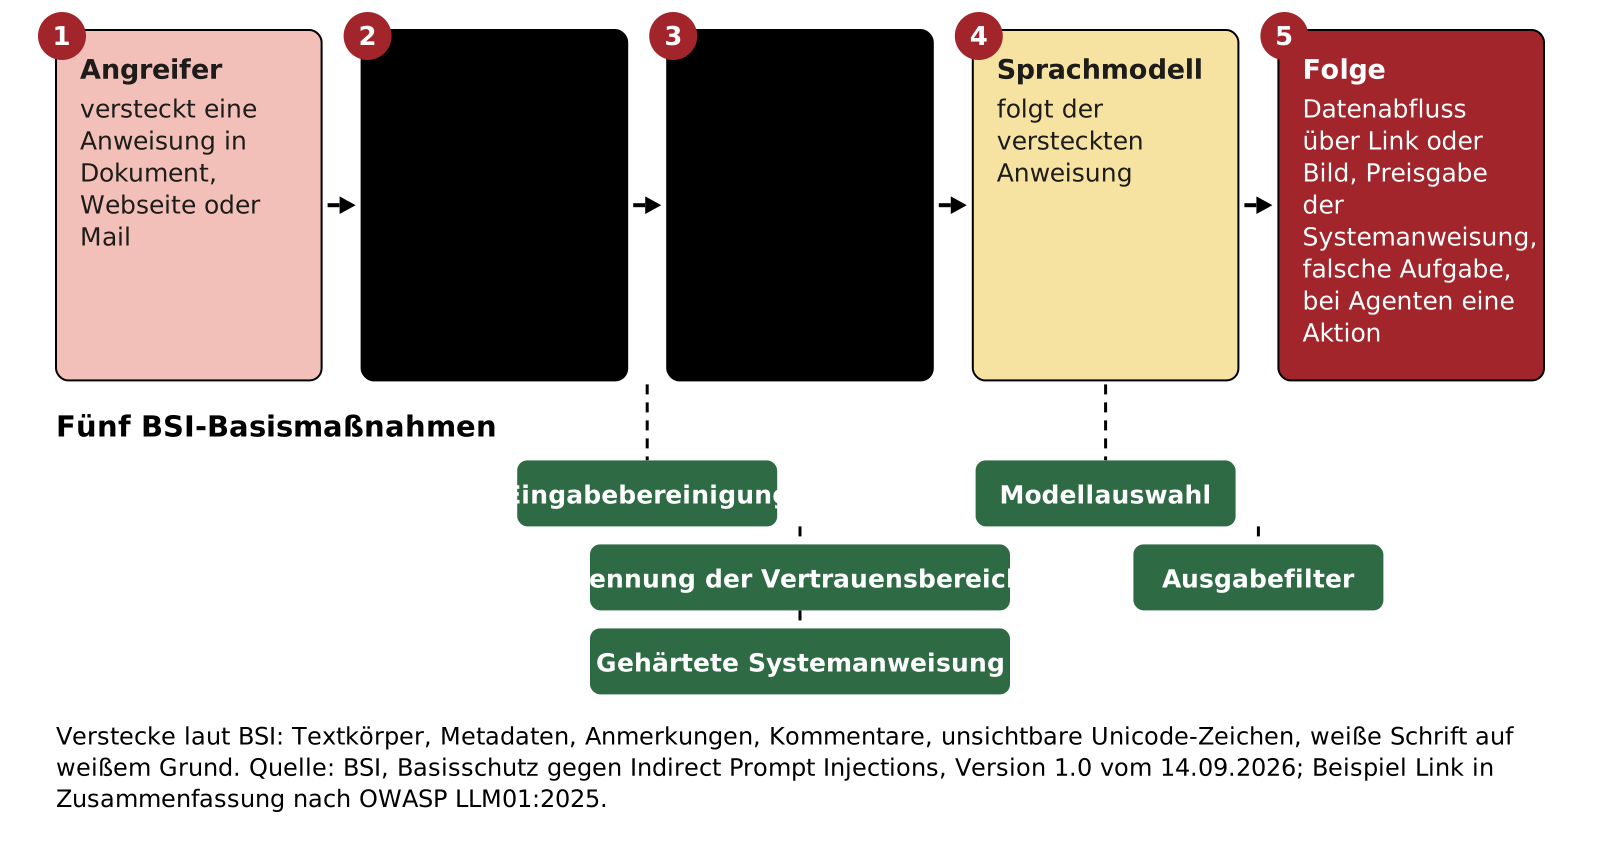
- Station Weg des Angriffs
- Maßnahme Basisschutz nach BSI
Beispiele aus der OWASP-Liste3:
- Ein Nutzer lässt eine Webseite zusammenfassen. Versteckte Anweisungen auf der Seite bringen das Modell dazu, einen Link in die Antwort einzubauen, über den der bisherige Gesprächsverlauf an den Angreifer abfließt.
- In einer Dokumentenablage, aus der ein RAG-System antwortet, liegt ein präpariertes Dokument und lenkt die Antworten.
- Eine Anweisung ist in einem Bild versteckt, das neben harmlosem Text hochgeladen wird.
Nicht jede Injection ist ein gezielter Angriff. OWASP beschreibt auch einen unbeabsichtigten Fall: Ein Unternehmen versteckt in einer Stellenanzeige eine Anweisung, um KI-geschriebene Bewerbungen zu erkennen. Ein Bewerber lässt seinen Lebenslauf mit einem Sprachmodell auf die Anzeige zuschneiden, das Modell liest die versteckte Anweisung mit und befolgt sie3.
Das BSI hat für seinen Basisschutz mehrere Chat-Anwendungen untersucht, in die Nutzer Dokumente hochladen. Als Versteck dient danach alles, was beim Einlesen ausgelesen wird, vom sichtbaren Text über Metadaten, Anmerkungen und Kommentare bis zu unsichtbaren Unicode-Zeichen oder weißer Schrift auf weißem Hintergrund1. Typische Folgen erfolgreicher Angriffe sind Datenabflüsse, die Preisgabe der Systemanweisung oder falsch erledigte Aufgaben1. Als zentrale Schwäche fand das BSI, dass viele Anwendungen den Dokumentinhalt ungefiltert in die Anfrage übernehmen, ohne ihn von der Nutzeranfrage zu trennen1.
Richtig teuer wird die indirekte Form bei Systemen, die handeln dürfen. Das BSI nennt agentische Systeme, in denen Sprachmodelle an Werkzeuge, Schnittstellen oder Abläufe gekoppelt sind, als besonders kritisch, weil ihre Ausgaben direkt Aktionen auslösen5. OWASP schildert den Fall eines Assistenten mit Zugriff auf ein Postfach: Eine präparierte Mail bringt ihn dazu, vertrauliche Nachrichten zu suchen und an den Angreifer weiterzuleiten6.
Warum Filter allein nicht reichen
Ein Sprachmodell kann von sich aus nicht unterscheiden, was Anweisung des Nutzers, Systemanweisung, eingeschleuste Anweisung oder bloßer Inhalt ist. Für das Modell ist alles eine Kette von Token1. Das BSI wies schon 2023 darauf hin, dass es keine zuverlässige Gegenmaßnahme gibt, die das Problem vollständig beseitigt, und verweist auf Forschung, nach der sich selbst gezielt entwickelte Abwehrmaßnahmen durch angepasste Angriffe umgehen lassen1. In der OWASP-Liste für 2026 steht Prompt Injection weiter auf Platz eins4.
Ein Filter, der nach Mustern wie "Ignoriere alle vorherigen Anweisungen" sucht, fängt genau diese Formulierung ab. Umschreiben, Übersetzen oder Kodieren genügt, um ihn zu umgehen, und harmlose Texte mit ähnlichen Wörtern lösen Fehlalarme aus. Das BSI beschreibt das auch für seine eigene Eingabebereinigung: Sie arbeitet auf der Ebene einzelner Zeichen, und Angriffe, die mit sauberem, unauffälligem Text argumentieren, kommen unverändert durch1. Filter sind also eine sinnvolle Schicht unter mehreren, und erst zusammen mit den anderen Maßnahmen ergeben sie einen Grundschutz. Das BSI empfiehlt ausdrücklich, alle fünf Basismaßnahmen anzuwenden, weil eine fehlende Maßnahme Angriffe öffnet, die die anderen nicht abdecken1.
Die fünf Basismaßnahmen des BSI
Das Papier "Basisschutz gegen Indirect Prompt Injections in dokumentbasierten LLM-Chats" erschien in Version 1.0 mit Datum 14.09.20261; die Downloadseite des BSI trägt das Datum 24.09.2026 und verweist auf ein frei nutzbares Testlabor auf GitHub2. Die Maßnahmen setzen an verschiedenen Stellen der Verarbeitung an1:
- Eingabe bereinigen: Bevor Text aus einem Dokument an das Modell geht, wird er vereinheitlicht. Unsichtbare Zeichen, Steuerzeichen für die Schreibrichtung und ungewöhnliche Leerzeichen fliegen raus, ähnlich aussehende Zeichen aus anderen Alphabeten werden auf lateinische zurückgeführt, gefälschte Rollenmarkierungen und Tags werden entwertet, und jeder Bereich wird in der Länge begrenzt.
- Vertrauensbereiche trennen: Dokumentinhalte werden in eindeutig markierte Blöcke gepackt, die das Modell als nicht vertrauenswürdig erkennt. Eine bei jeder Anfrage neu erzeugte Zufallskennung verhindert, dass ein Angreifer den Block im Dokument einfach schließt. Vor und nach dem Block und am Ende der Nutzeranfrage steht eine Erinnerung, dass der Inhalt nur Daten sind.
- Systemanweisung härten: Die Systemanweisung legt eine unveränderliche Rolle fest, ordnet Systemanweisung, Nutzeranfrage und Dokumentinhalt nach Vorrang, verbietet unter anderem das Ausgeben von Links zum Datenabfluss und enthält ein geheimes Kontrollwort, das nie in einer Antwort auftauchen darf.
- Modell bewusst auswählen: Ein gegen Angriffe trainiertes Modell und ein vorgeschalteter Denkschritt erkennen sprachlich getarnte Angriffe eher. Das BSI hält das für einen der wirksamsten Hebel, warnt aber, dass auch das keinen vollständigen Schutz bietet und der Denkschritt selbst zum Angriffsweg werden kann.
- Ausgaben filtern: Vor der Auslieferung prüft ein Filter, ob das Kontrollwort oder Teile der Systemanweisung in der Antwort stehen, ob typische Zeichen eines gelungenen Angriffs auftauchen und ob Bilder oder Links auf nicht freigegebene Adressen zeigen. Im Zweifel wird gesperrt; empfohlen ist eine Liste erlaubter Adressen.
Den Ausgabefilter begründet das BSI mit einem unauffälligen Weg: Ein in die Antwort eingebautes Bild, das von einem fremden Server geladen wird, kann Daten abfließen lassen, ohne dass der Nutzer etwas anklickt1.
Was über den Basisschutz hinaus hilft
Das BSI versteht seine Maßnahmen als Fundament für Chat-Anwendungen mit hochgeladenen Dokumenten1. Für Anwendungen, die mehr dürfen, nennt OWASP weitere Maßnahmen3:
- erwartete Ausgabeformate festlegen und mit gewöhnlichem Programmcode prüfen,
- dem Modell nur die nötigsten Rechte geben und berechtigte Funktionen im Programm abwickeln statt über das Modell,
- für folgenreiche Aktionen die Zustimmung eines Menschen verlangen,
- fremde Inhalte getrennt halten und deutlich kennzeichnen,
- die Anwendung regelmäßig gezielt angreifen und das Modell dabei wie einen nicht vertrauenswürdigen Nutzer behandeln.
Auch das BSI empfiehlt für die Entwicklung hin zu KI-Agenten dringend, sicherheitskritische Aktionen von Menschen bestätigen zu lassen und laufend zu protokollieren1. Vor jeder Technik steht deshalb die Prüfung, ob der Assistent diese Berechtigung überhaupt braucht. Ein Entwurf, den ein Mensch abschickt, verhindert, dass der Assistent von sich aus Nachrichten weiterleitet. Bei Agenten lassen sich die Rechte dafür in Stufen vergeben, vom reinen Lesen bis zur Aktion mit Freigabe; dazu kommen die üblichen Regeln, um KI sicher einzusetzen.
So prüfst du deine eigene Anwendung
Das BSI betont, dass seine Maßnahmen weder ein auf die Anwendung zugeschnittenes Red Teaming noch eine eigene Sicherheitsbewertung ersetzen1. Für kleine Betriebe ist ein vollständiges Red Teaming oft zu groß, ein Grundtest geht aber immer:
- Leg eine Handvoll Testdokumente an, die versteckte Anweisungen enthalten: in weißer Schrift, in den Dokumenteigenschaften, in einem Kommentar.
- Lade sie in deinen Chatbot oder lass deinen Ablauf sie verarbeiten, und frag nach einer Zusammenfassung.
- Prüfe, ob das Modell der versteckten Anweisung folgt, die Systemanweisung preisgibt oder Links und Bilder auf fremde Adressen ausgibt.
- Wiederhole den Test nach jedem Wechsel des Modells oder der Systemanweisung.
Leg die Prüfungen als festen Testsatz an, wie es auch für das Testen von Prompts üblich ist, dann lassen sie sich nach jeder Änderung wiederholen. Im Testlabor des BSI auf GitHub findet sich laut Papier außerdem ein Skill für Agenten, der dokumentbasierte Chats daraufhin prüft, ob die fünf Basismaßnahmen umgesetzt sind1.
Was das für dich heißt
Je mehr deine KI-Anwendung selbst tun darf, desto wichtiger werden Rechte und Freigaben gegenüber Filtern.
- Prüf, ob deine Anwendung hochgeladene Dokumente ungefiltert in die Anfrage übernimmt.
- Lass Links und Bilder in Antworten nur auf eine Liste erlaubter Adressen zeigen.
- Gib Chatbots und Agenten kein Recht, das du bei einem Missbrauch nicht verkraften würdest.
- Teste mit drei präparierten Dokumenten, bevor die Anwendung live geht, und nach jedem Modellwechsel.
Häufige Fragen
Was ist der Unterschied zwischen direkter und indirekter Prompt Injection?
Bei der direkten Form gibt der Angreifer seine Anweisung selbst in den Chat ein. Bei der indirekten steckt sie in einer Quelle, die das Modell verarbeitet, etwa in einem hochgeladenen Dokument, einer Webseite oder einer Mail, und der Nutzer bemerkt sie nicht.
Hilft es, die Systemanweisung geheim zu halten?
Kaum. Systemanweisungen lassen sich oft herauslocken, deshalb darf die Sicherheit nicht an ihrer Geheimhaltung hängen. Das BSI nutzt die Systemanweisung zwar als Schutzschicht, kombiniert sie aber mit Filtern vor und nach dem Modell.
Ist ein einfacher Website-Chatbot betroffen?
Ja, in geringerem Maß. Solange er nur Text ausgibt und keine Werkzeuge bedient, kann ein Angreifer ihn höchstens zu unerwünschten Aussagen bringen. Kritisch wird es, wenn er Links ausgibt, Daten abfragt oder Aktionen auslöst.
Gibt es eine Software, die Prompt Injection zuverlässig erkennt?
Nein. Erkennungsfilter fangen bekannte Muster ab, lassen sich aber durch Umformulieren umgehen. Wirksam ist erst die Kombination aus mehreren Schichten und knappen Rechten für alles, was das Modell auslösen kann.
Quellen
Stand:
- Bundesamt für Sicherheit in der Informationstechnik: Basisschutz gegen Indirect Prompt Injections in dokumentbasierten LLM-Chats, Version 1.0, Stand 14.09.2026, abgerufen am 22.11.2026. zurück
- Bundesamt für Sicherheit in der Informationstechnik: Basisschutz gegen Indirect Prompt Injection in dokumentbasierten LLM-Chats (Downloadseite), Stand 24.09.2026, abgerufen am 22.11.2026. zurück
- OWASP GenAI Security Project: LLM01:2025 Prompt Injection, Stand 2025, abgerufen am 22.11.2026. zurück
- OWASP GenAI Security Project: GenAI LLM Top 10 2026 (Liste der Einträge), Stand 04.08.2026, abgerufen am 22.11.2026. zurück
- Bundesamt für Sicherheit in der Informationstechnik: Auswirkungen auf die Cybersicherheit von Organisationen durch die Entwicklung im Bereich Künstlicher Intelligenz (BITS-B Nr. 2026-262788-1032, Version 1.0), Stand 22.06.2026, abgerufen am 22.11.2026. zurück
- OWASP GenAI Security Project: LLM06:2025 Excessive Agency, Stand 2025, abgerufen am 22.11.2026. zurück