Anleitungen
Prompts testen
Kurzantwort
Prompts testest du mit einer festen Sammlung echter Fälle, die du nach jeder Änderung erneut durchlaufen lässt. Vorher legst du fest, woran eine gute Antwort zu erkennen ist, und vergleichst die Fassungen danach anhand dieser Kriterien. Am Ende steht für jede Fassung ein Anteil bestandener Prüfungen, den andere nachvollziehen können.
Wer einen Prompt jeden Tag für Angebote, Kundenmails oder die Prüfung von Rechnungen nutzt, bemerkt Fehler oft erst, wenn sie beim Kunden ankommen. Ein Test mit festen Fällen holt diese Fehler vorher heraus. Anthropic setzt für die Arbeit an Prompts drei Dinge voraus: klare Erfolgskriterien, eine Möglichkeit, empirisch dagegen zu prüfen, und einen ersten Entwurf1. OpenAI rät, vor jeder Änderung an einem Prompt im Betrieb typische Testfälle und Prüfungen anzulegen2.
Der Ablauf unten ist für Betriebe mit wiederkehrenden Abläufen gedacht. Ein öffentlicher Benchmark misst dagegen, wie Modelle bei allgemeinen Aufgaben abschneiden, und hilft eher bei der Wahl zwischen Modellen (KI-Modelle im Vergleich).
Woran du eine gute Antwort erkennst
Bevor du den ersten Fall laufen lässt, schreibst du auf, woran du eine gute Antwort erkennst. Anthropic verlangt Kriterien, die genau, messbar, erreichbar und für die Aufgabe wichtig sind. "Stimmungen gut erkennen" ist zu vage; eine Trefferquote, die auf einer festen Testsammlung erreicht werden muss, ist prüfbar3. Als typische Kriterien nennt Anthropic unter anderem Treue zur Aufgabe, gleichbleibende Ergebnisse, Ton und Stil, Schutz persönlicher Daten, die Nutzung des mitgegebenen Kontexts, Antwortzeit und Preis3.
Für den Alltag im Betrieb empfehlen wir drei bis fünf Kriterien, die sich mit Ja oder Nein beantworten lassen. Für eine Kundenantwort könnten das sein: Sind alle Fragen der Kundin beantwortet? Stimmen Preis und Termin mit den Vorgaben überein? Ist die Antwort kürzer als 150 Wörter? Fehlen Zusagen, die niemand freigegeben hat? Ja-Nein-Fragen haben den Vorteil, dass zwei Personen beim Bewerten selten auseinanderliegen.
Eine Sammlung echter Fälle
Testfälle kommen aus dem echten Betrieb, nicht aus dem Kopf. Anthropic rät, die tatsächliche Verteilung der Aufgaben abzubilden und Grenzfälle einzubauen, etwa unpassende, sehr lange oder mehrdeutige Eingaben3. In der Praxis bewährt sich eine Mischung aus einfachen Fällen, schwierigen Fällen und einigen, bei denen die richtige Antwort eine Rückfrage oder ein "Das können wir nicht" ist. Gerade an diesen Fällen scheitern Prompts, die in der Vorführung glänzen.
Wie viele Fälle es sein sollen, hängt vom Ablauf ab. Anthropic gibt den Grundsatz aus, lieber viele Fälle mit etwas gröberer Bewertung zu nehmen als wenige, die von Hand aufwendig bewertet werden3. Für einen ersten Test empfehlen wir 20 bis 30 Fälle aus den letzten Wochen. Namen, Adressen und Kundennummern ersetzt du vorher durch erfundene Angaben, damit keine echten Daten in Testdateien und KI-Dienste wandern. Zu jedem Fall schreibst du gleich die erwartete Lösung auf, so wie eine erfahrene Kollegin sie geben würde. Bei Sortieraufgaben ist das eine Kategorie, bei Texten eine Liste der Punkte, die in der Antwort vorkommen müssen. Ohne diese Lösung bewertest du später nach Gefühl.
Bewertungsregeln vor dem ersten Lauf
Für jedes Kriterium legst du fest, wer oder was es bewertet. Anthropic beschreibt mehrere Wege3:
- Vergleich mit einer festen Lösung, nachdem Groß- und Kleinschreibung und Leerzeichen angeglichen wurden, etwa bei Kategorien oder Ja-Nein-Antworten.
- Bewertung durch einen Menschen, der die Kriterien abhakt.
- Bewertung durch ein Sprachmodell, das nach einer Anleitung eine Note oder ein Ja oder Nein vergibt.
Bei der Bewertung durch ein Modell rät Anthropic, ein anderes Modell zu nehmen als das, das die Antwort geschrieben hat3. Eine solche Bewertungsanleitung für ein Modell kann schlicht sein: "Du prüfst Antworten eines Kundendienstes. Beantworte für die Antwort unten vier Fragen jeweils mit ja oder nein: Sind alle Fragen der Kundin beantwortet? Stimmen Preis und Termin mit den Vorgaben überein? Hat die Antwort weniger als 150 Wörter? Enthält sie keine Zusagen außerhalb der Vorgaben? Gib nur die vier Antworten aus." Damit das Modell prüfen kann, bekommt es die Vorgaben zu Preis und Termin mit, sonst hat es keinen Maßstab.
Wichtiger als die Methode ist der Zeitpunkt. Wer die Kriterien erst festlegt, nachdem er die Antworten gesehen hat, passt sie unbewusst an das Ergebnis an. In Abläufen mit Folgen für Kunden bleibt am Ende ein Mensch zuständig, der Stichproben prüft, wie es das Prinzip Human in the Loop beschreibt.
Jeden Fall mehrmals laufen lassen
Derselbe Prompt liefert nicht jedes Mal dieselbe Antwort. Google beschreibt die Temperatur als Einstellung, mit der Antworten gleichförmiger oder abwechslungsreicher werden4, und im Chat kannst du sie meist nicht festlegen. Ein einzelner gelungener Lauf beweist deshalb wenig. Er zeigt, dass der Prompt funktionieren kann, aber nicht, wie oft er es tut. Wir empfehlen, jeden Fall je Prompt-Fassung mindestens dreimal laufen zu lassen.
Anthropic prüft die Beständigkeit außerdem mit umformulierten Eingaben: dieselbe Frage mit Tippfehlern, mit überflüssigen Details oder als langer, umständlicher Text3. Weichen die Antworten stark voneinander ab, ist der Prompt für den Betrieb zu empfindlich.
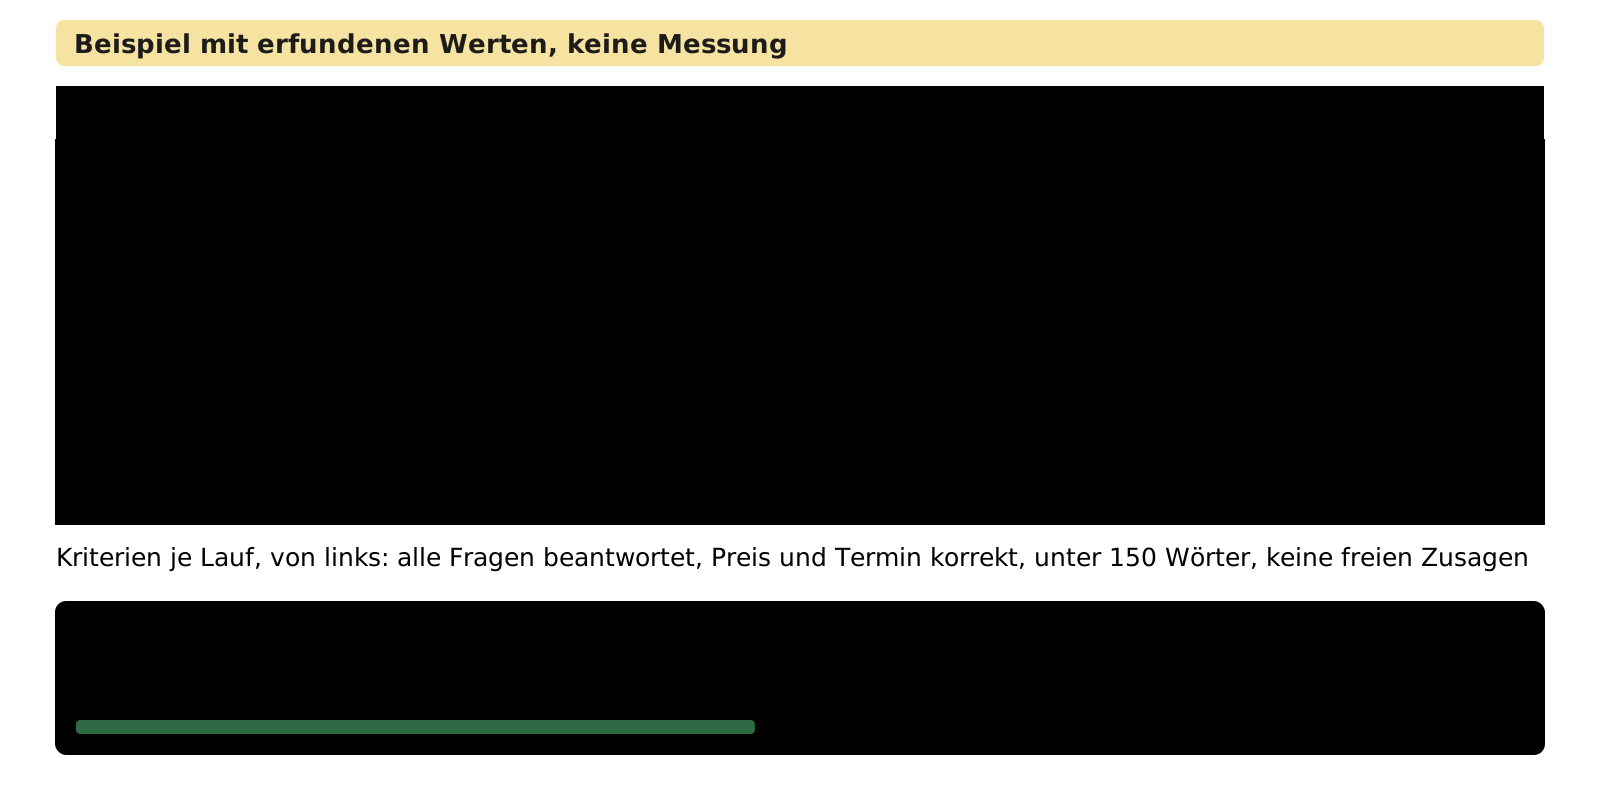
- Testfall echter Fall aus dem Betrieb
- Lauf ein Durchgang mit derselben Prompt-Fassung
- Bewertung Haken oder Kreuz je Kriterium
Fassungen vergleichen und Abweichungen messen
Für jede Fassung zählst du, wie viele Prüfungen bestanden sind, und zwar je Kriterium. Zusätzlich schaust du, wie stark die drei Läufe desselben Falls voneinander abweichen. Ein Prompt, der in allen Läufen ähnlich gut abschneidet, ist im Alltag oft brauchbarer als einer mit etwas höherem Durchschnitt, der zwischen sehr gut und unbrauchbar schwankt.
Die aufschlussreichsten Zeilen sind die Fälle, die durchfallen. Lies sie einzeln: Fehlt Kontext, ist eine Regel unklar, oder verlangt der Fall Wissen, das im Prompt gar nicht steht? Ändere danach nur eine Sache und lass alle Fälle erneut laufen. Wer drei Dinge gleichzeitig ändert, weiß hinterher nicht, welche Änderung geholfen hat. Kandidaten für diese eine Änderung sind zum Beispiel ein Beispiel mehr, eine klarere Rolle oder ein festes Ausgabeformat, alles Techniken aus dem Prompt Engineering.
Ein Beispiel aus dem Handwerk
Angenommen, ein Elektrobetrieb lässt eingehende Rechnungen von einem Sprachmodell einer Kostenart zuordnen: Material, Fahrzeug, Werkzeug, Büro oder Sonstiges. Die Buchhaltung prüft bisher jede Zuordnung von Hand und möchte wissen, ob sie sich auf den Prompt verlassen kann.
Als Kriterien legt sie fest: Die Kostenart stimmt mit der Lösung überein, die Antwort enthält nur die Kostenart, und bei unleserlichen Belegen kommt eine Rückfrage statt einer Vermutung. Die Testsammlung besteht aus 25 Belegen der letzten zwei Monate, darunter Tankquittungen, eine Sammelrechnung des Großhändlers mit Material und Werkzeug und zwei schlecht gescannte Belege.
Beim ersten Test fällt Fassung A vor allem bei der Sammelrechnung und den unleserlichen Belegen durch. Fassung B bekommt zwei Sätze dazu: eine Regel für Rechnungen mit mehreren Kostenarten und die Anweisung, bei unleserlichen Angaben nachzufragen. Nach dem zweiten Lauf bestehen beide Grenzfälle, die einfachen Fälle bleiben unverändert gut. Die Buchhaltung prüft künftig nur noch Stichproben und alle Belege, bei denen das Modell nachfragt. Belege vorkontieren ist nur eine von mehreren Aufgaben, für die Betriebe KI in der Buchhaltung einsetzen.
Nach jeder Änderung erneut testen
Die Testsammlung ist auch deine Absicherung gegen Änderungen, die du nicht selbst machst. Anbieter bringen neue Modellversionen heraus, und ein Prompt kann danach anders wirken. OpenAI empfiehlt, Anwendungen im Betrieb an eine feste Modellversion zu binden2. Steht ein Wechsel an, lässt du die Sammlung mit dem neuen Modell laufen und vergleichst, bevor du umstellst.
Dass auch Werkzeuge kommen und gehen, zeigt OpenAI selbst: Die Evals-Plattform des Anbieters ist für bestehende Nutzer seit dem 31.10.2026 nur noch lesbar und wird am 30.11.2026 abgeschaltet5. Halte deine Testfälle deshalb in einem Format, das du selbst besitzt, etwa einer Tabelle oder einer Textdatei.
Mit welchem Aufwand ein Betrieb anfangen kann
Für den Anfang reicht eine Tabellenkalkulation. Eine Zeile je Fall, Spalten für die Eingabe, die erwartete Lösung, die Kriterien und je Lauf das Ergebnis. Die Läufe machst du von Hand im Chat, bei 20 Fällen mit drei Läufen und zwei Fassungen ist das ein Vormittag. Wer häufiger testet, lässt die Läufe über die API des Anbieters automatisch laufen und schreibt die Antworten direkt in die Tabelle. Notiere bei jedem Testlauf das Datum, die Fassung des Prompts und das Modell mit seiner Versionsbezeichnung. Wenn sich ein Ergebnis Wochen später verschlechtert, siehst du so sofort, ob sich der Prompt oder das Modell geändert hat.
Lohnend ist der Aufwand überall dort, wo ein Prompt viele Male am Tag läuft oder seine Antworten ohne Prüfung weitergehen: Antworten an Kunden, Einordnung von Belegen, Auszüge aus Verträgen. Für einen Prompt, den du einmal im Monat für eine interne Notiz nutzt, genügt ein kurzer Blick auf das Ergebnis. Wie solche Abläufe insgesamt aufgebaut werden, zeigen Abläufe mit KI automatisieren und KI im Betrieb einführen.
Prompt-Tests und Prüfungen bieten auch Dienstleister an, darunter der Betreiber dieser Website, SEO NW, der selbst KI- und GEO-Dienste anbietet. Die Tests lassen sich ohne fremde Hilfe aufsetzen. Für die ersten Fälle eignen sich die Prompt-Vorlagen, die du an deine Abläufe anpasst.
Was das für dich heißt
Ein Test mit festen Fällen dauert bei 20 Fällen einen Vormittag und kann Fehler abfangen, bevor sie beim Kunden ankommen.
- Wähle den Prompt, der bei dir am häufigsten läuft, und schreib drei bis fünf Ja-Nein-Kriterien auf.
- Sammle 20 echte Fälle aus den letzten Wochen und ersetze persönliche Angaben.
- Lass jeden Fall dreimal laufen und trag die Ergebnisse in eine Tabelle ein.
- Wiederhole den Test, bevor du das Modell wechselst.
Häufige Fragen
Prompt-Evaluation, was heißt das?
So nennt man das systematische Prüfen von Prompts gegen feste Testfälle und vorher bestimmte Kriterien. Das Ergebnis ist ein Anteil bestandener Prüfungen je Prompt-Fassung.
Kann ich einen Prompt auch ohne Programmierkenntnisse testen?
Ja. Eine Tabelle mit Fällen und Kriterien und einige Läufe von Hand im Chat reichen für den Anfang. Programmieren lohnt sich erst, wenn du oft und mit vielen Fällen testest.
Darf ich echte Kundendaten als Testfälle nehmen?
Ersetze Namen, Adressen und Nummern vorher durch erfundene Angaben. Welche Daten in einen KI-Dienst dürfen, klärst du mit den Regeln deines Betriebs; Hintergründe stehen bei [KI und Datenschutz im Unternehmen](/unternehmen/ki-datenschutz).
Wie oft sollte ich meine Tests wiederholen?
Nach jeder Änderung am Prompt, vor jedem Wechsel des Modells und in festen Abständen bei wichtigen Abläufen. Anbieter ändern Modelle, auch ohne dass du am Prompt etwas machst.
Quellen
Stand:
- Anthropic: Prompt engineering overview (Claude API Docs), abgerufen am 22.11.2026. zurück
- OpenAI: Prompt engineering (OpenAI API Docs), abgerufen am 22.11.2026. zurück
- Anthropic: Define success criteria and build evaluations (Claude API Docs), abgerufen am 22.11.2026. zurück
- Google: Prompt design strategies (Gemini API, Google AI Studio), abgerufen am 22.11.2026. zurück
- OpenAI: Working with evals (OpenAI API Docs), abgerufen am 22.11.2026. zurück