Unternehmen
RAG-Systeme im Betrieb
Kurzantwort
Ein RAG-System sucht zu jeder Frage die passenden Abschnitte aus euren Dokumenten und gibt sie dem Sprachmodell mit, das daraus antwortet und die Fundstelle nennen kann1. Die Technik ist heute ein Baukasten. Aufwand machen die Dokumente: eine gültige Fassung je Thema, sinnvoll zerlegte Abschnitte, Zugriffsrechte und regelmäßige Pflege.
Wenn ein Betrieb sagt, die KI solle "unsere Unterlagen kennen", kommt vor allem Retrieval Augmented Generation in Frage, kurz RAG. Das Modell wird dabei nicht verändert, anders als beim Fine-Tuning. Es bekommt zu jeder Frage ein paar passende Textstellen aus euren Dokumenten mit und formuliert daraus die Antwort. So lassen sich Handbücher, Verträge, Produktdaten oder interne Richtlinien befragen, ohne dass jemand ein Modell trainieren muss.
Vom Dokument zur Antwort
- Vorab aufbereiten, zerlegen, einbetten
- Bei jeder Frage suchen, auswählen, antworten
- Rechtefilter in der Suche
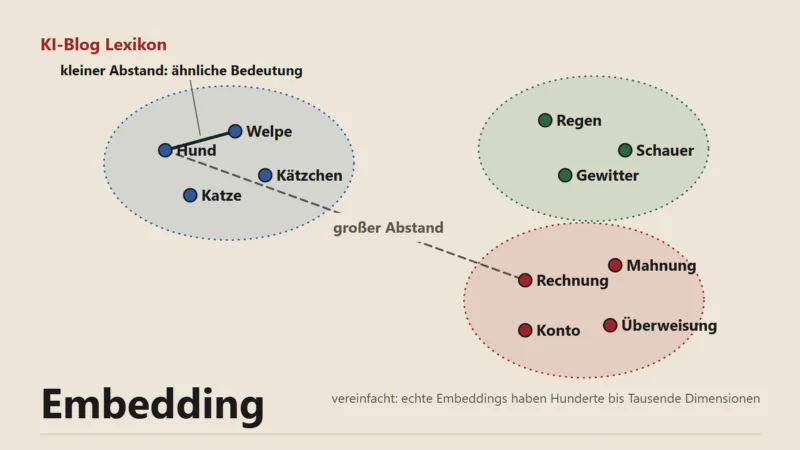
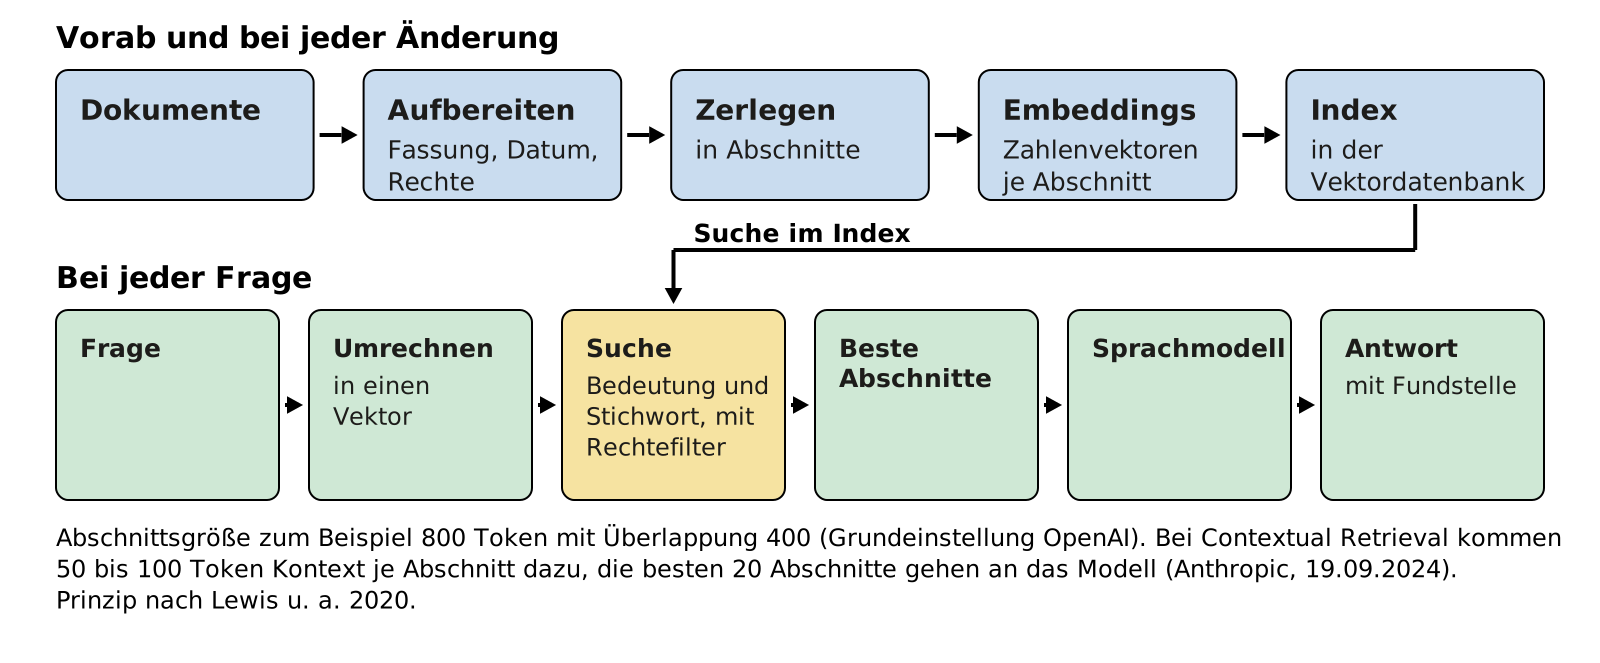
Ein RAG-System hat zwei Hälften. Die erste läuft vorab und bei jeder Änderung: Dokumente werden eingelesen, bereinigt, in Abschnitte zerlegt und als Embeddings gespeichert, also als Zahlenreihen, in denen ähnliche Inhalte nah beieinanderliegen. Die zweite läuft bei jeder Frage: Die Frage wird ebenfalls umgerechnet, die Suche holt die ähnlichsten Abschnitte, und das Modell bekommt Frage und Abschnitte zusammen.
Die Idee geht auf eine Arbeit von Patrick Lewis und Kollegen aus dem Jahr 2020 zurück. Sie verbanden ein Sprachmodell mit einem durchsuchbaren Index und nannten als offene Probleme reiner Sprachmodelle, dass sie keine Herkunft für ihre Aussagen angeben und ihr Wissen schlecht aktualisiert werden kann1. Genau diese beiden Punkte sind bis heute die Gründe, RAG einzusetzen: Die Antwort kann die Fundstelle nennen, und ein geändertes Dokument wirkt, sobald es neu eingelesen ist.
Braucht ihr überhaupt eine Suche?
Nicht jede Wissensdatenbank braucht den vollen Aufbau. Anthropic empfiehlt, Wissensbestände unter 200.000 Token einfach komplett in die Anfrage zu geben; mit dem Zwischenspeicher der Schnittstelle wird das schneller und günstiger2. Wie viele Token deine Unterlagen haben, misst der Token-Zähler. Für einzelne Personen, die mit wenigen Dokumenten arbeiten, reicht oft auch ein Werkzeug wie Gemini Notebook (früher NotebookLM) oder ein Projekt im Chat-Assistenten, der erste von vier Wegen zum eigenen KI-Chatbot.
Ein eigenes RAG-System lohnt sich, wenn die Unterlagen deutlich größer sind, sich oft ändern, mehrere Personen mit unterschiedlichen Rechten darauf zugreifen oder die Antworten in eine Fachanwendung einfließen sollen.
Dokumente vorbereiten
Die Antworten können nur so gut sein wie die Dokumente, aus denen die Suche schöpft. Vier Arbeiten gehören deshalb zur Vorbereitung, und alle hängen an der Datenqualität im Betrieb:
- Je Thema bleibt eine gültige Fassung. Liegen drei Versionen einer Preisliste im Bestand, findet die Suche womöglich die falsche und das Modell zitiert sie überzeugt.
- Jedes Dokument bekommt ein Stand-Datum und eine verantwortliche Person, beides als Metadaten. Dann kann die Antwort sagen, wie alt die Quelle ist.
- Gescannte PDFs brauchen Texterkennung, Tabellen sollten als Tabelle erhalten bleiben, Kopf- und Fußzeilen auf jeder Seite stören die Suche und gehören raus.
- Zu jedem Dokument wird gespeichert, wer es sehen darf, damit die Suche später danach filtern kann.
Chunking: wie groß die Abschnitte sein sollen
Das Zerlegen in Abschnitte heißt Chunking. Zu große Abschnitte verwässern die Suche, weil ein Abschnitt dann viele Themen enthält. Zu kleine verlieren den Zusammenhang, etwa wenn ein Satz wie "Die Frist beträgt 14 Tage" ohne die Überschrift landet, zu welchem Vertrag er gehört. Anthropic beschreibt übliche Abschnitte mit einigen hundert Token oder weniger2. Bei der Dateisuche von OpenAI liegt die Grundeinstellung bei 800 Token je Abschnitt mit 400 Token Überlappung, einstellbar zwischen 100 und 4.096 Token3.
Besser als feste Längen funktioniert meist ein Schnitt an Überschriften und Absätzen, mit kleiner Überlappung. Einen Schritt weiter geht das Verfahren, das Anthropic "Contextual Retrieval" nennt: Ein Modell schreibt vor jeden Abschnitt einen kurzen Kontext von meist 50 bis 100 Token, etwa "Aus dem Rahmenvertrag mit Lieferant X, Abschnitt Kündigung"2. In Anthropics Tests sank der Anteil der Fragen, zu denen die Suche den richtigen Abschnitt nicht fand, damit um 35 Prozent, zusammen mit einer Stichwortsuche um 49 Prozent und mit einem zusätzlichen Nachsortieren der Treffer um 67 Prozent2. Die Kontexte kosteten dort einmalig rund 1,02 US-Dollar je Million Token Dokumenttext2.
Suche und Datenbank
Gespeichert werden die Embeddings in einer Vektordatenbank. Für kleinere und mittlere Bestände muss das kein eigenes System sein: Die Erweiterung pgvector bringt Vektorsuche in eine vorhandene PostgreSQL-Datenbank und unterstützt die gängigen Indexarten HNSW und IVFFlat5. Der Vorteil ist, dass Dokumente, Rechte und Vektoren in einer Datenbank liegen und gemeinsam abgefragt werden.
Die reine Bedeutungssuche, auch semantische Suche genannt, findet Abschnitte mit ähnlichem Sinn, übersieht aber leicht exakte Begriffe wie Artikelnummern. Anthropic kombiniert sie deshalb mit einer klassischen Stichwortsuche und gibt dem Modell in seinen Tests die besten 20 Abschnitte mit, was besser abschnitt als 5 oder 102.
Rechte und Sicherheit
Die Zugriffsrechte müssen in der Suche greifen. Filtert das System erst die fertige Antwort, hat das Modell den vertraulichen Abschnitt schon gesehen und kann ihn umschreiben oder anreißen. Die OWASP-Liste der Risiken für Sprachmodell-Anwendungen führt Schwächen rund um Vektoren und Embeddings seit 2026 als eigenen Eintrag6.
Dazu kommt die Frage, wer Dokumente in den Bestand legen darf. OWASP beschreibt als Angriffsweg ein manipuliertes Dokument in einer RAG-Ablage, das die Antworten in die gewünschte Richtung lenkt7. Wer externe Dokumente oder Mails automatisch einliest, holt sich damit auch versteckte Anweisungen ins System, eine Form der Prompt Injection.
Was ein RAG-System kostet
Die reinen Technikkosten sind meist klein. OpenAI berechnet für das Umrechnen in Embeddings 0,02 US-Dollar je Million Token mit dem kleinen und 0,13 US-Dollar mit dem großen Modell4. Rechenbeispiel: Ein Bestand von 10.000 Seiten mit je rund 500 Token ergibt 5 Millionen Token und kostet beim ersten Einlesen 0,10 oder 0,65 US-Dollar4. Für jede Frage kommen die Modellaufrufe dazu, deren Preis vor allem davon abhängt, wie viele Abschnitte mitgehen.
Teuer sind die Arbeiten drumherum: Dokumente aufräumen und umwandeln, Rechte abbilden, Testfragen sammeln und prüfen, den Bestand aktuell halten. Bei über Jahre gewachsenen Ablagen kann diese Arbeit den größten Teil des Projekts ausmachen, bei gepflegten Beständen geht sie schneller. Belastbare Zahlen dazu gibt es nicht, weil jeder Bestand anders aussieht.
Fallstricke im Betrieb
Ein RAG-System veraltet still. Es antwortet weiter, nur eben nach der alten Preisliste, wenn niemand den Abgleich nach Änderungen angestoßen hat. Ein automatischer Abgleich beim Speichern und das Stand-Datum in jeder Antwort fangen das ab.
Findet die Suche nichts Passendes, antwortet das Modell trotzdem, wenn man es nicht ausdrücklich anweist, das zu sagen. RAG senkt Halluzinationen, schaltet sie aber nicht ab. Die Anweisung "Wenn die Abschnitte die Frage nicht beantworten, sag das" gehört deshalb in jede Systemanweisung, ebenso die Pflicht, die Fundstelle zu nennen.
Und schließlich braucht das System einen Satz Testfragen mit bekannten Antworten, der nach jeder Änderung an Dokumenten, Abschnittsgrößen oder Modell durchläuft. Ohne diesen Test merkt niemand, wenn eine Umstellung die Qualität verschlechtert. Prüfe dabei Suche und Antwort getrennt. Findet die Suche den richtigen Abschnitt nicht, kann auch das beste Modell nicht richtig antworten. Anthropic hat in seinen Versuchen genau diesen Anteil gemessen: Ohne Zusatzmaßnahmen fehlte bei 5,7 Prozent der Fragen der richtige Abschnitt unter den besten 20 Treffern, mit Kontext, Stichwortsuche und Nachsortieren noch bei 1,9 Prozent2. Für den eigenen Bestand reicht eine einfachere Variante: Notiere zu jeder Testfrage, in welchem Dokument die Antwort steht, und zähle, wie oft die Suche es findet.
Hilfreich ist auch, wenn das System die gefundenen Stellen mit ausgibt. Die Dateisuche von OpenAI liefert dafür Fundstellen als Anmerkungen in der Antwort; über eine Obergrenze für die Zahl der Treffer lassen sich Token und Wartezeit senken, was laut Dokumentation zu Lasten der Antwortqualität gehen kann8.
Die Wissensdatenbank im Alltag
Eine KI-Wissensdatenbank ist ein Dauerbetrieb. Jemand muss neue Dokumente aufnehmen, alte entfernen, Rückmeldungen der Nutzer auswerten und die Testfragen pflegen. Legt fest, wer das tut und wie oft der Bestand abgeglichen wird.
Baut ein Dienstleister das System, gehören ein paar Punkte in den Vertrag: wem die aufbereiteten Dokumente und Embeddings gehören, ob sie sich exportieren lassen, wer den Abgleich übernimmt und wer in welchen Abständen Stichproben der Antworten prüft. Die aufbereiteten Daten bleiben nur dann nutzbar, wenn sie sich exportieren und in ein anderes System mitnehmen lassen. Diese Vertragspunkte ergänzen die allgemeinen Fragen zur Auswahl eines KI-Dienstleisters. Alexander Müller bietet mit SEO NW selbst KI-Dienste an, Anbieternamen stehen deshalb hier nicht.
Was das für dich heißt
Bevor du über Datenbanken nachdenkst, schau dir an, in welchem Zustand eure Unterlagen sind.
- Zähl die Token eurer wichtigsten Unterlagen; vielleicht passen sie ohne Suche in eine Anfrage.
- Such dir einen Themenbereich mit gepflegten Dokumenten für den ersten Versuch.
- Leg zwanzig Testfragen mit bekannten Antworten an, bevor das erste Dokument eingelesen wird.
- Kläre, wer den Bestand pflegt und wie oft er abgeglichen wird.
Häufige Fragen
Was ist der Unterschied zwischen einer KI-Wissensdatenbank und einer normalen Suche im Intranet?
Die normale Suche liefert eine Trefferliste, und du liest selbst nach. Ein RAG-System liest die besten Treffer für dich und formuliert eine Antwort mit Fundstelle. Die Suche darunter ist ähnlich, sie arbeitet nur zusätzlich mit Bedeutungsähnlichkeit.
Brauche ich für RAG eine spezielle Vektordatenbank?
Für kleine und mittlere Bestände nicht zwingend. Eine PostgreSQL-Datenbank mit der Erweiterung pgvector kann Vektoren speichern und durchsuchen, zusammen mit Dokumenten und Rechten. Spezialsysteme lohnen sich eher bei sehr großen Beständen.
Kann ein RAG-System auch auf eigener Hardware laufen?
Ja. Embedding-Modell, Datenbank und Sprachmodell lassen sich lokal betreiben, dann verlassen die Dokumente das Haus nicht. Du brauchst dafür passende Hardware und jemanden, der Updates und Sicherheit übernimmt.
Woran erkenne ich, dass mein RAG-System schlechter geworden ist?
An einem festen Satz Testfragen mit bekannten Antworten, den du nach jeder Änderung durchlaufen lässt. Sinkt der Anteil richtiger Antworten oder fehlen Fundstellen, kann es an neuen Dokumenten oder geänderten Abschnittsgrößen liegen.
Quellen
Stand:
- arXiv: Lewis u. a.: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Stand 22.05.2020, abgerufen am 22.11.2026. zurück
- Anthropic: Introducing Contextual Retrieval, Stand 19.09.2024, abgerufen am 22.11.2026. zurück
- OpenAI: Retrieval (API Docs: Abschnittsgröße und Überlappung), abgerufen am 22.11.2026. zurück
- OpenAI: API Pricing (Embeddings), Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- pgvector: Open-source vector similarity search for Postgres (README), abgerufen am 22.11.2026. zurück
- OWASP GenAI Security Project: GenAI LLM Top 10 2026 (Liste der Einträge), Stand 04.08.2026, abgerufen am 22.11.2026. zurück
- OWASP GenAI Security Project: LLM01:2025 Prompt Injection, Stand 2025, abgerufen am 22.11.2026. zurück
- OpenAI: File search (API Docs), abgerufen am 22.11.2026. zurück