Unternehmen · Vergleich
RAG oder Fine-Tuning
Kurzantwort
RAG gibt einem Sprachmodell bei jeder Frage passende Abschnitte aus deinen Dokumenten mit; Fine-Tuning trainiert das Modell mit Beispielen nach, damit es Format, Ton oder eine eng umrissene Aufgabe zuverlässiger trifft13. Soll das Modell eure Unterlagen kennen, passt RAG. Fine-Tuning lohnt sich, wenn ein bestimmtes Verhalten in großer Menge gebraucht wird und Anweisungen mit Beispielen nicht reichen.
Die Frage kommt auf, sobald jemand sagt: "Das Modell soll unsere Handbücher kennen." Der erste Gedanke ist dann oft, das Modell mit den Handbüchern zu trainieren. Das klingt gründlich, trifft das Ziel aber meist nicht. Fakten aus Dokumenten bekommt ein Modell zuverlässiger, wenn man ihm die passenden Stellen in der Anfrage mitgibt. Training ändert vor allem, wie es antwortet. Beide Verfahren lassen sich kombinieren, und bei manchen Anbietern ist Fine-Tuning inzwischen schwerer zu haben als vor einem Jahr.
Was die beiden Verfahren verändern
RAG steht für Retrieval Augmented Generation. Das Modell bleibt, wie es ist. Zu jeder Frage sucht ein RAG-System die passenden Abschnitte aus deinen Dokumenten und legt sie der Anfrage bei. Lewis und Kollegen, die das Verfahren 2020 beschrieben, nannten als offene Probleme reiner Sprachmodelle, dass sie keine Herkunft für ihre Aussagen angeben und ihr Wissen schlecht aktualisieren können; ein durchsuchbarer Index soll beides lösen1.
Fine-Tuning heißt, ein fertiges Modell mit eigenen Beispielen weiterzutrainieren. Die Gewichte des Modells ändern sich, ganz oder in einem kleinen Zusatzteil. Verbreitet ist dafür das Verfahren LoRA: Laut der Originalarbeit sinkt damit die Zahl der zu trainierenden Parameter gegenüber vollem Nachtraining um den Faktor 10.000 und der Bedarf an Grafikspeicher um den Faktor drei, ohne zusätzliche Wartezeit bei der Antwort2. Die Trainingsdaten sind Paare aus Eingabe und gewünschter Ausgabe.
| Kriterium | RAG | Fine-Tuning |
|---|---|---|
| Was sich ändert | Wissen, das bei jeder Frage mitgegeben wird | Verhalten, Format und Ton des Modells |
| Geänderte Fakten | wirken nach dem Neueinlesen des Dokuments | wirken erst nach neuem Training |
| Fundstelle in der Antwort | möglich, die Abschnitte sind bekannt | nicht vorgesehen |
| Zugriffsrechte | über Filter in der Suche | im Modell nicht abbildbar |
| Einstieg | Embeddings ab 0,02 US-Dollar je Million Token (OpenAI) | Training ab 5 US-Dollar je Million Token (OpenAI gpt-4.1-mini, nur aktive Bestandskunden, Modell läuft am 14.01.2027 aus) |
| Wechsel des Grundmodells | Aufbau bleibt, Tests wiederholen | Training wiederholen |
| Verfügbarkeit | bei allen großen Anbietern und lokal | OpenAI läuft aus, Google Vertex AI für Gemini, lokal mit LoRA |
| Typischer Einsatz | Handbücher, Richtlinien, Produktdaten befragen | Einordnen, festes Format, Rolle im Chat |
Stand: 22.11.2026 Preise laut Preisseite von OpenAI am 22.11.2026 in US-Dollar; Anbieterlage laut Dokumentation von OpenAI und Google am 22.11.2026.
Wofür Fine-Tuning gut ist
OpenAI nennt in seinem Leitfaden zur Modelloptimierung als Einsatzzwecke unter anderem ein gleichbleibendes Ausgabeformat, den richtigen Ton und Stil, kürzere Anfragen und damit geringere Kosten und Wartezeiten sowie das Trainieren eines kleineren, günstigeren Modells für eine bestimmte Aufgabe3. Google listet für das Nachtrainieren seiner Gemini-Modelle ähnliche Fälle: Einordnen in feste Kategorien, Zusammenfassen in einem festen Format, Antworten aus mitgegebenem Kontext herausziehen und Chats in einer bestimmten Rolle6. Google erwähnt außerdem, dass sich durch Training Beispiele aus der Anfrage einsparen lassen6.
Gemeinsam ist diesen Fällen: Die Aufgabe ist eng, sie wiederholt sich sehr oft, und das gewünschte Verhalten lässt sich an Beispielen zeigen. Ein typischer Kandidat ist die Einordnung eingehender Mails in zwanzig feste Kategorien, tausende Male am Tag. Ein kleines, nachtrainiertes Modell kann das schneller und günstiger als ein großes Modell mit langer Anweisung.
Wo Fine-Tuning nicht weiterhilft
Fakten, die sich ändern, gehören nicht ins Training. Eine neue Preisliste würde ein erneutes Training verlangen, bei RAG reicht es, das Dokument neu einzulesen. Ein nachtrainiertes Modell kann außerdem keine Fundstelle nennen, weil es das Wissen nicht aus einem Dokument holt.
Zugriffsrechte lassen sich im Modell nicht abbilden. Was im Training steckt, kann grundsätzlich jeder abrufen, der das Modell befragen darf. Bei Personal-, Kunden- oder Vertragsunterlagen ist das oft schon der ausschlaggebende Grund für RAG, wo die Suche nach Rechten filtert.
Und ein Modell, das mit Handbüchern trainiert wurde, übernimmt deren Tonfall, erfindet aber weiter Inhalte, wenn es eine Antwort nicht sicher weiß. Weil es dabei fachlich klingt, fallen solche Halluzinationen sogar schwerer auf.
Entscheidungsbaum
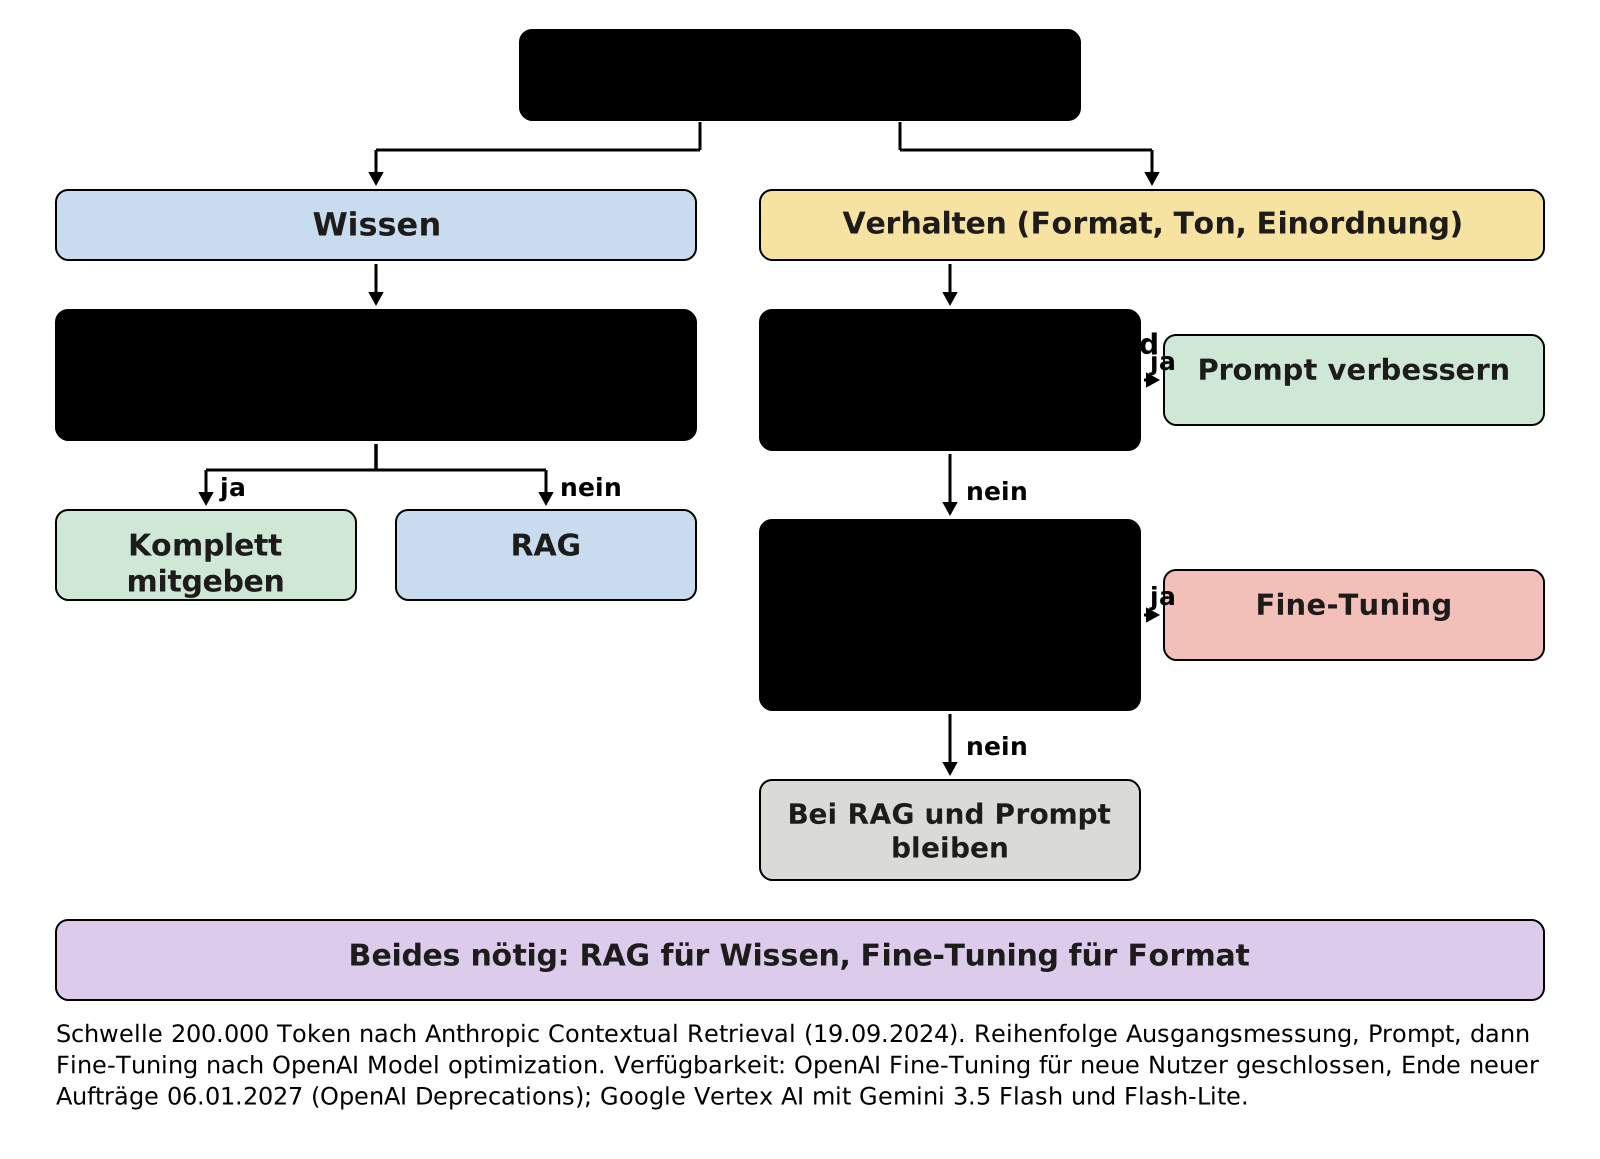
- Wissen Mitgeben oder RAG
- Verhalten Prompt, dann Fine-Tuning
- Beides RAG plus Fine-Tuning
Die erste Frage ist, ob dem Modell Wissen fehlt oder ob es sich falsch verhält. Fehlt Wissen, kommt es auf die Menge an. Kleine Bestände gibst du nach dem Rat von Anthropic komplett in die Anfrage7, erst bei größeren lohnt sich eine Suche, also RAG.
Verhält sich das Modell falsch, etwa im Format, im Ton oder in der Einordnung, versuchst du es zuerst mit einer besseren Anweisung nach den Regeln des Prompt Engineering und ein paar Beispielen in der Anfrage (Few-Shot). OpenAI beschreibt die Reihenfolge ähnlich: zuerst mit Testfällen eine Ausgangsmessung anlegen, dann Anweisungen und Kontext verbessern und Fine-Tuning nur für bestimmte Fälle einsetzen3. Fine-Tuning kommt in Frage, wenn trotz guter Anweisung Fehler bleiben, die Aufgabe stabil ist, genug saubere Beispiele vorliegen und dein Anbieter das Verfahren noch anbietet.
Gedachtes Beispiel: ein Großhandel für Sanitärteile
Angenommen, ein Großhändler für Sanitärteile will Anfragen von Installateuren schneller beantworten. Drei Wünsche stehen auf dem Zettel: Die KI soll wissen, welches Ersatzteil zu welcher Armatur passt. Sie soll ihre Antwort so liefern, dass die Warenwirtschaft sie direkt als Angebot übernehmen kann. Und sie soll die rund dreißig Anfragearten erkennen, die täglich hereinkommen.
Der erste Wunsch ist ein Wissensproblem. Die Zuordnung von Teilen zu Armaturen steht in Herstellerkatalogen und der eigenen Artikeldatenbank, sie ändert sich mit jedem neuen Sortiment, und der Außendienst darf andere Preise sehen als die Kunden. Das spricht klar für RAG mit einem Rechtefilter in der Suche.
Der zweite Wunsch klingt nach Training, lässt sich aber meist ohne lösen. Mehrere Anbieter können die Antwort des Modells an ein vorgegebenes Schema binden; bei der Claude-Schnittstelle ist die Ausgabe dann immer gültiges JSON mit den festgelegten Pflichtfeldern8. Ein festes Format über Training zu erzwingen, ist für diesen Fall unnötig aufwendig.
Beim dritten Wunsch kann Fine-Tuning sinnvoll werden, wenn die Menge groß ist. Kommen täglich viele hundert Anfragen herein, kann ein kleines, auf die dreißig Arten nachtrainiertes Modell die Vorsortierung günstiger erledigen als ein großes Modell mit langer Anweisung. Vorher lohnt aber der Versuch mit Anweisung und Beispielen, gemessen an einer Stichprobe echter Anfragen. Erst wenn die Fehlerquote dort nicht sinkt, ist Training der nächste Schritt.
Was beides kostet
Bei RAG fallen vor allem Kosten für das Einlesen und für die Modellaufrufe an. Das Umrechnen von Text in Embeddings kostet bei OpenAI 0,02 US-Dollar je Million Token mit dem kleinen und 0,13 US-Dollar mit dem großen Modell5. Dazu kommen Speicher, die Suche und mehr Eingabetoken je Frage, weil die Abschnitte mitgeschickt werden. Hinzu kommt die Arbeit an den Dokumenten selbst, die je nach Zustand der Ablage mehr kosten kann als die Technik.
Fine-Tuning kostet einmalig Training und danach meist höhere Preise je Anfrage als das Grundmodell. Laut der Preisseite von OpenAI kostet das Training von gpt-4.1-mini 5 US-Dollar je Million Trainingstoken, die Nutzung des nachtrainierten Modells danach 0,80 US-Dollar je Million Eingabe- und 3,20 US-Dollar je Million Ausgabetoken5. Gewichtiger als die Rechenzeit ist der Aufwand für die Trainingsdaten: Beispiele sammeln, bereinigen, prüfen. Und das Training ist an ein Grundmodell gebunden. Stellt der Anbieter es ein, endet auch die nachtrainierte Fassung. Bei OpenAI laufen nachtrainierte Modelle genau so lange, wie ihr Grundmodell angeboten wird4.
Zum Fine-Tuning gehört außerdem eine Prüfung, die Zeit kostet. Bevor ein nachtrainiertes Modell in den Betrieb geht, muss es auf einem Testsatz mindestens so gut abschneiden wie das Grundmodell mit guter Anweisung, und dieser Vergleich muss nach jedem neuen Training wiederholt werden. Bei Google wählst du außerdem die Größe des Zusatzteils, den sogenannten Adapter, in Stufen von 1 bis 16, bei Gemini 2.5 Pro von 1 bis 86. Solche Einstellungen wollen ausprobiert werden, und jeder Versuch kostet Rechenzeit.
Welche Daten ein Fine-Tuning braucht
Trainiert wird mit Beispielpaaren: eine Eingabe, wie sie im Alltag vorkommt, und die Antwort, die du dir wünschst. Die Beispiele sollten die echte Bandbreite abdecken, also auch unklare, unvollständige und seltene Fälle, und sie müssen in sich stimmig sein. Widersprechen sich zwei Beispiele, lernt das Modell den Widerspruch mit.
Einen Teil der Beispiele legst du beiseite und nutzt ihn nur zum Prüfen. Google sieht dafür einen eigenen Prüfsatz vor, der bis zu 5.000 Beispiele umfassen darf6. Wichtig ist außerdem die Frage, ob du die Daten überhaupt für Training verwenden darfst. Kundenmails, Gesprächsnotizen oder Personalunterlagen enthalten fast immer personenbezogene Angaben, und was einmal in den Gewichten steckt, lässt sich nur schwer gezielt wieder herauslösen. Bei RAG bleibt ein Dokument dagegen ein Dokument: Du kannst es löschen, und es taucht in keiner Antwort mehr auf.
Die Anbieterlage Ende 2026
OpenAI baut seine Plattform für Fine-Tuning ab. Seit dem 07.05.2026 können Organisationen, die nie Fine-Tuning genutzt haben, keine Trainingsaufträge mehr anlegen; ab dem 02.07.2026 verloren auch Organisationen ohne Nutzung eines nachtrainierten Modells in den letzten 60 Tagen den Zugang, und ab dem 06.01.2027 können auch aktive Bestandskunden keine neuen Aufträge mehr starten4. Bestehende nachtrainierte Modelle laufen weiter, bis ihr Grundmodell abgeschaltet wird4. Für gpt-4.1-mini, das Modell mit den genannten Preisen, ist das der 14.01.2027, nachtrainierte Fassungen folgen diesem Termin4. Die Preisseite vermerkt entsprechend, dass Fine-Tuning für neue Nutzer geschlossen ist5.
Google bietet überwachtes Nachtrainieren auf Vertex AI für mehrere Gemini-Modelle an, darunter Gemini 3.5 Flash und Gemini 3.5 Flash-Lite6. Daneben bleibt der Weg über Modelle mit offenen Gewichten, die du mit LoRA bei einem Cloud-Anbieter oder auf eigener Hardware nachtrainierst.
Für die Planung heißt das: Ein Projekt, das heute auf Fine-Tuning setzt, sollte von Anfang an festhalten, wie es bei einem Wechsel des Anbieters oder Grundmodells weitergeht. Ein RAG-Aufbau übersteht einen Modellwechsel leichter, weil Dokumente, Abschnitte und Suche bleiben; nur die Tests müssen neu laufen.
Mischformen
In anspruchsvollen Anwendungen arbeiten beide Verfahren zusammen. RAG liefert das Wissen, ein nachtrainiertes Modell sorgt für Format und Fachsprache. Eine andere Arbeitsteilung: Ein kleines, nachtrainiertes Modell sortiert Anfragen vor, und nur Fragen, die Wissen brauchen, gehen an das RAG-System mit einem größeren Modell.
Auch innerhalb von RAG hilft ein Sprachmodell an Stellen, die früher Training verlangt hätten. Beim Verfahren Contextual Retrieval schreibt ein Modell vor jeden Abschnitt einen kurzen Zusammenhang, was in Anthropics Tests den Anteil fehlgeschlagener Suchen deutlich senkte7. Wer mit RAG anfängt und erst bei nachgewiesenen Verhaltensproblemen Fine-Tuning ergänzt, hält den Aufwand klein.
Eigene KI trainieren lassen
Wer ein Modell nachtrainieren lässt, sollte vorher ein paar Punkte schriftlich klären: Wer stellt die Trainingsbeispiele zusammen und prüft sie? Dürfen die Daten überhaupt für Training verwendet werden, etwa bei Kundenkorrespondenz? Gegen welche Ausgangsmessung wird das Ergebnis verglichen? Wem gehören die trainierten Gewichte oder Zusatzteile, und lassen sie sich exportieren? Was passiert, wenn das Grundmodell eingestellt wird?
Ein seriöses Angebot beginnt mit einem einfachen Vergleich: Wie gut löst das Grundmodell mit guter Anweisung und RAG die Aufgabe? Kommt es schon nahe an das Ziel, ist Training selten das beste Mittel. Daran kannst du jeden KI-Dienstleister messen, auch SEO NW, das Unternehmen hinter diesem Blog, das solche Leistungen selbst anbietet. Einen Chatbot mit eigenem Wissen kannst du auch erst einmal selbst bauen.
Bevor du dich entscheidest
Die meisten Betriebe sollten mit RAG und guter Anweisung anfangen und Training erst bei nachgewiesenem Bedarf prüfen.
- Schreib auf, ob dem Modell Wissen fehlt oder ob es sich im Format oder Ton falsch verhält.
- Leg Testfälle mit erwarteten Antworten an und miss das Grundmodell mit guter Anweisung.
- Prüfe, ob deine Daten für Training verwendet werden dürfen, bevor du Beispiele sammelst.
- Frag bei jedem Trainingsangebot, was bei Einstellung des Grundmodells passiert.
Häufige Fragen
Was ist das Fine-Tuning eines Sprachmodells, einfach erklärt?
Fine-Tuning ist Nachtraining: Du zeigst einem fertigen Modell viele Beispiele mit Eingabe und gewünschter Antwort, und es passt seine Gewichte daran an. Danach trifft es Format, Ton oder eine enge Aufgabe zuverlässiger, auch mit kürzerer Anweisung.
Kann ich einem Modell per Fine-Tuning unsere Firmendaten beibringen?
Für Fakten, die sich ändern, und für Unterlagen mit Zugriffsrechten ist RAG besser geeignet. Das Modell bekommt dann bei jeder Frage die passenden Stellen und kann die Fundstelle nennen.
Ist RAG immer günstiger als Fine-Tuning?
Meist ist der Einstieg günstiger, weil kein Training nötig ist. Bei sehr vielen gleichartigen Anfragen kann ein kleines nachtrainiertes Modell im Betrieb billiger sein als ein großes Modell, das jedes Mal viel Kontext mitbekommt.
Gibt es bei OpenAI noch Fine-Tuning?
Nur noch für aktive Bestandskunden, und auch sie können ab dem 06.01.2027 keine neuen Trainingsaufträge mehr starten. Bereits trainierte Modelle laufen weiter, bis ihr Grundmodell abgeschaltet wird; bei gpt-4.1-mini ist das der 14.01.2027.
Quellen
Stand:
- arXiv: Lewis u. a.: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Stand 22.05.2020, abgerufen am 22.11.2026. zurück
- arXiv: Hu u. a.: LoRA: Low-Rank Adaptation of Large Language Models, Stand 17.06.2021, abgerufen am 22.11.2026. zurück
- OpenAI: Model optimization (API Docs), abgerufen am 22.11.2026. zurück
- OpenAI: Deprecations (Fine-Tuning-Plattform), Stand 07.05.2026, abgerufen am 22.11.2026. zurück
- OpenAI: API Pricing (Embeddings und Fine-Tuning), Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- Google Cloud: Tune Gemini models by using supervised fine-tuning (Vertex AI), abgerufen am 22.11.2026. zurück
- Anthropic: Introducing Contextual Retrieval, Stand 19.09.2024, abgerufen am 22.11.2026. zurück
- Anthropic: Structured outputs (Claude API Docs), abgerufen am 22.11.2026. zurück