Grundlagen
Mehr Kontext, schlechtere Antwort?
Kurzantwort
Das Kontextfenster ist der Text, den ein Sprachmodell bei einer Antwort gleichzeitig berücksichtigen kann, samt Verlauf, Dateien und der Antwort selbst4. Studien zeigen, dass Modelle Informationen am Anfang und am Ende langer Eingaben besser nutzen als in der Mitte und dass die Genauigkeit mit der Länge sinkt13. Lange Dokumente teilst du deshalb besser auf und stellst die Frage ans Ende5.
Moderne Sprachmodelle können Hunderttausende Token auf einmal aufnehmen, bei einigen Modellen von Anthropic sind es bis zu eine Million4. Gleich gut auswerten können sie diesen Text nicht. Anthropic schreibt selbst, dass mit wachsender Tokenzahl Genauigkeit und Erinnerungsvermögen nachlassen, und nennt das Phänomen Context Rot4. Wer lange Verträge, Protokolle oder Handbücher mit KI auswertet, fährt deshalb meist besser, wenn er nur das Nötige hineingibt und die Arbeit in Abschnitte teilt.
Was im Kontextfenster liegt
Das Kontextfenster ist eine Art Arbeitsgedächtnis. Es umfasst allen Text, auf den das Modell beim Erzeugen einer Antwort zugreifen kann, einschließlich der Antwort selbst4. Das Wissen aus dem Training steckt dagegen in den Gewichten des Modells. Im Fenster liegt, was in dieser einen Unterhaltung zusammenkommt: die Anweisungen des Anbieters, jede deiner Nachrichten, jede bisherige Antwort, hochgeladene Dateien und Bilder4. Gemessen wird in Token, also in den Textstücken, aus denen ein Sprachmodell seine Antworten zusammensetzt.
Bei jeder neuen Nachricht wird der ganze bisherige Verlauf wieder mitgeschickt. Das Fenster füllt sich darum mit jeder Runde, auch wenn du nur kurze Fragen stellst. Ist es voll, müssen ältere Teile weichen. Chat-Oberflächen wie claude.ai können den Verlauf nach dem Prinzip "zuerst hinein, zuerst hinaus" verwalten4. Was am Anfang eines langen Chats stand, ist dann für das Modell schlicht nicht mehr da.
Wie groß das Fenster ist, hängt von Modell und Tarif ab. Für ChatGPT nennt OpenAI auf seiner Preisseite ein Kontextfenster von 27.000 Token für das schnelle Modell im kostenlosen Tarif, 54.000 Token in den Tarifen Go und Plus und 128.000 Token in Pro. Die Modelle mit längerem Nachdenken kommen in Go und Plus auf 256.000 Token, in Pro auf 400.000 Token6. Bei Anthropic haben die aktuellen Modelle in der Programmierschnittstelle ein Fenster von einer Million Token, ältere 200.000 Token4. Wie viel Platz dein eigener Text braucht, kannst du mit dem Token-Zähler abschätzen. Daneben begrenzen die Tarife auch die Zahl der Nachrichten, mehr dazu bei den Nutzungslimits.
Warum die Mitte verloren geht
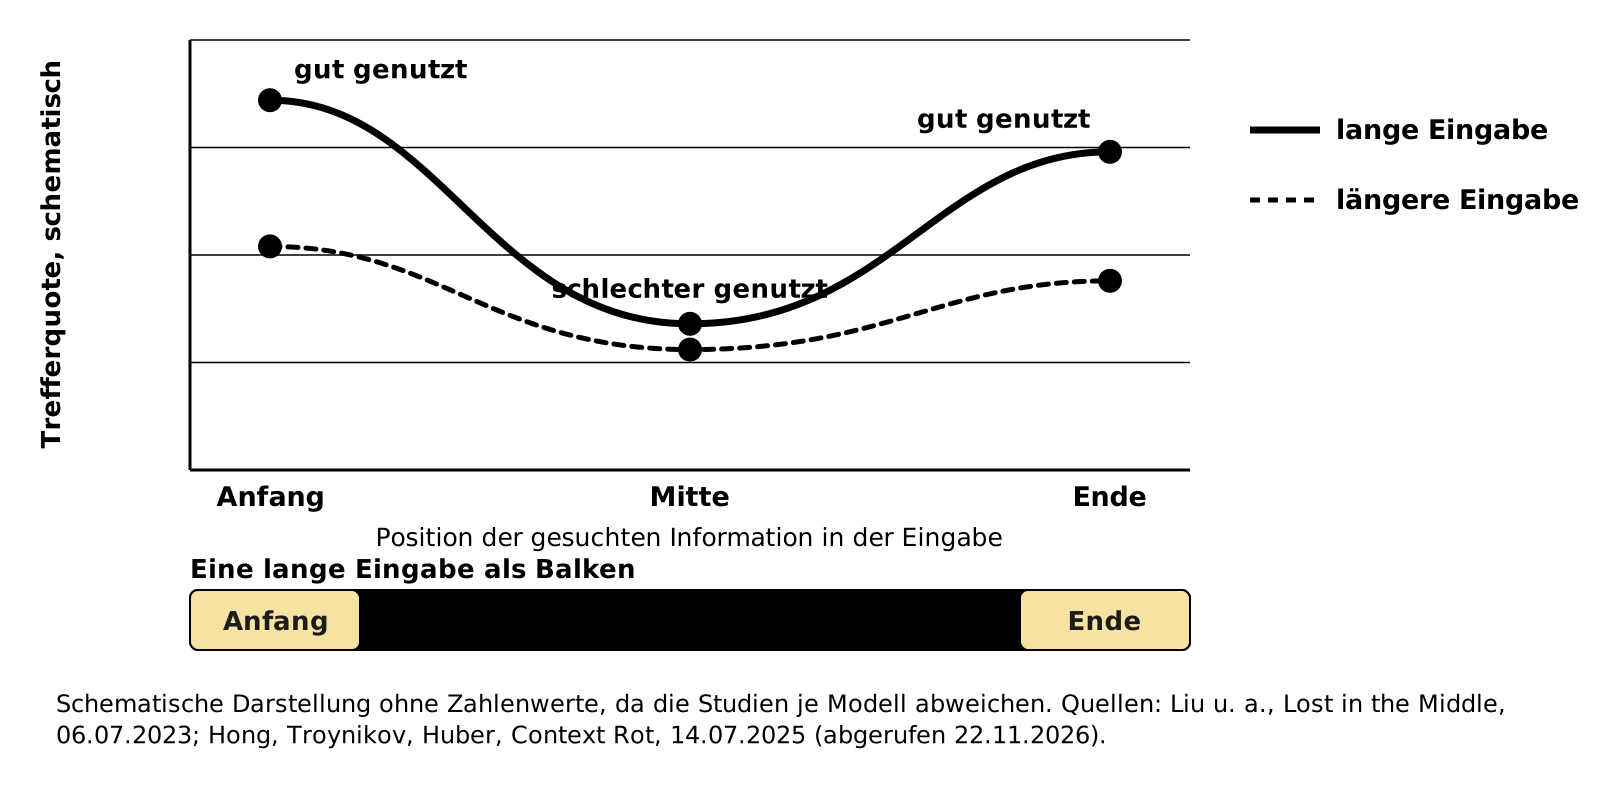
- Anfang gut genutzt
- Mitte schlechter genutzt
- Ende gut genutzt
- längere Eingabe insgesamt schwächer
Eine Untersuchung einer Gruppe um Nelson F. Liu erschien im Juli 2023 unter dem Titel "Lost in the Middle"1. Die Forschenden gaben Sprachmodellen viele Dokumente, von denen nur eines die Antwort enthielt, und verschoben dieses eine Dokument von vorn nach hinten. Die Ergebnisse waren am besten, wenn die relevante Stelle am Anfang oder am Ende der Eingabe stand, und deutlich schlechter, wenn sie in der Mitte lag1. Das galt auch für Modelle, die ausdrücklich für lange Texte gebaut waren1. Aufgetragen ergibt das eine Kurve in U-Form. Getestet wurde mit zwei Aufgaben: Fragen, deren Antwort in einem von vielen Dokumenten steckt, und dem Heraussuchen eines Werts zu einem Schlüssel aus einer langen Liste solcher Paare1. Beide Aufgaben ähneln dem, was du im Alltag mit einem langen Dokument tust, wenn du nach einer bestimmten Klausel oder Zahl fragst.
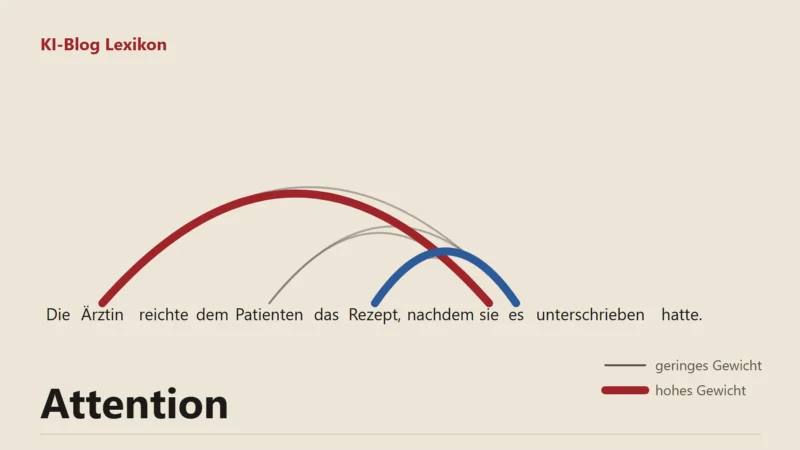
Eine mögliche Erklärung liegt im Mechanismus, mit dem Modelle Text gewichten, der Attention. Anthropic beschreibt sie als begrenztes Aufmerksamkeitsbudget: Bei n Token entstehen n² Beziehungen zwischen ihnen, und mit wachsendem Kontext verteilt sich die Aufmerksamkeit immer dünner7. Warum gerade die Mitte leidet, ist in der Forschung nicht abschließend geklärt. Für die Praxis reicht die Beobachtung, dass Anfang und Ende einer Eingabe mehr Gewicht bekommen.
Mehr Text, schwächere Antworten
Spätere Arbeiten haben das Bild erweitert. Der Benchmark RULER einer Gruppe um Cheng-Ping Hsieh prüfte im April 2024 insgesamt 17 Modelle, die alle ein Fenster von mindestens 32.000 Token versprachen2. Den einfachen Test, bei dem eine einzelne Angabe in einem langen Text versteckt ist, bestanden fast alle nahezu fehlerfrei. Bei anspruchsvolleren Aufgaben wie mehreren versteckten Angaben, Verkettungen und Zusammenfassungen brachen die Leistungen mit wachsender Länge ein; bei 32.000 Token hielt nur etwa die Hälfte der Modelle ein zufriedenstellendes Niveau2.
Die Firma Chroma veröffentlichte im Juli 2025 einen Bericht über 18 Modelle, darunter GPT-4.1, Claude 4 und Gemini 2.53. Auch bei einfachen Aufgaben wurden die Ergebnisse mit wachsender Eingabelänge unzuverlässiger. Besonders schnell ging es bergab, wenn Frage und gesuchte Stelle wenig wörtliche Ähnlichkeit hatten, und wenn ähnlich klingende, aber unpassende Abschnitte im Text standen3. Schon ein einziger solcher Ablenker senkte die Leistung, vier senkten sie weiter3. Überraschend fanden die Forschenden, dass Modelle in einem Text mit zufällig gemischten Sätzen besser abschnitten als in einem zusammenhängenden3. Unterschiede zeigten sich auch im Umgang mit Unsicherheit: Die Claude-Modelle erfanden in diesen Tests am seltensten etwas und verzichteten bei Zweifeln eher auf eine Antwort3. Wer weniger Ablenker in die Eingabe packt, senkt also auch das Risiko erfundener Antworten.
Ein Dokument, das ins Fenster passt, ist damit noch nicht sicher ausgewertet. Und unnötiger Text schadet: Alte Entwürfe, doppelte Anhänge oder lange Vorgeschichten im Chat sind genau die Ablenker, die in den Tests die Leistung drückten. Wie lange Kontexte auf lokalen Modellen abschneiden, soll unser Praxistest zu langen Kontexten zeigen.
Lange Dokumente aufteilen
Aus den Studien oben ergibt sich für lange Unterlagen ein Vorgehen in Etappen:
- Teile das Dokument in sinnvolle Abschnitte, etwa nach Kapiteln, Paragrafen oder Monaten. Fachleute nennen das Chunking.
- Lass jeden Abschnitt einzeln bearbeiten, zum Beispiel zusammenfassen oder nach bestimmten Angaben durchsuchen. Bitte dabei um wörtliche Zitate mit Fundstelle.
- Sammle die Teilergebnisse und lass sie in einem neuen Schritt zusammenführen. So arbeitet das Modell am Ende mit einem kurzen, dichten Text.
- Prüf die zitierten Stellen im Original, bevor du dich auf das Ergebnis verlässt.
Wenn du das Dokument doch in einem Stück übergibst, hilft die Reihenfolge. Anthropic empfiehlt, lange Dokumente an den Anfang der Eingabe zu stellen und Frage und Anweisungen ans Ende; in Tests habe das die Antwortqualität um bis zu 30 Prozent verbessert, vor allem bei komplexen Eingaben aus mehreren Dokumenten5. Mehrere Dokumente kennzeichnest du am besten klar voneinander getrennt mit Titel und Herkunft5. Außerdem rät Anthropic, das Modell zuerst die relevanten Stellen zitieren zu lassen und erst danach die eigentliche Aufgabe zu stellen5.
Wer regelmäßig mit großen Dokumentensammlungen arbeitet, etwa einem Betrieb mit vielen Handbüchern, kommt mit Aufteilen von Hand nicht weit. Dort übernimmt ein Suchsystem die Auswahl: Es holt zu jeder Frage nur die passenden Abschnitte ins Kontextfenster. Das Verfahren heißt RAG; ein RAG-System im Betrieb lohnt sich vor allem, wenn dieselben Unterlagen immer wieder befragt werden.
Kontextfenster, Gedächtnis und Projekte
Viele Chatbots bieten inzwischen ein Gedächtnis oder Projektordner an, in denen Vorlieben, frühere Gespräche oder Dateien hinterlegt sind. Das wirkt, als würde sich das Modell dauerhaft erinnern. Nutzen kann das Modell solche Inhalte aber nur, wenn sie wieder im Kontextfenster landen; Anthropic beschreibt das für Notizen, die ein Agent außerhalb des Fensters ablegt und später zurückholt7. Dort belegen sie Platz und konkurrieren mit deinem eigentlichen Text um Aufmerksamkeit.
Halte gespeicherte Hinweise deshalb kurz und lösche, was nicht mehr stimmt. Ein Projektordner mit zwanzig alten Entwürfen kann eine Antwort eher verschlechtern als verbessern, weil er Ablenker liefern kann, wie sie in den Tests von Chroma die Leistung senkten3.
Was im Chat konkret hilft
Auch ohne Dokumente füllt sich das Fenster, wenn eine Unterhaltung lange läuft. Ein paar Gewohnheiten halten es übersichtlich:
- Beginne für ein neues Thema einen neuen Chat, statt alles in einer Unterhaltung zu stapeln.
- Fass nach einer langen Arbeitsphase die Ergebnisse zusammen und nimm nur diese Zusammenfassung in einen frischen Chat mit.
- Wiederhole wichtige Vorgaben wie Zielgruppe, Länge oder Ausschlüsse kurz vor der eigentlichen Bitte, statt dich auf eine Nachricht vom Anfang zu verlassen.
- Lade nur die Seiten oder Kapitel hoch, die du wirklich brauchst.
Dieselben Regeln gelten, wenn du Texte, PDFs oder Videos zusammenfassen lässt: lieber mehrere Durchgänge mit kurzen Abschnitten als ein einziger mit dem ganzen Material.
Was das für dich heißt
Ein großes Kontextfenster ersetzt keine Auswahl, weniger und passender Text bringt meist die genauere Antwort.
- Stell lange Dokumente an den Anfang und deine Frage ans Ende der Eingabe.
- Teile umfangreiche Unterlagen in Kapitel und lass jedes einzeln bearbeiten.
- Lass dir zu jeder Aussage die Stelle im Dokument zitieren und prüf sie nach.
- Beginne für neue Themen einen neuen Chat und nimm nur eine kurze Zusammenfassung mit.
Häufige Fragen
Wie groß ist das Kontextfenster von ChatGPT?
Das hängt von Tarif und Modell ab. Im kostenlosen Tarif ist das Fenster am kleinsten, in Pro und bei den Modellen mit längerem Nachdenken am größten; die genauen Werte nennt OpenAI auf seiner Preisseite.
Vergisst ChatGPT den Anfang eines langen Chats?
Wenn das Fenster voll ist, können ältere Teile herausfallen, und auch innerhalb des Fensters wird die Mitte schlechter genutzt. Wichtige Vorgaben solltest du in langen Chats deshalb wiederholen.
Kann ich ein ganzes Buch in die KI laden?
Bei Modellen mit sehr großem Fenster passt ein Buch technisch hinein. Für genaue Fragen zu Einzelheiten ist es trotzdem besser, Kapitel einzeln zu bearbeiten oder nach den passenden Stellen zu suchen.
Ist ein größeres Kontextfenster immer besser?
Es erlaubt mehr Material auf einmal, macht die Auswertung aber nicht automatisch genauer. Weniger und gut ausgewählter Text führt oft zu besseren Antworten.
Quellen
Stand:
- arXiv (Liu u. a.): Lost in the Middle: How Language Models Use Long Contexts, Stand 06.07.2023, abgerufen am 22.11.2026. zurück
- arXiv (Hsieh u. a.): RULER: What's the Real Context Size of Your Long-Context Language Models?, Stand 09.04.2024, abgerufen am 22.11.2026. zurück
- Chroma (Hong, Troynikov, Huber): Context Rot: How Increasing Input Tokens Impacts LLM Performance, Stand 14.07.2025, abgerufen am 22.11.2026. zurück
- Anthropic: Context windows, abgerufen am 22.11.2026. zurück
- Anthropic: Prompting best practices: Long context prompting, abgerufen am 22.11.2026. zurück
- OpenAI: ChatGPT Preise (Gesamt-Kontextfenster je Tarif), abgerufen am 22.11.2026. zurück
- Anthropic: Effective context engineering for AI agents, Stand 29.09.2025, abgerufen am 22.11.2026. zurück