Lexikon · B
Backpropagation
Kurzantwort
Wenn ein neuronales Netz danebenliegt, rechnet Backpropagation aus, wie viel jedes einzelne Gewicht zu diesem Fehler beigetragen hat1. Die Rechnung läuft dazu von der Ausgabe rückwärts durch die Schichten und stützt sich auf die Kettenregel der Differentialrechnung1. Mit den Ergebnissen verschiebt anschließend ein Optimierungsverfahren die Gewichte12.
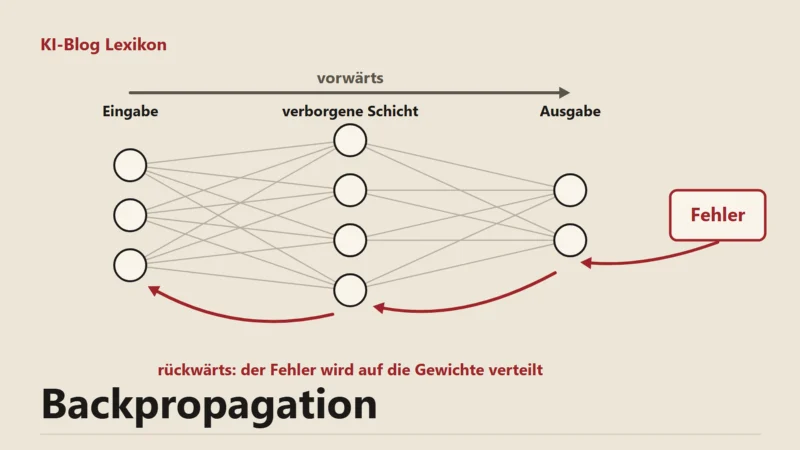
Backpropagation, auf Deutsch Fehlerrückführung, beantwortet beim Training eines neuronalen Netzes eine Frage: Welche Verbindung hat wie stark an einer falschen Antwort mitgewirkt? Meldet das Netz auf einem Katzenfoto "Hund", steckt der Grund irgendwo zwischen Tausenden Verbindungen, und keine davon ist allein schuld. Erst mit der Antwort auf diese Frage kann das Netz gezielt nachjustieren.
Vorwärts rechnen, rückwärts zuordnen
Jeder Trainingsschritt hat zwei Richtungen. Im Vorwärtsdurchlauf wandern die Eingabedaten Schicht für Schicht zur Ausgabe, am Ende steht ein einzelner Kostenwert, der den Fehler misst. Backpropagation lässt diese Information dann rückwärts durch das Netz fließen und berechnet daraus den Gradienten1. Der Gradient sagt für jedes Gewicht, in welche Richtung und wie steil sich der Fehler ändert, wenn man an diesem Gewicht dreht.
Mathematisch steckt dahinter die Kettenregel, die im 17. Jahrhundert entstand (Leibniz 1676, L'Hôpital 1696)1. Jede Schicht erhält von der Schicht hinter ihr den Wert, wie empfindlich der Fehler auf ihre Ausgabe reagiert, multipliziert ihn mit ihrer eigenen Ableitung und reicht das Ergebnis weiter nach vorn. Der analytische Ausdruck für den Gradienten wäre leicht hinzuschreiben, ihn Zahl für Zahl auszuwerten aber teuer. Backpropagation erledigt das mit einem einfachen und günstigen Verfahren1. Als Quelle für den Algorithmus nennt das Lehrbuch "Deep Learning" (Goodfellow, Bengio, Courville) eine Arbeit, die David Rumelhart, Geoffrey Hinton und Ronald Williams im Oktober 1986 in der Zeitschrift Nature veröffentlichten14.
Gradient berechnen ist noch kein Lernen
Oft wird das Wort für das ganze Lernverfahren mehrschichtiger Netze benutzt. Genau genommen liefert Backpropagation nur die Gradienten. Die Gewichte verschiebt ein zweites Verfahren, etwa der stochastische Gradientenabstieg1. Nach dem Crash Course von Google macht Backpropagation den Gradientenabstieg für Netze mit mehreren Schichten überhaupt erst praktikabel2. Das Lehrbuch weist außerdem darauf hin, dass sich das Verfahren auf beliebige ableitbare Funktionen anwenden lässt und keineswegs auf neuronale Netze beschränkt ist1.
Was die Bibliothek für dich erledigt
Die Rückwärtsrechnung musst du nicht selbst programmieren: Keras übernimmt sie automatisch2. In PyTorch zeichnet das Modul Autograd jede Rechenoperation in einem gerichteten Graphen auf. Ein Aufruf von `loss.backward()` auf dem Fehlerwert startet den Rückwärtsdurchlauf, Autograd wendet entlang des Graphen die Kettenregel an und legt für jeden Parameter den Gradienten im Attribut `.grad` ab3. Bei jedem Durchlauf baut PyTorch den Graphen neu auf3.
Wenn Gradienten verschwinden oder explodieren
In tiefen Netzen wird die Kette der Multiplikationen lang. Google beschreibt drei Störungen, die beim Training solcher Netze auftreten2. Werden die Gradienten auf dem Weg zu den vorderen Schichten immer kleiner, lernen diese Schichten sehr langsam oder gar nicht mehr; eine ReLU als Aktivierungsfunktion kann das verhindern. Sehr große Gewichte lassen die Gradienten dagegen so stark wachsen, dass das Training nicht mehr zur Ruhe kommt. Hier helfen Batch Normalization oder eine kleinere Lernrate. Der dritte Fall sind tote ReLU-Einheiten, die nur noch null ausgeben und keinen Gradienten mehr durchlassen2.
Häufige Fragen
Wer hat Backpropagation erfunden?
Muss ich Backpropagation selbst programmieren?
Läuft Backpropagation auch, wenn ich ein fertiges Modell benutze?
Bei einer gewöhnlichen Anfrage an ein fertiges Modell rechnet nur der Vorwärtsdurchlauf, die Gewichte bleiben unverändert. Rückwärts gerechnet wird erst wieder, wenn das Modell weiter trainiert wird, zum Beispiel beim Fine-Tuning.
Quellen
Stand:
- Goodfellow, Bengio, Courville: Deep Learning, Kapitel 6: Deep Feedforward Networks, Stand 2016, abgerufen am 22.11.2026. zurück
- Google for Developers: Machine Learning Crash Course: Neural networks, Backpropagation, abgerufen am 22.11.2026. zurück
- PyTorch: A Gentle Introduction to torch.autograd, Stand 01.10.2025, abgerufen am 22.11.2026. zurück
- Nature (Rumelhart, Hinton, Williams): Learning representations by back-propagating errors, Band 323, Heft 6088, Seiten 533 bis 536, Stand 10/1986, abgerufen am 22.11.2026. zurück