Lexikon · D
Data Augmentation
Kurzantwort
Data Augmentation erzeugt aus vorhandenen Trainingsbeispielen zusätzliche Varianten, etwa gedrehte, gespiegelte oder aufgehellte Bilder, und erhöht so die Vielfalt eines Trainingsdatensatzes1. Die Antwort zu jedem Beispiel bleibt dabei gleich, neue Information über die Welt kommt nicht hinzu.
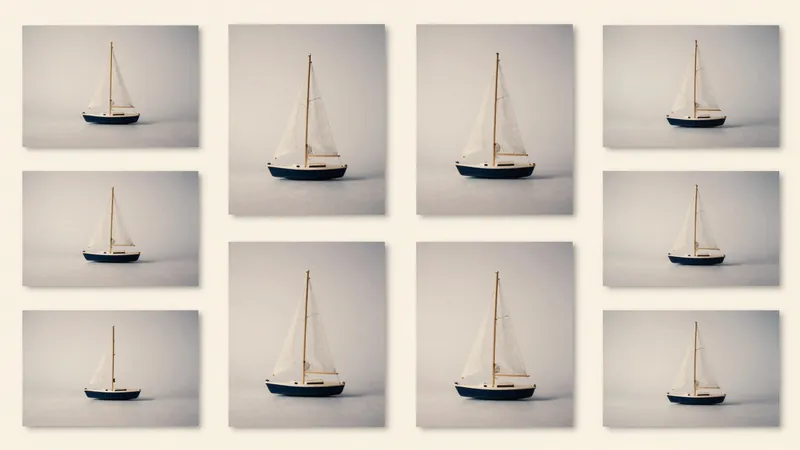
Das TensorFlow-Tutorial zu dieser Technik beschreibt Data Augmentation als zufällige, aber realistische Veränderungen, die die Vielfalt der Trainingsdaten erhöhen, und arbeitet mit einem Datensatz aus Blumenfotos1. Ein Tulpenfoto, gespiegelt, um ein paar Grad gedreht und etwas aufgehellt, ergibt so drei zusätzliche Trainingsbeispiele, auf denen weiterhin eine Tulpe zu sehen ist. Das Modell lernt daran, dass Lage und Helligkeit nichts an der Antwort ändern.
Typische Veränderungen bei Bildern
Für die Computer Vision bringt die Bibliothek Keras fertige Schichten mit, die Bilder zufällig spiegeln, drehen, zoomen, zuschneiden oder ihren Kontrast ändern. Dazu kommen Funktionen, die Bilder in Graustufen umwandeln, Sättigung und Helligkeit verschieben, die Mitte ausschneiden oder um 90 Grad drehen. Für Zufallsvarianten zählt das Tutorial acht Operationen auf, darunter zufällige Farbtöne und eine schwankende JPEG-Qualität1. Weil die Varianten bei jedem Durchlauf neu ausgewürfelt werden, sieht das Modell kaum zweimal dasselbe Bild. Die Schichten lassen sich direkt ins Modell einbauen und laufen dann auf der Grafikkarte mit, oder sie bereiten die Daten vorab auf dem Prozessor auf1.
Wer die Veränderungen auswählt, muss wissen, wie die Bilder im Einsatz aussehen werden. Ein gespiegeltes Verkehrsschild steht an keiner Straße, und eine handgeschriebene 6 wird, um 180 Grad gedreht, zur 9. Eine Variante, die in der Wirklichkeit nie vorkommt, kostet Rechenzeit und kann das Modell sogar verwirren.
Nur im Training
Das Tutorial hält fest, dass Data Augmentation nur auf die Trainingsdaten angewendet werden soll. Die entsprechenden Schichten sind beim Testen und bei Vorhersagen abgeschaltet und verändern Bilder nur während des Trainings1. Validierungs- und Testdaten aus der Aufteilung der Trainingsdaten bleiben unverändert, damit sie zeigen, wie das Modell mit echten Aufnahmen umgeht.
Bei kleinen Datensätzen neigt ein Modell dazu, sich einzelne Bilder samt ihrer Zufälligkeiten einzuprägen. Zusätzliche Vielfalt kann diesem Overfitting entgegenwirken.
Texte und automatisch gesuchte Regeln
Auch Texte lassen sich abwandeln. Jason Wei und Kai Zou stellten 2019 vier einfache Operationen vor: Wörter durch Synonyme ersetzen, zufällig Wörter einfügen, Wörter vertauschen und Wörter löschen. Über fünf Datensätze gemittelt erreichte eine Textklassifikation mit diesen Varianten und nur der Hälfte der Trainingsdaten dieselbe Genauigkeit wie normales Training mit allen Daten2. Bei Texten ist die Grenze schneller erreicht als bei Bildern, denn ein vertauschtes oder gelöschtes Wort kann den Sinn umdrehen.
Welche Veränderungen in welcher Stärke helfen, muss niemand mehr allein von Hand festlegen. AutoAugment suchte 2018 automatisch nach guten Kombinationen aus jeweils zwei Operationen wie Verschieben, Drehen oder Scheren. Auf ImageNet kam ein Modell damit auf eine Top-1-Genauigkeit von 83,5 Prozent, 0,4 Prozentpunkte über dem bisherigen Bestwert, und die gefundenen Regeln ließen sich auf andere Datensätze übertragen3.
Entstehen die Beispiele dagegen von Grund auf neu, etwa in einer Simulation oder durch ein generatives Modell, spricht man von synthetischen Daten.
Häufige Fragen
Wie viele Varianten pro Bild sind sinnvoll?
Bei den üblichen Werkzeugen entsteht in jedem Trainingsdurchlauf eine neue Zufallsvariante, eine feste Zahl gibt es also nicht. Wichtiger als die Menge ist, dass jede Veränderung im echten Einsatz vorkommen könnte.
Ersetzt Data Augmentation fehlende Daten?
Nur zum Teil. Sie macht ein Modell robuster gegen Schwankungen der vorhandenen Beispiele, bringt ihm aber nichts bei, was im Datensatz gar nicht vorkommt, etwa eine fehlende Klasse oder eine fremde Sprache.
Quellen
Stand:
- TensorFlow: Data augmentation (Tutorial), abgerufen am 22.11.2026. zurück
- arXiv (Wei, Zou): EDA: Easy Data Augmentation Techniques for Boosting Performance on Text Classification Tasks, Stand 31.01.2019, abgerufen am 22.11.2026. zurück
- arXiv (Cubuk u. a.): AutoAugment: Learning Augmentation Policies from Data, Stand 24.05.2018, abgerufen am 22.11.2026. zurück