Lexikon · F
F1-Score
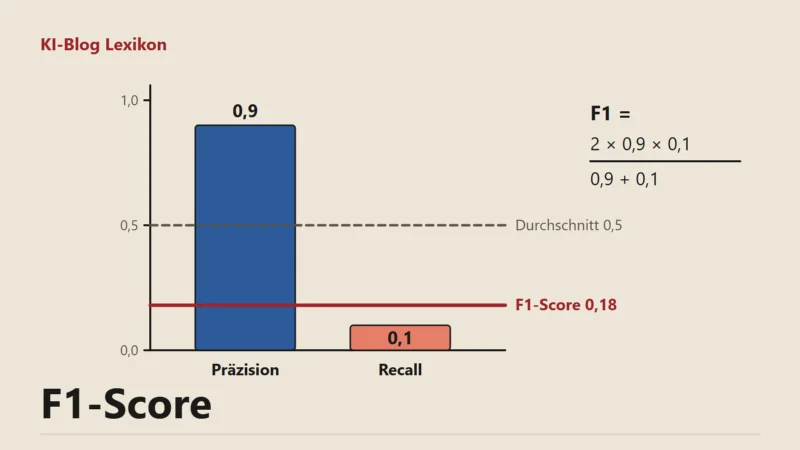
Angenommen, ein Modell findet 90 Prozent aller gesuchten Fälle, aber nur jede zehnte seiner Meldungen stimmt. Der gewöhnliche Durchschnitt aus 0,9 und 0,1 ergibt 0,5 und klingt nach Mittelmaß. Der F1-Score liegt bei 0,18 und zeigt deutlicher, dass dieses Modell im Alltag kaum zu gebrauchen ist.
Wie sich der Wert berechnet
Grundlage sind die beiden Maße Präzision und Recall. Der F1-Score ist ihr harmonisches Mittel: zwei mal Präzision mal Recall, geteilt durch die Summe aus Präzision und Recall3. Direkt aus den Zählwerten geht es ebenfalls, nämlich zweimal die richtig positiven Fälle, geteilt durch zweimal die richtig positiven plus die falsch positiven plus die falsch negativen1. Die richtig negativen Fälle kommen in dieser Rechnung nicht vor. Andere Namen sind F-Maß oder F-Measure1.
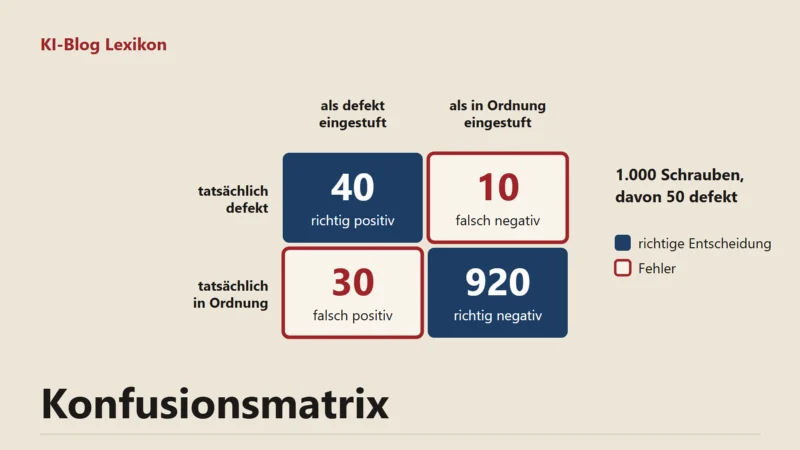
Mit dem Spamfilter aus dem Eintrag zu Präzision und Recall sieht die Rechnung so aus: 40 richtig erkannte Spams, 5 fälschlich aussortierte echte Mails und 10 durchgerutschte Spams. Zweimal 40 sind 80, geteilt durch 80 plus 5 plus 10 ergibt das rund 0,84. Die drei Zählwerte stammen aus den Feldern der Konfusionsmatrix; das vierte Feld, die richtig negativen Fälle, bleibt außen vor.
Warum das harmonische Mittel
Das harmonische Mittel liegt immer nahe am kleineren der beiden Werte. Ein glänzender Recall gleicht eine schwache Präzision deshalb kaum aus, und umgekehrt gilt dasselbe. Für den Vergleich mehrerer Modelle ist das praktisch, weil eine einzige Zahl beide Fehlerarten berücksichtigt. Google empfiehlt den F1-Score bei unausgewogenen Datensätzen gegenüber der Accuracy2.
Präzision und Recall gehen gleich stark ein1. Ist eine Fehlerart teurer, gibt es den allgemeineren F-Beta-Wert: Ein Beta über 1 gewichtet den Recall stärker, ein Beta unter 1 die Präzision3. In scikit-learn hat er eine eigene Funktion.
Varianten bei mehreren Klassen
Bei mehreren Klassen wird der F1-Score je Klasse berechnet und dann gemittelt. Die Dokumentation von scikit-learn nennt dafür drei übliche Wege1. "macro" bildet den einfachen Mittelwert und behandelt seltene Klassen wie häufige. "weighted" gewichtet nach der Zahl der echten Fälle je Klasse. "micro" zählt zuerst alle Treffer und Fehler über alle Klassen zusammen. Welche Variante in einem Bericht steht, verändert das Ergebnis spürbar: Im Beispiel der Dokumentation ergeben dieselben Vorhersagen 0,27 mit macro und 0,33 mit micro1.
Was der Wert verschweigt
Eine einzelne Zahl verdeckt, welcher der beiden Werte schwach ist. Ein F1-Score von 0,6 kann aus zwei ausgeglichenen Werten entstehen oder aus einem guten Recall mit mäßiger Präzision. Für die Wahl der Schwelle im Einsatz brauchst du deshalb beide Einzelwerte. Peter Christen, David Hand und Nishadi Kirielle halten das Maß in einem 2023 online erschienenen Übersichtsartikel für theoretisch schwach begründet und kritisieren, dass es eine Klasse besonders betont4. Entstanden ist es im Information Retrieval, also bei der Bewertung von Suchsystemen4.
Häufige Fragen
Ist ein F1-Score von 0,8 gut?
Das hängt von der Aufgabe und vom Vergleichswert ab. Für einen Spamfilter kann 0,8 zu wenig sein, bei der Suche nach seltenen Fehlern in Maschinendaten ein ordentlicher Wert.
Warum fehlen die richtig negativen Fälle in der Formel?
Was gilt, wenn es weder Treffer noch Fehler gibt?
Enthalten Daten und Vorhersagen nur negative Fälle, ist der F1-Score nicht definiert. scikit-learn setzt ihn dann standardmäßig auf 0 und gibt eine Warnung aus1.
Quellen
Stand:
- scikit-learn: f1_score (Version 1.9.1), abgerufen am 22.11.2026. zurück
- Google for Developers: Machine Learning Crash Course: Classification, Accuracy, recall, precision, and related metrics, abgerufen am 22.11.2026. zurück
- scikit-learn: Metrics and scoring: quantifying the quality of predictions (Version 1.9.1), abgerufen am 22.11.2026. zurück
- ACM Computing Surveys (Christen, Hand, Kirielle): A review of the F-measure: its history, properties, criticism, and alternatives, Stand 03/2024, abgerufen am 22.11.2026. zurück