Lexikon · A
Accuracy
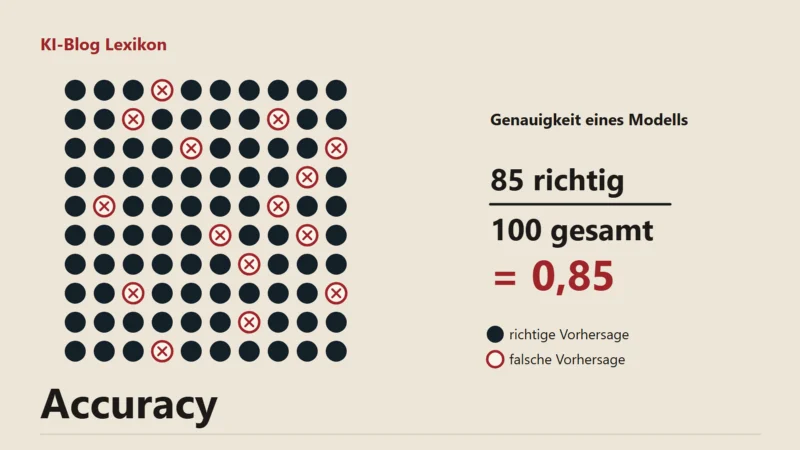
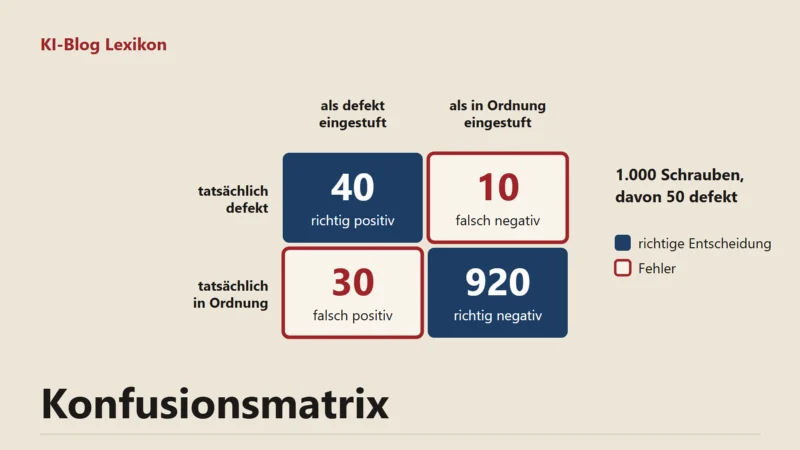
Im Deutschen heißt die Kennzahl auch Genauigkeit oder Korrektklassifikationsrate. Man zählt, wie oft ein Klassifikator richtig lag, und teilt durch die Zahl aller Fälle. Google schreibt die Rechnung in seinem Einsteigerkurs mit den vier Feldern der Konfusionsmatrix: richtig positive plus richtig negative Fälle, geteilt durch die Summe aller vier Felder1. Die Funktion accuracy_score aus scikit-learn liefert genau diesen Anteil, auf Wunsch auch die bloße Zahl der Treffer2.
So rechnest du sie aus
Ein kleines Rechenbeispiel aus der Fertigung: Ein Modell soll Fotos von Werkstücken als "in Ordnung" oder "fehlerhaft" einstufen. Von 200 Fotos ordnet es 170 richtig ein und 30 falsch. Die Accuracy beträgt 170 geteilt durch 200, also 0,85 oder 85 Prozent. Welche Fälle danebenliegen, spielt für diese Zahl keine Rolle: Ein übersehenes fehlerhaftes Teil zählt genauso wie ein gutes, das grundlos aussortiert wurde.
Der Wert liegt zwischen 0 und 1. Er taugt, solange die Klassen ungefähr gleich groß sind und beide Fehlerarten ähnlich viel kosten. Google empfiehlt Accuracy bei ausgewogenen Datensätzen als grobe Anzeige, ob ein Modell beim Training Fortschritte macht1.
Warum seltene Fälle die Zahl verzerren
Angenommen, nur eine von hundert Überweisungen ist Betrug. Ein Modell, das grundsätzlich "kein Betrug" meldet, liegt in 99 von 100 Fällen richtig und kommt auf eine Accuracy von 99 Prozent, ohne je einen Betrugsfall gefunden zu haben. Google beschreibt genau diese Falle für einen Datensatz, in dem ein Prozent der Fälle positiv ist, und rät bei unausgewogenen Daten von Accuracy ab1.
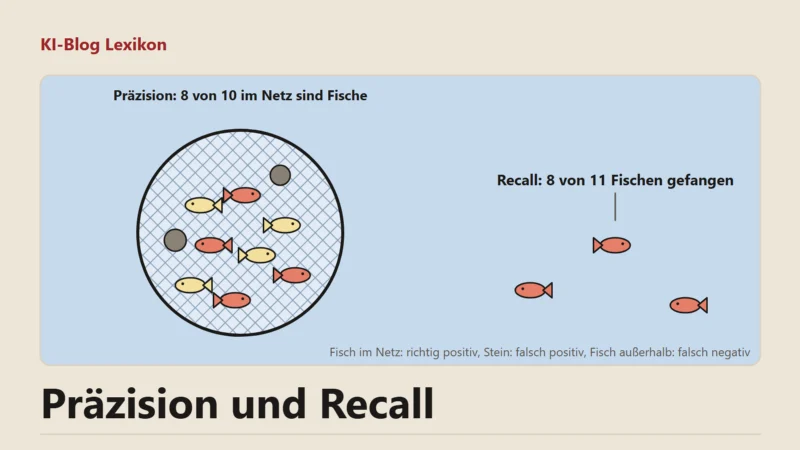
Solche Schieflagen sind die Regel, sobald eine Maschine nach etwas Seltenem sucht, etwa nach Ausschuss in der Fertigung oder nach Angriffen im Netzwerkverkehr. Dann braucht es Maße, die getrennt auf die gesuchte Klasse schauen. Zwei davon sind Präzision und Recall: Die Präzision prüft, wie oft ein Alarm stimmt, der Recall, wie viele der echten Fälle das Modell findet. In der Anomalieerkennung ist das Problem besonders ausgeprägt, weil Ausreißer dort per Definition selten sind.
Was neben der reinen Accuracy hilft
Eine einfache Gegenprobe ist der Vergleich mit einem Modell, das immer die häufigste Klasse nennt. Liegt das eigene Modell kaum darüber, hat es wenig gelernt. scikit-learn bietet außerdem die Balanced Accuracy an, den Mittelwert der Trefferquoten aller Klassen2. Bei ausgewogenen Daten entspricht sie der gewöhnlichen Accuracy2. Im Betrugsbeispiel fällt sie auf 0,5, weil die Betrugsklasse mit einer Trefferquote von null eingeht.
Eine hohe Accuracy auf den Trainingsdaten sagt wenig, wenn das Modell sie auswendig gelernt hat. Aussagekräftig sind Daten, die beim Training nicht vorkamen, oft im Wechsel über mehrere Teilmengen wie bei der Kreuzvalidierung. Bietet dir zum Beispiel jemand ein Modell mit "98 Prozent Genauigkeit" an, frag nach der Verteilung der Klassen und danach, welche Fehler in den restlichen zwei Prozent stecken.
Häufige Fragen
Ist Accuracy dasselbe wie Präzision?
Nein. Accuracy bewertet alle Entscheidungen zusammen, die Präzision nur die Fälle, die das Modell als positiv gemeldet hat. Weil beide Wörter im Deutschen manchmal mit "Genauigkeit" übersetzt werden, lohnt ein Blick auf die Formel.
Ab welchem Wert ist eine Accuracy gut?
Eine feste Grenze gibt es nicht. Vergleiche den Wert mit einem Modell, das stur die häufigste Klasse wählt, und mit dem, was dein Einsatz an Fehlern verträgt.
Gibt es Accuracy auch bei mehr als zwei Klassen?
Ja, die Rechnung bleibt gleich: richtige Zuordnungen geteilt durch alle Fälle. Hat ein Fall mehrere Labels, zählt scikit-learn ihn nur dann als richtig, wenn alle Labels stimmen2.
Quellen
Stand:
- Google for Developers: Machine Learning Crash Course: Classification, Accuracy, recall, precision, and related metrics, abgerufen am 22.11.2026. zurück
- scikit-learn: Metrics and scoring: quantifying the quality of predictions (Version 1.9.1), abgerufen am 22.11.2026. zurück