Lexikon · P
Präzision und Recall
Kurzantwort
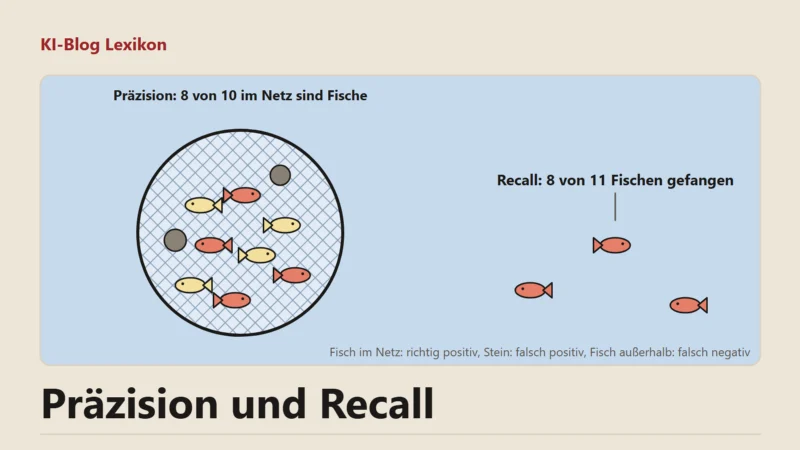
Die Präzision (englisch Precision) gibt an, wie viele der Fälle, die ein Modell als Treffer meldet, wirklich Treffer sind. Der Recall gibt an, wie viele der tatsächlich vorhandenen Treffer das Modell überhaupt findet12. Beide Werte reichen von 0 bis 1 und lassen sich meist nur auf Kosten des anderen verbessern1.
Ein Spamfilter kann auf zwei Arten danebenliegen. Er schiebt eine echte Rechnung in den Spamordner, oder er lässt eine Betrugsmail in den Posteingang durch. Präzision und Recall zählen diese beiden Fehler getrennt, und der Machine Learning Crash Course von Google erklärt beide Maße deshalb an einem Spamfilter1.
Die beiden Formeln am Spamfilter
Als Treffer gilt hier eine Spammail, die im Spamordner landet. Die Präzision teilt diese Treffer durch alles, was im Spamordner liegt, also Treffer plus fälschlich aussortierte echte Mails12. Der Recall teilt dieselben Treffer durch alle Spammails, die überhaupt angekommen sind, also Treffer plus durchgerutschte Spams12. Andere Namen für den Recall sind Sensitivität oder Richtig-positiv-Rate, im Deutschen auch Trefferquote12.
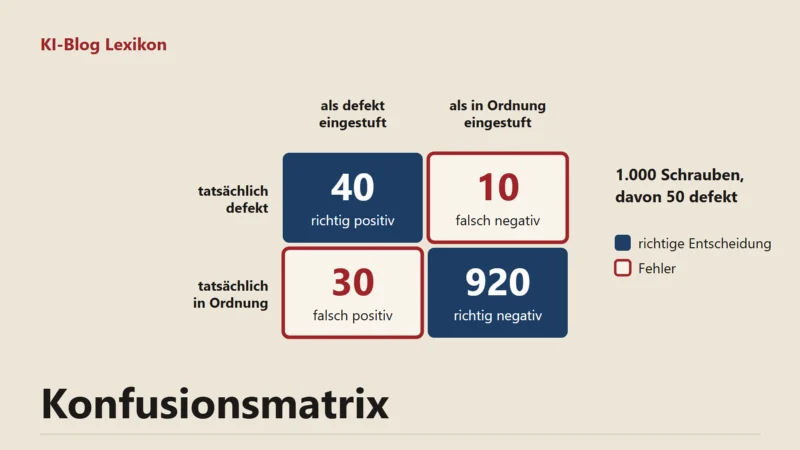
An einem Montag kommen 50 Spammails und 150 echte Mails an. Der Filter sortiert 45 Mails aus, davon sind 40 Spam und 5 echte Mails. Die Präzision beträgt 40 von 45, rund 0,89. Der Recall beträgt 40 von 50, also 0,8, denn zehn Spams sind im Posteingang gelandet. Trägt man die 40 erkannten Spams, die 5 falsch aussortierten Mails, die 10 übersehenen Spams und die 145 richtig durchgelassenen Mails in eine Konfusionsmatrix ein, lassen sich beide Werte direkt ablesen.
Warum das eine steigt, wenn das andere fällt
Die meisten Klassifikatoren geben einen Wahrscheinlichkeitswert aus, und erst eine Schwelle macht daraus ein Ja oder Nein. Hebt man die Schwelle an, landen weniger Mails im Spamordner: Richtig und falsch aussortierte Mails werden beide weniger, die Präzision steigt meist, der Recall sinkt3. Senkt man die Schwelle, kehrt sich das um3. Google beschreibt einen Filter mit der Schwelle 0,9999, der kaum noch echte Mails aussortiert und dafür viel Spam übersieht3.
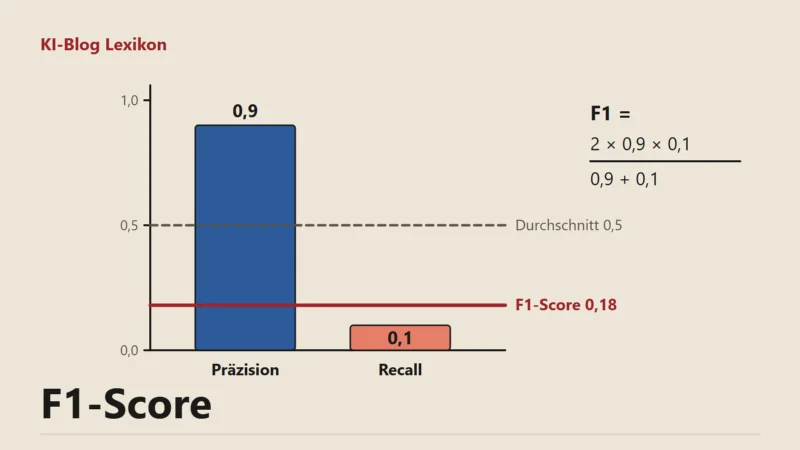
Welche Seite wichtiger ist, hängt von den Kosten der Fehler ab. Google rät zum Recall, wenn übersehene Fälle teurer sind als Fehlalarme, und zur Präzision, wenn jede positive Meldung stimmen muss1. Beim Spamfilter kann die verlorene Rechnung schwerer wiegen, bei einer Vorsorgeuntersuchung der übersehene Befund. Wer beide Werte in einer einzigen Zahl braucht, nimmt den F1-Score, ihr harmonisches Mittel.
Wenn die gesuchte Klasse selten ist
Von unausgewogenen Daten oder Class Imbalance spricht man, wenn eine Klasse viel häufiger vorkommt als die andere3. Die Accuracy taugt dann wenig, weil sie vom Übergewicht der häufigen Klasse lebt. Präzision und Recall schauen nur auf die seltene Klasse und bleiben deshalb aussagekräftig. Bei sehr wenigen positiven Fällen sagt die Präzision wenig aus: Laut Google gilt das schon bei einem oder zwei echten Treffern1.
Trägt man Präzision und Recall für alle Schwellen gegeneinander auf, entsteht die Precision-Recall-Kurve. Takaya Saito und Marc Rehmsmeier haben 2015 gezeigt, dass sie bei stark unausgewogenen Daten mehr verrät als die ROC-Kurve, weil sie den Einbruch der Präzision sichtbar macht4. In einer Nachrechnung einer veröffentlichten Studie sahen die ROC-Kurven auf beiden Testdatensätzen gut aus, während die Precision-Recall-Kurven auf dem unausgewogeneren Datensatz bei den meisten Werkzeugen eine sehr niedrige Präzision zeigten4.
Häufige Fragen
Wie heißt Recall auf Deutsch?
Gebräuchlich sind Sensitivität, Trefferquote oder Richtig-positiv-Rate. In der Medizin ist Sensitivität üblich, im maschinellen Lernen bleibt meist das englische Wort.
Kann ein Modell bei beiden Werten 1 erreichen?
Nur wenn es alle Fälle fehlerfrei trennt. Im Alltag kostet ein höherer Recall fast immer etwas Präzision, weil das Modell dafür auch unsichere Fälle melden muss.
Wie rechnet man bei mehr als zwei Klassen?
Man bestimmt die Werte je Klasse und bildet einen Mittelwert. scikit-learn bietet dafür unter anderem den einfachen Mittelwert über alle Klassen (macro) und einen nach Klassengröße gewichteten (weighted) an2.
Quellen
Stand:
- Google for Developers: Machine Learning Crash Course: Classification, Accuracy, recall, precision, and related metrics, abgerufen am 22.11.2026. zurück
- scikit-learn: Metrics and scoring: quantifying the quality of predictions (Version 1.9.1), abgerufen am 22.11.2026. zurück
- Google for Developers: Machine Learning Crash Course: Thresholds and the confusion matrix, abgerufen am 22.11.2026. zurück
- PLOS ONE (Saito, Rehmsmeier): The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets, Stand 04.03.2015, abgerufen am 22.11.2026. zurück