Lexikon · F
Feature Engineering
Kurzantwort
Pedro Domingos nannte 2012 die verwendeten Merkmale den mit Abstand wichtigsten Faktor dafür, ob ein Projekt mit maschinellem Lernen gelingt1. Feature Engineering ist die Arbeit, aus Rohdaten solche Merkmale zu bauen, etwa aus einem Zeitstempel die Stunde und den Wochentag oder aus zwei Spalten ihr Verhältnis.
Ein Merkmal, englisch Feature, ist eine Spalte, die ein Modell zu sehen bekommt. Rohdaten liegen oft in einer Form vor, aus der sich schwer lernen lässt; aus ihnen lassen sich aber Merkmale konstruieren, die das Lernen erleichtern1. Domingos, 2012 Professor für Informatik an der University of Washington, schrieb in den Communications of the ACM, dass hier meist der größte Teil der Arbeit in einem Projekt steckt, und dass Intuition und Kreativität dabei so viel zählen wie Technik1. Es ist Handarbeit mit Fachwissen, denn welche Kombination aussagekräftig ist, hängt vom Gebiet ab1.
Ein Zeitstempel und vier Rechenwege
Wie viel ein gutes Merkmal ausmacht, zeigt ein Rechenbeispiel, das scikit-learn in seinem Handbuch mitliefert. Es sagt die stündliche Nachfrage eines Fahrradverleihs vorher, 17.379 Stunden mit Wetter, Uhrzeit, Wochentag und Monat3. Die Nachfrage folgt Tages-, Wochen- und Jahresrhythmen3. Ein lineares Modell, das Stunde und Wochentag als bloße Zahlen bekommt, liegt im Mittel um 0,142 daneben, gemessen als Anteil der höchsten Nachfrage3. Werden die Zeitangaben als Kategorien kodiert, sinkt der Fehler auf 0,099. Mit periodischen Kurvenstücken für die Zeit und ihren Wechselwirkungen kommt dasselbe lineare Modell auf 0,0783.
Das lineare Modell blieb dasselbe, es bekam nur andere Eingaben. Als Zahl liegt 23 Uhr weit entfernt von 0 Uhr, obwohl die beiden Stunden nebeneinander liegen. Sinus und Kosinus der Uhrzeit beseitigen diesen Sprung zwischen Ende und Anfang des Zyklus3. Ein Entscheidungsbaum-Verfahren mit Gradient Boosting kam übrigens schon mit den rohen Zeitwerten auf 0,044, weil Bäume auch nicht gleichförmige Zusammenhänge selbst erfassen3.
Merkmale kreuzen
Oft steckt die Information in der Kombination zweier Spalten. Google beschreibt Feature Crosses: Zwei kategorische Merkmale werden zu allen möglichen Paaren verbunden, so dass auch ein lineares Modell Wechselwirkungen abbilden kann2. Welche Kreuzungen sinnvoll sind, verrät am ehesten das Fachwissen. Der Haken ist die Größe. Kreuzt man ein Merkmal mit 100 Werten mit einem mit 200, entstehen 20.000 Spalten, die fast alle leer sind2. Für Kategorien im Allgemeinen gibt es in scikit-learn den `OneHotEncoder`, der aus jedem möglichen Wert eine eigene Spalte macht4. Dieser Schritt zählt schon zur Datenvorverarbeitung, auf der das Kreuzen aufbaut.
Auswählen gehört dazu
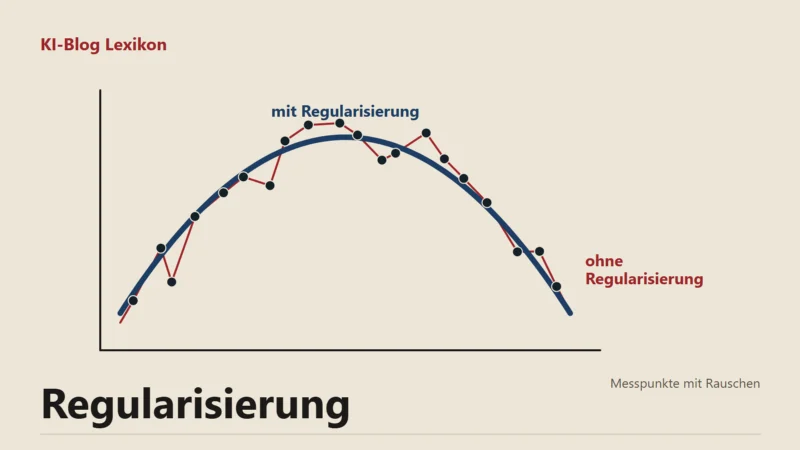
Mehr Merkmale sind nicht automatisch besser. Domingos warnt, dass zu viele Kandidaten das Training verlangsamen und Overfitting begünstigen. Gleichzeitig können Merkmale, die einzeln nutzlos wirken, in Kombination viel aussagen; sein Beispiel ist die XOR-Verknüpfung1. Ein rechnerischer Weg zur Auswahl ist die L1-Regularisierung, die Gewichte unwichtiger Eingänge auf null setzt5.
Neuronale Netze im Deep Learning können manche Kombinationen selbst lernen, allerdings mit hohem Rechenaufwand2. Den Bau von Merkmalen weiter zu automatisieren, bezeichnete Domingos als einen der heiligen Grale des Fachs1. Systeme für AutoML übernehmen inzwischen einen Teil dieser Arbeit.
Häufige Fragen
Ist Feature Engineering dasselbe wie Datenvorverarbeitung?
Die Grenze ist fließend. Vorverarbeitung macht vorhandene Daten verwendbar, etwa durch Füllen von Lücken und Skalieren; Feature Engineering erzeugt daraus neue Spalten mit mehr Aussagekraft.
Quellen
Stand:
- Communications of the ACM (Pedro Domingos): A Few Useful Things to Know about Machine Learning, Stand 10/2012, abgerufen am 22.11.2026. zurück
- Google for Developers: Machine Learning Crash Course: Categorical data, Feature crosses, abgerufen am 22.11.2026. zurück
- scikit-learn 1.9.1: Time-related feature engineering, abgerufen am 22.11.2026. zurück
- scikit-learn 1.9.1: Preprocessing data, abgerufen am 22.11.2026. zurück
- Goodfellow, Bengio, Courville: Deep Learning, Kapitel 7: Regularization for Deep Learning, Stand 2016, abgerufen am 22.11.2026. zurück