Lexikon · R
Regularisierung
Kurzantwort
Das Lehrbuch "Deep Learning" nennt Regularisierung jede Änderung am Lernverfahren, die den Fehler auf neuen Daten senken soll, ohne dabei auf den Trainingsfehler zu zielen1. Gängige Mittel sind Strafen für große Gewichte nach L1 oder L2, ein früher Abbruch des Trainings und Normalisierungsschichten wie Batch Normalization123.
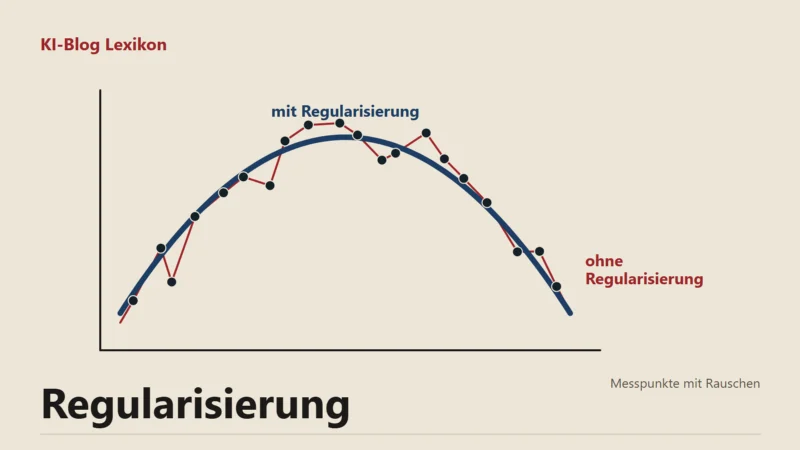
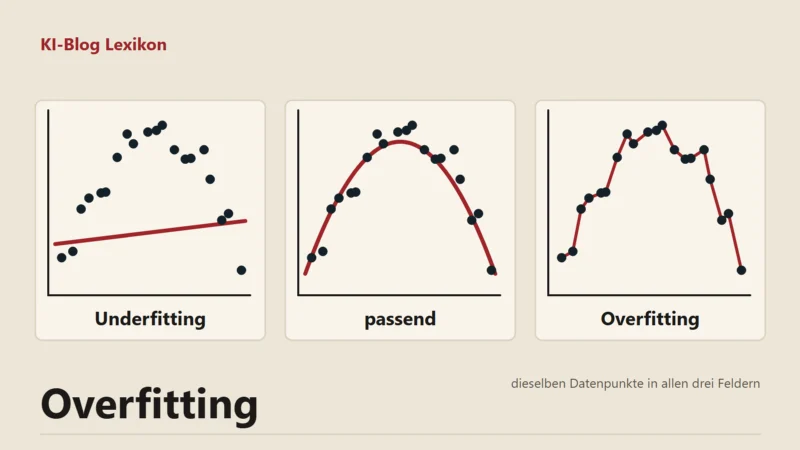
Regularisierung schiebt ein Modell zu ruhigeren, einfacheren Lösungen und arbeitet so gegen Overfitting. Sie nimmt dafür in Kauf, dass das Modell die Trainingsdaten etwas schlechter trifft. Anschaulich wird das an zwanzig verrauschten Messpunkten: Eine wilde Zickzacklinie trifft jeden davon exakt, für den nächsten Messpunkt liegt eine ruhigere Kurve aber meist näher.
L2: große Gewichte werden teuer
Goodfellow, Bengio und Courville unterscheiden grob zwei Wege: Manche Verfahren legen den Parametern zusätzliche Beschränkungen auf, andere ergänzen die Zielfunktion um einen Strafterm1. L2 gehört zur zweiten Sorte. Bei der L2-Regularisierung misst das Training die Komplexität eines Modells als Summe der quadrierten Gewichte und addiert sie, mit einem Faktor Lambda multipliziert, zum Verlust2. Durch das Quadrieren zählen große Gewichte überproportional; in einem Rechenbeispiel von Google macht ein einziges Gewicht rund 93 Prozent der gesamten Komplexität aus2.
L2 zieht die Gewichte zur Null hin, setzt aber keines ganz auf null, jedes Merkmal trägt also weiter ein wenig bei2. Ein großes Lambda senkt das Risiko der Überanpassung; die Gewichte sammeln sich dann in einer Glockenkurve eng um null. Bei kleinem Lambda verteilen sie sich flacher und breiter, mit Lambda null ist die Regularisierung abgeschaltet. Den passenden Wert muss man für die jeweiligen Daten suchen2. Außerdem hängt Lambda mit der Lernrate zusammen, denn beide ziehen die Gewichte in entgegengesetzte Richtungen. Der Crash Course rät deshalb, nach einer Änderung der Lernrate auch die Regularisierungsrate neu einzustellen2.
L1 setzt Gewichte auf null
Die L1-Regularisierung bestraft die Beträge der Gewichte. Ihr Ergebnis ist dünner besetzt: Manche Gewichte landen genau bei null1. Weil die zugehörigen Eingangsgrößen damit aus dem Modell verschwinden, wird L1 häufig zur Auswahl von Merkmalen genutzt1, einer Aufgabe des Feature Engineering.
Rechtzeitig aufhören
Beim frühen Abbruch, englisch Early Stopping, beobachtet man während des Trainings den Fehler auf einem Validierungsdatensatz. Verbessert er sich über eine festgelegte Zahl von Durchgängen nicht mehr, endet das Training, und die bis dahin besten Parameter werden behalten1. Goodfellow, Bengio und Courville halten das für die wohl am häufigsten genutzte Form der Regularisierung im Deep Learning, weil es einfach ist und wirkt1. Google nennt es schnell, aber selten optimal2.
Batch Normalization
Sergey Ioffe und Christian Szegedy stellten 2015 ein Verfahren vor, das die Eingaben jeder Schicht für jedes Mini-Batch normalisiert3. Gedacht war es gegen das ständige Verschieben der Verteilungen zwischen den Schichten während des Trainings3. Es erlaubt deutlich höhere Lernraten und wirkt nebenbei regularisierend, in manchen Fällen so stark, dass Dropout, das zufällige Abschalten von Neuronen, überflüssig wird3. Ein Bildklassifikator erreichte damit dieselbe Genauigkeit mit 14-mal weniger Trainingsschritten3.
Häufige Fragen
Ist Weight Decay dasselbe wie L2-Regularisierung?
Das hängt vom Optimierer ab. Beim Adam in PyTorch beschreibt die Dokumentation den Parameter `weight_decay` als L2-Strafe, voreingestellt ist null, also keine Regularisierung. Mit der Option `decoupled_weight_decay` wird der Abzug dagegen von den Schätzungen für Impuls und Varianz getrennt, und der Optimierer entspricht AdamW4.
Brauchen nur neuronale Netze Regularisierung?
Auch klassische Modelle profitieren davon. Bei der logistischen Regression nennt Google sie äußerst wichtig, weil der Verlust ohne Regularisierung bei vielen Merkmalen immer weiter gegen null getrieben würde5.
Quellen
Stand:
- Goodfellow, Bengio, Courville: Deep Learning, Kapitel 7: Regularization for Deep Learning, Stand 2016, abgerufen am 22.11.2026. zurück
- Google for Developers: Machine Learning Crash Course: Overfitting, L2 regularization, abgerufen am 22.11.2026. zurück
- arXiv (Ioffe, Szegedy): Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift, Stand 02.03.2015, abgerufen am 22.11.2026. zurück
- PyTorch-Dokumentation 2.15: Adam, abgerufen am 22.11.2026. zurück
- Google for Developers: Machine Learning Crash Course: Logistic regression, Loss and regularization, abgerufen am 22.11.2026. zurück