Lexikon · K
Kreuzvalidierung
Kurzantwort
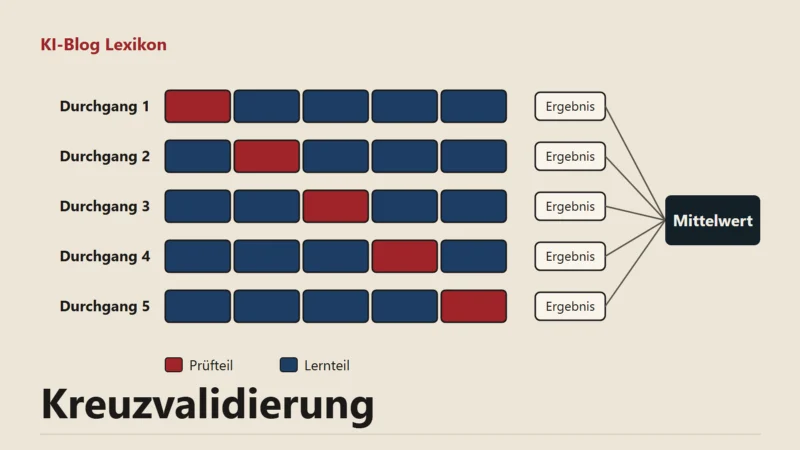
Fünf Prüfungen statt einer: Bei der fünffachen Kreuzvalidierung werden die Daten in fünf Teile geschnitten, das Modell lernt jeweils auf vier und wird am fünften geprüft, bis jeder Teil einmal an der Reihe war1. Der Mittelwert der fünf Ergebnisse schätzt, wie gut das Modell mit Daten zurechtkommt, die es nie gesehen hat1.
Wer ein Modell an denselben Daten prüft, an denen es gelernt hat, misst nur sein Gedächtnis. Die Entwickler von scikit-learn nennen das in ihrem Handbuch einen methodischen Fehler: Ein Modell, das bloß die gesehenen Antworten wiederholt, hätte eine perfekte Punktzahl und wäre für neue Daten nutzlos1. Die naheliegende Abhilfe, einen festen Teil der Daten zur Validierung abzuzweigen, hat zwei Nachteile. Es bleiben weniger Beispiele zum Lernen, und das Ergebnis hängt davon ab, welche Beispiele zufällig im Prüfteil gelandet sind1. Die Kreuzvalidierung, englisch cross validation, behebt beides, indem sie jeden Datenpunkt einmal zum Prüfen und sonst zum Lernen verwendet.
So läuft die k-fache Kreuzvalidierung
- Die Trainingsdaten werden in k gleich große, sich nicht überschneidende Teile zerlegt, die Folds13.
- Das Modell lernt auf k minus 1 Teilen und wird am übrigen Teil bewertet1.
- Das wiederholt sich, bis jeder Teil einmal Prüfteil war.
- Berichtet wird der Durchschnitt der k Ergebnisse, oft zusammen mit ihrer Streuung1.
Im Beispiel der scikit-learn-Dokumentation liefern fünf Durchgänge mit einer Support Vector Machine Werte zwischen 0,96 und 1, im Mittel 0,98 bei einer Standardabweichung von 0,021. Der Aufwand steigt mit k, dafür geht kaum ein Datenpunkt fürs Lernen verloren1. Goodfellow, Bengio und Courville empfehlen das Verfahren vor allem, wenn der Datensatz für eine einfache Aufteilung zu klein ist3.
Wie viele Teile?
Ron Kohavi verglich 1995 an der Universität Stanford in mehr als einer halben Million Läufen zweier Lernverfahren verschiedene Schätzmethoden. Sein Ergebnis für reale Datensätze dieser Art: Für die Wahl zwischen Modellen eignete sich die zehnfache, geschichtete Kreuzvalidierung am besten, auch wenn die Rechenleistung mehr Teile erlaubt hätte2. Das Extrem mit so vielen Teilen wie Datenpunkten heißt Leave-one-out1. Es ist teurer, und schon frühere Arbeiten, auf die Kohavi sich beruft, deuteten an, dass zehn Teile bei der Modellwahl besser abschneiden können2.
Varianten für besondere Daten
Geschichtet heißt, dass jeder Teil ungefähr dieselben Anteile der Klassen enthält wie der ganze Datensatz. Das ist wichtig, wenn eine Klasse selten ist; scikit-learn bietet dafür `StratifiedKFold`1. Stammen mehrere Messungen von derselben Person oder demselben Gerät, sorgt `GroupKFold` dafür, dass eine Gruppe nie gleichzeitig im Lern- und im Prüfteil steckt. Sonst lernt das Modell die Eigenheiten einzelner Personen und versagt bei neuen1. Für Zeitreihen gibt es `TimeSeriesSplit`, bei dem immer nur ältere Daten zum Lernen dienen und die Lernmengen von Runde zu Runde wachsen1.
Wo Kreuzvalidierung leicht schiefgeht
Schritte der Datenvorverarbeitung wie das Standardisieren müssen innerhalb jedes Durchgangs aus dem Lernteil berechnet werden. scikit-learn empfiehlt dafür eine Pipeline, die genau das erledigt1. Auch beim Abstimmen von Hyperparametern lauert eine Falle. Dreht man so lange an ihnen, bis die Werte auf dem Testdatensatz optimal sind, sickert laut scikit-learn Wissen über diese Daten ins Modell, und die Bewertung misst keine Verallgemeinerung mehr1. Das Ergebnis ist ein verdecktes Overfitting auf die Testdaten, und genau deshalb gehört die Abstimmung in die Kreuzvalidierung auf den Trainingsdaten. Welche Kennzahl in jedem Durchgang gemessen wird, ob Accuracy oder etwas anderes, ist eine eigene Entscheidung.
Häufige Fragen
Brauche ich mit Kreuzvalidierung noch einen Testdatensatz?
Ja. Für die endgültige Bewertung hält man einen Testdatensatz zurück, der in keinem Durchgang vorkommt; eine zusätzliche Validierungsmenge entfällt1.
Funktioniert Kreuzvalidierung auch für große Sprachmodelle?
Das Verfahren setzt voraus, dass das Modell k-mal neu trainiert wird. Bei sehr teuren Trainingsläufen ist das kaum bezahlbar. Nach unserer Einschätzung bleibt es dort meist bei einer festen Aufteilung in Trainings-, Validierungs- und Testdaten.
Quellen
Stand:
- scikit-learn 1.9.1: Cross-validation: evaluating estimator performance, abgerufen am 22.11.2026. zurück
- IJCAI Proceedings (Ron Kohavi): A Study of Cross-Validation and Bootstrap for Accuracy Estimation and Model Selection, Stand 1995, abgerufen am 22.11.2026. zurück
- Goodfellow, Bengio, Courville: Deep Learning, Kapitel 5: Machine Learning Basics, Stand 2016, abgerufen am 22.11.2026. zurück