Lexikon · B
Bias-Variance-Tradeoff
Kurzantwort
Zwei Fehlerquellen ziehen in entgegengesetzte Richtungen: Ein zu einfaches Modell irrt systematisch, das ist der Bias, ein sehr flexibles reagiert stark auf Zufälle in den Trainingsdaten, das ist die Varianz12. Mit wachsender Kapazität eines Modells sinkt der Bias meist, und die Varianz steigt. Gesucht ist der Bereich, in dem ihre Summe am kleinsten ist1.
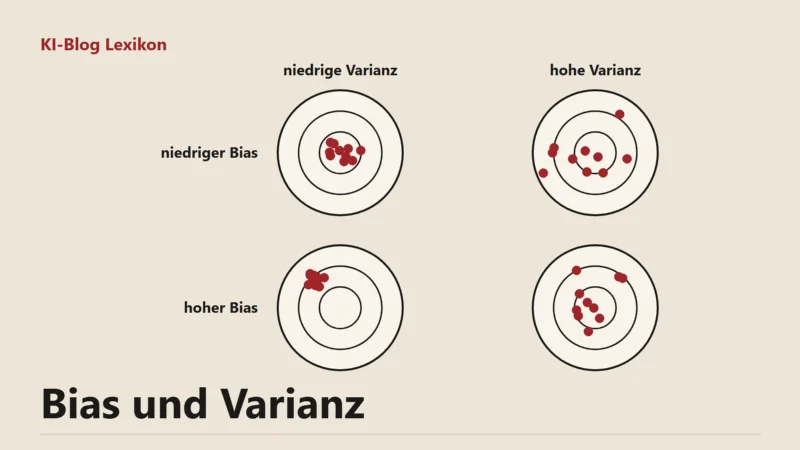
Vier Dartspieler werfen je zehn Pfeile. Beim ersten sitzen alle eng gebündelt in der Mitte. Die Pfeile des zweiten streuen weit, liegen im Schnitt aber ebenfalls mittig. Der dritte setzt alle dicht nebeneinander, nur eben links oben neben das Ziel, und beim vierten streuen sie weit und liegen obendrein daneben. Spieler zwei steht für hohe Varianz, Spieler drei für hohen Bias. Ein Modell des maschinellen Lernens lässt sich genauso beurteilen, wenn man es immer wieder mit anderen Stichproben trainiert und schaut, wo seine Vorhersagen landen.
Drei Anteile am Fehler
Im Handbuch der Python-Bibliothek scikit-learn wird der Fehler eines Modells auf neuen Daten in drei Teile zerlegt2. Der Bias ist der durchschnittliche Fehler über verschiedene Trainingsmengen hinweg, er misst also, wie weit das Modell im Mittel danebenliegt. Die Varianz gibt an, wie empfindlich das Modell auf einen Wechsel der Trainingsmenge reagiert. Das Rauschen schließlich ist eine Eigenschaft der Daten selbst und lässt sich mit keinem Modell beseitigen2. Für den mittleren quadratischen Fehler zeigt das Lehrbuch "Deep Learning" die Zerlegung als Formel: Der erwartete Fehler eines Schätzers ist das Quadrat seines Bias plus seine Varianz1.
Der statistische Bias hat mit dem KI-Bias, der Benachteiligung von Menschen durch ein System, nur den Namen gemeinsam.
Die U-Kurve der Kapazität
Je mehr Kapazität ein Modell hat, je mehr verschiedene Funktionen es also abbilden kann, desto kleiner wird in der Regel sein Bias und desto größer seine Varianz1. Trägt man den Gesamtfehler über der Kapazität auf, entsteht eine U-Form. Links vom Tiefpunkt liegt der Bereich der Unteranpassung, rechts der Bereich des Overfittings1.
In der Praxis wird diese Abwägung meist über die Kreuzvalidierung entschieden, die das Lehrbuch als den gebräuchlichsten und empirisch sehr erfolgreichen Weg nennt1. Hilfreich sind auch Lernkurven, die zeigen, ob ein Modell eher unter Bias oder unter Varianz leidet2. Gegen hohe Varianz helfen mehr Trainingsdaten. Neue Daten zu sammeln lohnt laut scikit-learn aber nur, wenn sich der wahre Zusammenhang mit einem Modell geringerer Varianz nicht erfassen lässt2. Eine andere Stellschraube ist die Regularisierung, die ein flexibles Modell gezielt einbremst.
Was moderne Netze an dem Bild ändern
Riesige neuronale Netze passen sich ihren Trainingsdaten oft bis auf den letzten Punkt an und schneiden trotzdem gut ab. Mikhail Belkin und drei Mitautoren haben dieses Verhalten 2019 in den Proceedings of the National Academy of Sciences beschrieben3. Nach ihrer Analyse folgt der Fehler einer doppelten Abwärtskurve: Steigt die Kapazität über den Punkt hinaus, an dem das Modell die Trainingsdaten genau trifft, sinkt der Fehler auf neuen Daten wieder. Die klassische U-Kurve ist nach dieser Sicht ein Teil eines größeren Verlaufs3.
Häufige Fragen
Heißt es Bias-Variance-Tradeoff oder Bias-Varianz-Dilemma?
Beide Namen meinen dasselbe. Im Deutschen findet sich auch die Form Verzerrung-Varianz-Dilemma.
Quellen
Stand:
- Goodfellow, Bengio, Courville: Deep Learning, Kapitel 5: Machine Learning Basics, Stand 2016, abgerufen am 22.11.2026. zurück
- scikit-learn 1.9.1: Validation curves: plotting scores to evaluate models, abgerufen am 22.11.2026. zurück
- arXiv (Belkin, Hsu, Ma, Mandal): Reconciling modern machine learning practice and the bias-variance trade-off, Stand 10.09.2019, abgerufen am 22.11.2026. zurück