Lexikon · M
Mixture of Experts (MoE)
Kurzantwort
Bei Mixture of Experts besteht ein Teil des Modells aus vielen parallelen Teilnetzen, den Experten, und ein Router wählt für jedes Token nur wenige davon aus2. So kann ein Modell sehr viele Parameter haben und je Token trotzdem nur einen kleinen Teil davon durchrechnen. Mixtral 8x7B etwa nutzt von rund 47 Milliarden Parametern je Token nur etwa 13 Milliarden2.
DeepSeek-V3 hat 671 Milliarden Parameter, rechnet für jedes Token aber nur mit 37 Milliarden davon3. Der Rest bleibt untätig, bis eine Eingabe kommt, für die er gebraucht wird. Möglich macht das eine Bauweise namens Mixture of Experts, kurz MoE, die auch in Mixtral 8x7B von Mistral AI steckt2. Beide sind offen dokumentierte Sprachmodelle, deren Entwickler die Architektur in technischen Berichten beschreiben23.
Router und Experten
In einem Transformer wechseln sich Aufmerksamkeitsschichten und Feedforward-Schichten ab. Ein MoE-Modell ersetzt die Feedforward-Schicht durch mehrere gleichartige Blöcke, die Experten. Bei Mixtral 8x7B sind es acht je Schicht; ein Router-Netz wählt für jedes Token in jeder Schicht zwei davon aus und verrechnet ihre Ergebnisse2. Verschiedene Tokens können so verschiedene Experten nutzen, auch innerhalb desselben Satzes2.
Das Wort "Experte" weckt falsche Bilder. Welche Aufgaben ein Teilnetz übernimmt, legt niemand vorher fest, und Fachgebiete wie Medizin oder Recht werden nicht von Hand verteilt. Die Arbeitsteilung entsteht beim Training, gesteuert durch den Router, der mitlernt.
Wo der Rechenaufwand sinkt
Die Idee ist älter als die heutigen Sprachmodelle. Noam Shazeer und seine Koautoren bauten 2017 eine Schicht mit bis zu Tausenden Experten, aus denen ein trainierbares Steuernetz für jedes Beispiel eine kleine Auswahl trifft1. Sie berichteten von mehr als tausendfach größerer Modellkapazität bei nur geringen Einbußen an Recheneffizienz und erzielten mit bis zu 137 Milliarden Parametern bei Übersetzung und Sprachmodellierung bessere Ergebnisse als frühere Verfahren, mit geringerem Rechenaufwand1.
Für den Betrieb heißt das: Die Rechenarbeit je Token richtet sich nach den aktiven Parametern. Ein MoE-Modell muss je Token also ungefähr so viel rechnen wie ein dichtes Modell von der Größe seines aktiven Teils. Mixtral erreichte oder übertraf laut seinen Entwicklern in den getesteten Benchmarks das Modell Llama 2 70B, obwohl es je Token nur etwa 13 Milliarden Parameter nutzt2. Beide Fassungen, das Grundmodell und die Chat-Variante, stehen unter der Lizenz Apache 2.02.
Auch beim Training rechnet jeder Schritt nur die gewählten Experten durch. DeepSeek nennt für DeepSeek-V3 einen Aufwand von 2,788 Millionen GPU-Stunden auf Karten vom Typ H800, bei 14,8 Billionen Trainingstokens3.
Der Haken beim Speicher
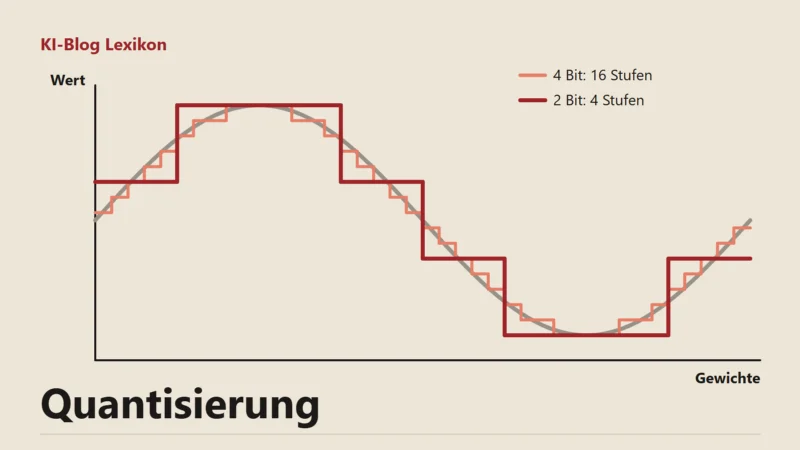
Beim Speicher spart MoE nichts. Alle Experten müssen geladen sein, weil der Router bei jedem Token andere wählen kann. Wer Mixtral 8x7B lokal betreiben will, braucht deshalb Platz für rund 47 Milliarden Parameter im VRAM oder Arbeitsspeicher, auch wenn je Token nur 13 Milliarden rechnen2. Mit Quantisierung lässt sich dieser Bedarf verkleinern.
Beim Vergleich von Modellen lohnt es sich daher, beide Zahlen zu kennen. Die Gesamtzahl der Parameter bestimmt, wie viel Speicher ein Modell belegt, die Zahl der aktiven Parameter, wie viel es je Token rechnet. Modellnamen wie "8x7B" verraten das nur zum Teil, deshalb hilft ein Blick in den technischen Bericht.
Häufige Fragen
Wofür steht die Angabe 8x7B bei Mixtral?
Ist ein MoE-Modell schneller?
Je Token rechnet es weniger als ein dichtes Modell gleicher Gesamtgröße. Ob es im Betrieb schneller antwortet, hängt auch davon ab, ob alle Experten in den schnellen Grafikspeicher passen.
Quellen
Stand:
- arXiv (Shazeer u. a.): Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer, Stand 23.01.2017, abgerufen am 22.11.2026. zurück
- arXiv (Jiang u. a.): Mixtral of Experts, Stand 08.01.2024, abgerufen am 22.11.2026. zurück
- arXiv (DeepSeek-AI): DeepSeek-V3 Technical Report, Stand 18.02.2025, abgerufen am 22.11.2026. zurück