Rechner
VRAM-Rechner für lokale KI
Worum es geht
Gib Modell, Quantisierung und Kontextlänge ein, dann zeigt der Rechner den Grafikspeicher in GiB und welche Kartengrößen reichen. Ein Modell mit 8 Milliarden Parametern in Q4_K_M braucht bei 8.192 Token Kontext rund 6,6 GiB [1, 3].
VRAM-Rechner für lokale KI
Ein Sprachmodell braucht auf der Grafikkarte Platz für drei Dinge: die Gewichte, den Kontextspeicher (KV-Cache) und einen Puffer für die Laufzeit. Der Rechner oben zählt diese drei Posten zusammen und vergleicht die Summe mit Karten von 8 bis 80 GB. Für Llama 3.1 8B in Q4_K_M mit 8.192 Token Kontext ergibt das 4,58 GiB Gewichte, 1,00 GiB Kontextspeicher und 1,0 GiB Zuschlag, zusammen 6,58 GiB13. Das passt auf eine 8-GB-Karte, mit wenig Luft.
So rechnet der Rechner
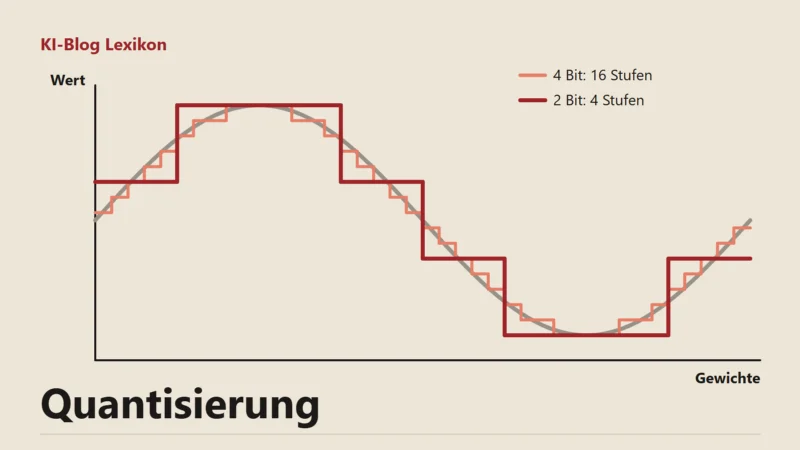
Die Gewichte ergeben sich aus Parameterzahl mal Bits je Gewicht, geteilt durch 8. Bei 16 Bit sind das 2 Byte je Parameter, also grob das Doppelte der Parameterzahl in Gigabyte2. Die Quantisierung senkt die Bits je Gewicht: Die llama.cpp-Dokumentation nennt für Llama 3.1 8B 16,0005 Bit bei F16, 8,5008 bei Q8_0, 4,8944 bei Q4_K_M und 3,1593 bei Q2_K1. Diese Werte stecken in der Auswahl "Quantisierung".
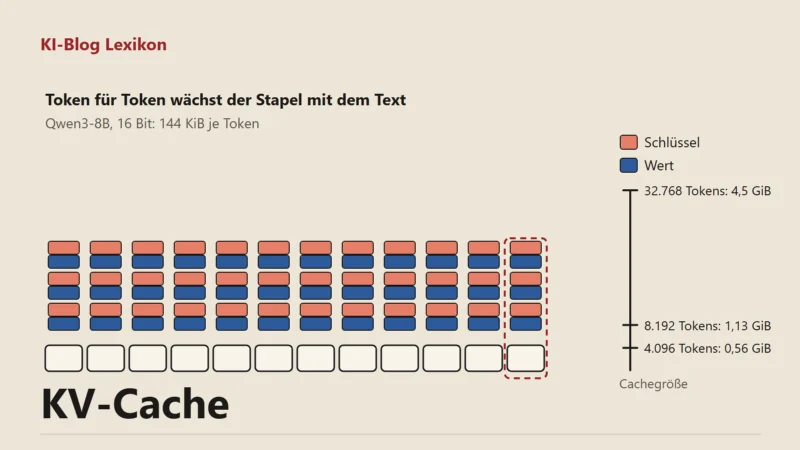
Der KV-Cache wächst mit der Kontextlänge. Für jedes Token legt das Modell in jeder Schicht einen Schlüssel und einen Wert ab, deshalb lautet die Formel 2 mal Kontext mal Schichten mal Key-Value-Köpfe mal Kopfdimension mal Byte je Wert2. Llama 3.1 8B hat 32 Schichten und 8 Key-Value-Köpfe3. Bei 8.192 Token sind das 1 GiB, bei 32.768 Token schon 4 GiB und bei 131.072 Token 16 GiB3. Wer den Kontextspeicher in 8 Bit hält, halbiert diesen Posten ungefähr; Ollama nennt für die Einstellung q8_0 etwa die Hälfte des Speichers von f167.
Der Zuschlag von 1,0 GiB ist ein Schätzwert für CUDA-Kontext, Rechenpuffer und das, was andere Programme auf der Karte belegen. Du kannst ihn im Feld ändern.
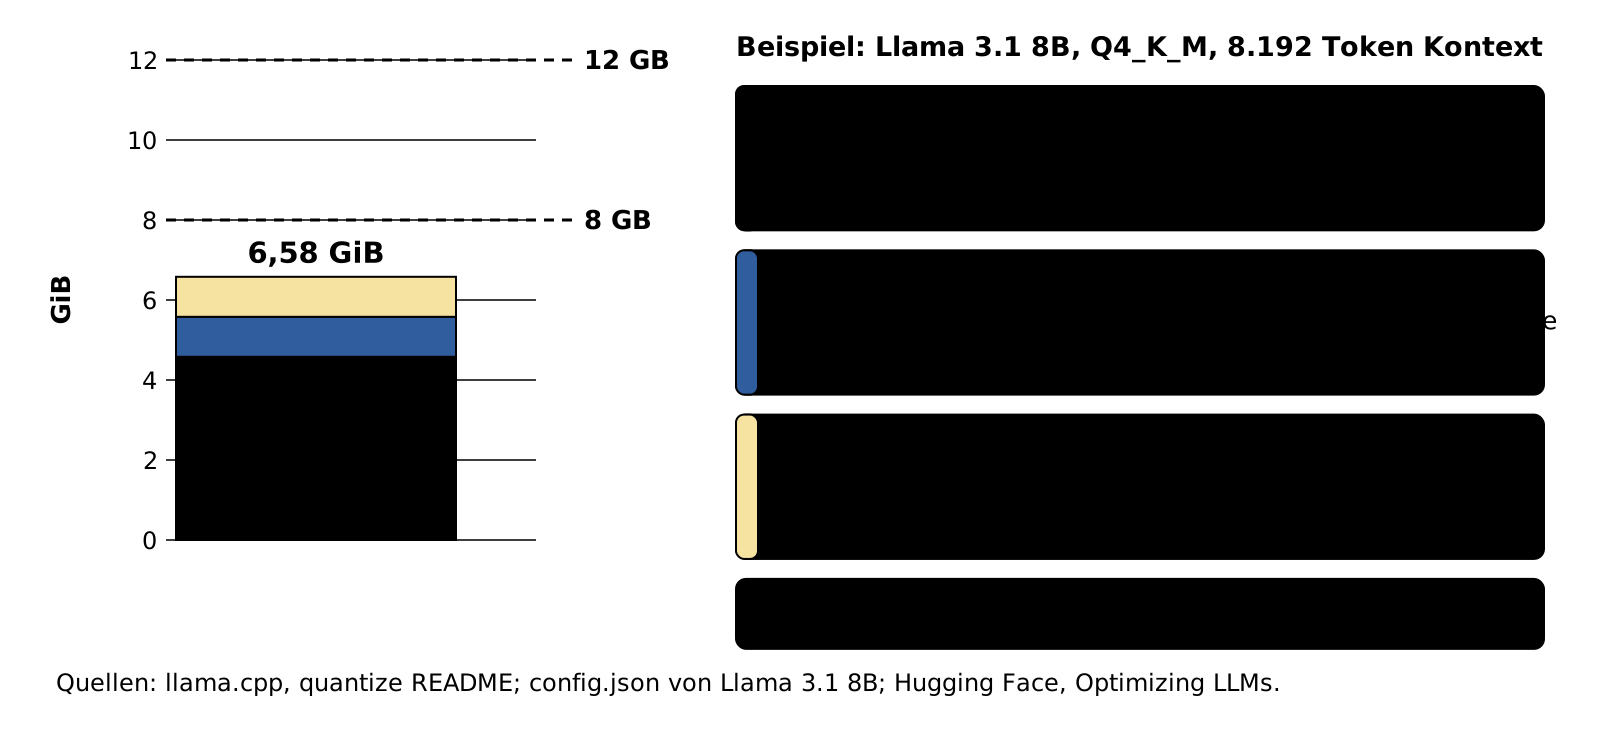
- Gewichte Parameter mal Bits je Gewicht durch 8
- Kontextspeicher 2 mal Kontext mal Schichten mal KV-Köpfe mal Kopfdimension mal Byte
- Zuschlag Puffer für Laufzeit und andere Programme
Woher die Zahlen kommen
Die acht Modelle in der Liste haben Parameterzahl, Schichten, Key-Value-Köpfe und Kopfdimension aus der Datei config.json ihrer Modellkarte auf Hugging Face3. Für ein anderes Modell wählst du "Eigene Angaben" und trägst die vier Werte selbst ein. In der config.json heißen sie num_hidden_layers, num_key_value_heads und head_dim; fehlt head_dim, teilst du hidden_size durch num_attention_heads3. Das Ergebnis steht in GiB (1.073.741.824 Byte), so wie Treiber und Werkzeuge den Speicher meist anzeigen.
Rechnung gegen Messung
Am 22.11.2026 haben wir Llama 3.2 3B in Q4_K_M mit Ollama 0.40.0 und 8.192 Token Kontext auf zwei Karten gemessen, je drei Läufe nach einem Aufwärmlauf6. Das Modell hat 3,21 Milliarden Parameter, 28 Schichten, 8 Key-Value-Köpfe und eine Kopfdimension von 12845. Die Formel ergibt 1,83 GiB Gewichte und 0,88 GiB Kontextspeicher, zusammen 2,70 GiB ohne Zuschlag145.
Gemessen stieg der belegte Grafikspeicher auf der RTX 4090 um 2,96 GiB und auf der RTX 5060 Ti um 2,61 GiB6. Ollama selbst meldete 2,48 GiB für das geladene Modell6. Die Rechnung ohne Zuschlag liegt also nah an der Messung; mit dem voreingestellten Zuschlag von 1,0 GiB rechnet der Rechner bei diesem kleinen Modell um 0,7 bis 1,1 GiB zu hoch6. Das ist Absicht, denn auf einer Karte, die auch den Bildschirm treibt, belegen Desktop und Browser oft mehr als ein Gigabyte; auf unserer 4090 waren es vor der Messung 1,78 GiB6.
Die Messungen mit größeren Modellen und langen Kontexten folgen in den Praxistests Sprachmodelle auf der RTX 4090, Sprachmodelle auf der RTX 5060 Ti und lange Kontexte lokal. Sobald sie vorliegen, setzen wir den Zuschlag aus den gemessenen Abweichungen neu. Was die Stufen Q4 bis Q8 an Antwortqualität kosten, misst der Praxistest Quantisierung.
Wo die Schätzung danebenliegt
Die Formel gilt für dichte Modelle mit einem Kontextspeicher je Schicht. Bei Mixture-of-Experts-Modellen müssen alle Experten in den Speicher, auch wenn je Token nur ein Teil rechnet; du trägst dann die Gesamtzahl der Parameter ein. Modelle mit Gleitfenster-Aufmerksamkeit oder komprimiertem Kontext kommen mit weniger Kontextspeicher aus, als der Rechner ausgibt. Bild- und Tonanteile multimodaler Modelle fehlen in der Rechnung.
Parallele Anfragen brauchen je einen eigenen Kontextspeicher. Ollama rechnet etwa einen Kontext von 2.048 Token bei vier parallelen Anfragen als 8.192 Token7. Ob ein Modell am Ende ganz auf der Karte liegt, zeigt der Befehl ollama ps: Steht dort "100% GPU", ist nichts in den Arbeitsspeicher ausgelagert7.
Mit der Summe in der Hand wählst du im Vergleich Grafikkarte für lokale KI eine Karte aus. Was VRAM genau ist, steht im Lexikon.
Häufige Fragen
Wie viel VRAM brauche ich für ein Modell mit 70 Milliarden Parametern?
Warum zeigt der Rechner GiB und die Karte GB?
Die RTX 4090 wird als 24-GB-Karte verkauft, ihr Treiber meldet 24.564 MiB, das sind knapp 24 GiB6. Beim Grafikspeicher sind GB und GiB hier also dieselbe Größe. Der Rechner zeigt GiB, weil Treiber und Werkzeuge den Speicher so anzeigen, und vergleicht die Summe direkt mit der Kartengröße.
Quellen
Stand:
- llama.cpp (ggml-org): tools/quantize README: Bits je Gewicht und Dateigröße für Llama 3.1 8B, abgerufen am 22.11.2026. zurück
- Hugging Face: Optimizing LLMs for Speed and Memory, abgerufen am 22.11.2026. zurück
- Hugging Face (NousResearch): Meta-Llama-3.1-8B, config.json, abgerufen am 22.11.2026. zurück
- Meta auf Hugging Face: Llama-3.2-3B-Instruct, Modellkarte, Stand 09/2024, abgerufen am 22.11.2026. zurück
- Hugging Face (unsloth): Llama-3.2-3B-Instruct, config.json, abgerufen am 22.11.2026. zurück
- Eigene Messung: Probemessung Llama 3.2 3B Q4_K_M mit Ollama 0.40.0 auf RTX 4090 und RTX 5060 Ti, Treiber 621.35, Kontext 8.192, drei Läufe, Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- Ollama: FAQ: Kontextlänge, ollama ps, K/V-Cache-Quantisierung, abgerufen am 22.11.2026. zurück