Lokale KI · Vergleich
Die richtige Grafikkarte für KI
Kurzantwort
Für lokale KI zählt zuerst der Grafikspeicher (VRAM), danach Tempo und Stromverbrauch. Mit 16 GB laufen Sprachmodelle bis etwa 14 Milliarden Parameter, für 32 Milliarden brauchst du 24 bis 32 GB wie bei RTX 4090 oder RTX 509018. NVIDIA ist wegen CUDA die einfachere Wahl, AMD-Karten laufen mit Ollama über ROCm oder Vulkan5.
Die beste Grafikkarte für lokale KI ist die mit dem größten Grafikspeicher, den du bezahlen und mit Strom versorgen kannst. Ein Sprachmodell muss mitsamt Kontext in den VRAM passen, sonst weicht es in den Arbeitsspeicher aus und wird um ein Vielfaches langsamer. Für die meisten Einsteiger ist eine Karte mit 16 GB der sinnvolle Startpunkt, etwa eine RTX 5060 Ti 16 GB, RTX 5070 Ti oder RTX 50801. Wer Modelle mit 32 Milliarden Parametern ganz auf der Karte halten will, braucht 24 GB wie bei der RTX 4090 oder 32 GB wie bei der RTX 509018.
Warum der Grafikspeicher zuerst zählt
Beim Erzeugen jedes Tokens liest die Karte alle Gewichte des Modells einmal aus ihrem Speicher. Liegen diese Gewichte vollständig im VRAM, geht das schnell. Passt ein Teil nicht hinein, rechnet der Prozessor diesen Teil aus dem Arbeitsspeicher mit, und das Tempo bricht ein. Rechenleistung hilft dann wenig, weil die Karte auf die Daten wartet.
Wie viel Platz ein Modell braucht, hängt von der Parameterzahl und der Quantisierung ab. In der Ollama-Bibliothek ist Qwen3 mit 8 Milliarden Parametern 5,2 GB groß, mit 14 Milliarden 9,3 GB und mit 32 Milliarden 20 GB8. Dazu kommt der Kontextspeicher, der mit der Gesprächslänge wächst. Den genauen Bedarf für dein Modell rechnet der VRAM-Rechner aus.
Bildmodelle folgen derselben Logik. Die Datei von Stable Diffusion XL ist 6,94 GB groß, die auf fp8 verkleinerte ComfyUI-Datei von FLUX.1 [dev] 17,2 GB1415. Auf einer 16-GB-Karte muss ComfyUI Teile davon in den Arbeitsspeicher auslagern, was Zeit kostet; auf 24 GB passt die fp8-Datei ganz15.
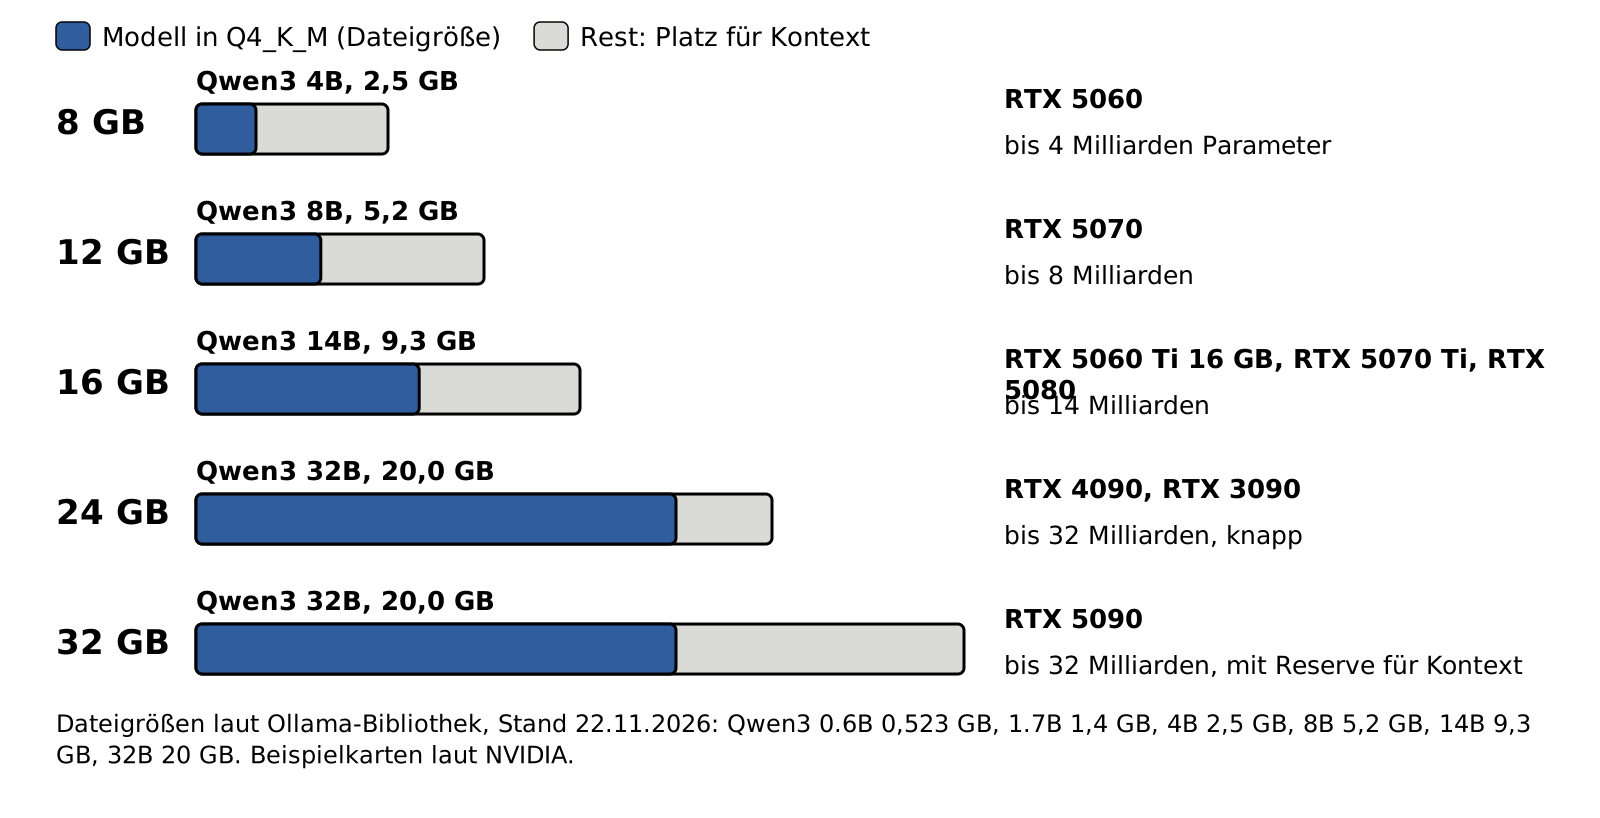
- 8 GB bis 4 Milliarden Parameter
- 16 GB bis 14 Milliarden
- 24 bis 32 GB bis 32 Milliarden
Die Kartenklassen nach Grafikspeicher
Statt nach Modellnamen sortieren wir nach Speicher, denn innerhalb einer Klasse laufen dieselben Modelle, nur verschieden schnell.
Mit 8 GB, etwa bei der RTX 5060 oder der kleinen RTX 5060 Ti, laufen Modelle bis etwa 4 Milliarden Parameter mit etwas Kontext18. Für Bilder reicht das für ältere Modelle wie Stable Diffusion 1.5. Die RTX 5070 hat 12 GB1. Damit passen 8-Milliarden-Modelle bequem, 14 Milliarden nur knapp.
Die 16-GB-Klasse ist am breitesten besetzt: RTX 5060 Ti 16 GB mit 180 Watt, RTX 5070 Ti mit 300 Watt und RTX 5080 mit 360 Watt Leistungsaufnahme1. Alle drei halten ein 14-Milliarden-Modell samt Kontext im Speicher. Sie unterscheiden sich vor allem im Tempo, der Speicher ist bei allen dreien gleich groß. Die AMD Radeon RX 9070 XT hat ebenfalls 16 GB, bei 304 Watt typischer Leistungsaufnahme3.
Mit 24 GB kommen Modelle um 32 Milliarden Parameter ins Spiel. In der aktuellen 50er-Serie hat keine Desktop-Karte genau 24 GB; diese Größe bietet die RTX 4090 aus der Vorgängerserie, bei 450 Watt1. Die RTX 5090 hat 32 GB, braucht aber 575 Watt und nach NVIDIA ein Netzteil für 1.000 Watt Systemleistung1. Für die RTX 5090 spricht vor allem der zusätzliche Puffer: Ein 32-Milliarden-Modell passt mit längerem Kontext, und große Bildmodelle wie FLUX.2 [dev] lassen sich in verkleinerter Form nutzen; Black Forest Labs nennt RTX 4090 und RTX 5090 als Karten für den lokalen Betrieb12.
Darüber beginnt die Profiklasse. Die Radeon AI PRO R9700 bietet 32 GB bei 300 Watt4, die NVIDIA RTX PRO 6000 kommt auf 96 GB bei bis zu 600 Watt2. Sie richten sich an Firmen.
Bei den Preisklassen gilt grob: 8 und 12 GB sind Einstieg, 16 GB die Mittelklasse, 24 und 32 GB die Oberklasse1. NVIDIA nennt am 22.11.2026 auf seinen Produktseiten diese unverbindlichen Preisempfehlungen: RTX 5060 Ti 399 Euro, RTX 5070 589 Euro, RTX 5070 Ti 879 Euro, RTX 5080 1.059 Euro und RTX 5090 2.099 Euro17181920. Für die RTX 5060 Ti gibt die Seite nicht an, ob der Preis für die Fassung mit 8 oder mit 16 GB gilt. Die Händlerpreise weichen davon oft ab; vergleiche am Kauftag den Preis je Gigabyte Grafikspeicher.
Was außer dem Speicher zählt
Innerhalb einer Speicherklasse entscheidet vor allem die Speicherbandbreite über das Tempo, denn sie bestimmt, wie schnell die Gewichte zum Rechenkern kommen. Sie hängt von der Breite der Speicherschnittstelle und vom Speichertakt ab. Die RTX 5060 Ti hat 128 Bit, die RTX 5070 Ti und RTX 5080 haben 256 Bit, die RTX 4090 384 Bit und die RTX 5090 512 Bit1. Eine 16-GB-Karte mit 256 Bit liefert deshalb bei gleichem Modell in der Regel mehr Tokens je Sekunde als eine mit 128 Bit.
Dazu kommen Bauform und Anschlüsse. Große Karten belegen mehrere Steckplätze und sind lang, das Gehäuse muss Platz und Luftstrom bieten. Die RTX 4090 braucht drei 8-polige PCIe-Kabel über einen mitgelieferten Adapter oder ein Kabel der 5. Generation für 450 Watt1, die Radeon AI PRO R9700 einen Stecker vom Typ 12V-2x64. Ältere Netzteile haben diese Stecker oft nicht.
Bei der Lautstärke hilft ein Blick auf die Bauform der Partnerkarten: Modelle mit drei großen Lüftern bleiben unter Dauerlast meist leiser als kompakte Karten mit zwei kleinen. Wer die Karte vor allem für lange Bildserien nutzt, sollte darauf mehr achten als auf den letzten Prozentpunkt Tempo.
NVIDIA oder AMD
NVIDIA hat den Vorteil der Programmierschnittstelle CUDA, auf der fast jedes KI-Werkzeug zuerst entwickelt wird. Ollama unterstützt NVIDIA-Karten ab Compute Capability 5.0 mit Treiber ab Version 5505. ComfyUI gibt es als fertiges Windows-Paket für NVIDIA mit CUDA 13.0; für Karten der GTX-10-Serie und älter liegt eine eigene Fassung mit CUDA 12.6 bereit6.
AMD-Karten laufen inzwischen auch, mit Einschränkungen. Unter Linux braucht Ollama den ROCm-7-Treiber, die Liste der unterstützten Radeon-Karten reicht dort von der RX 6800 bis zur RX 9070 XT5. Unter Windows führt Ollama für ROCm nur Karten der RX-7000-Serie auf; für alle anderen Radeon-Karten bleibt der Weg über Vulkan, das Ollama unter Windows standardmäßig einschaltet5. ComfyUI bietet ein eigenes Windows-Paket für AMD und eines für Intel an6.
Wer ohne Bastelei alles ausprobieren will, von Sprachmodellen über Bildgeneratoren bis zum eigenen Feintuning, nimmt NVIDIA. Wer vor allem Ollama oder LM Studio für Text nutzt und unter Linux arbeitet, bekommt bei AMD oft mehr Speicher fürs Geld.
Gebrauchte Karten
Der Klassiker unter den Gebrauchtkarten ist die RTX 3090 mit 24 GB GDDR6X, 350 Watt und einer Empfehlung von 750 Watt Systemleistung1. Sie bietet denselben Speicher wie die RTX 4090, stammt aber aus der älteren Ampere-Generation. Für kleinere Budgets gibt es die RTX 3060 mit 12 GB bei 170 Watt1. Noch ältere Karten der GTX-Serien laufen mit Ollama, solange sie Compute Capability 5.0 erreichen; für Karten zwischen 5.0 und 6.2 verlangt Ollama inzwischen einen Treiber ab Version 5705. Mit 6 bis 8 GB sind sie aber nur für sehr kleine Modelle eine Option.
Achte beim Gebrauchtkauf auf drei Dinge. Erstens die Software: Das ComfyUI-Paket mit CUDA 13.0 ist für aktuelle Karten gedacht, für Karten der GTX-10-Serie und älter gibt es eine eigene Fassung mit CUDA 12.667. Zweitens den Zustand: Lüfter, Wärmeleitpaste und Speichertemperatur leiden bei Karten, die lange unter Volllast liefen. Drittens Rechnung und Restgarantie, denn eine Rücknahme ist im Privatverkauf meist ausgeschlossen.
Stromverbrauch und Netzteil
Die Herstellerangaben nennen die Leistungsaufnahme der Karte und eine Empfehlung für das ganze System. Bei der RTX 5060 Ti sind das 180 und 600 Watt, bei der RTX 5080 360 und 850 Watt, bei der RTX 5090 575 und 1.000 Watt1. AMD empfiehlt für die RX 9070 XT mindestens 750 Watt3.
Im Alltag liegen die Werte unter dem Maximum. In unserer Probemessung mit einem kleinen Sprachmodell zog die RTX 4090 im Median 274,9 Watt, die RTX 5060 Ti 157,0 Watt9. Beim Bildmodell Stable Diffusion 1.5 waren es auf der RTX 4090 im Median 173,5 Watt10. Gemessen hat dabei nvidia-smi nur die Karte, Prozessor und Netzteil kommen dazu.
Auffällig war der Leerlauf. Die RTX 5060 Ti ohne angeschlossenen Bildschirm brauchte vor der Messung 4,0 Watt, die RTX 4090, an der Monitor und Desktop hängen, 57,4 Watt9. Wer den Rechner viele Stunden laufen lässt, sollte den Bildschirm an die sparsamere Karte oder an die Grafik des Prozessors hängen. Die Stromkosten eines Abends mit lokaler KI hält der Praxistest Stromverbrauch fest.
Unsere Messwerte auf zwei Karten
Wir messen auf einer RTX 4090 mit 24 GB und einer RTX 5060 Ti mit 16 GB im selben Rechner, Treiber 621.359. Bei der Probemessung mit Llama 3.2 3B in Q4_K_M und Ollama 0.40.0 schaffte die 4090 im Median 282,6 Tokens pro Sekunde, die 5060 Ti 160,99. Die größere Karte war damit um rund 76 Prozent schneller und zog rund 75 Prozent mehr Strom9.
Bei Bildern ist der Abstand ähnlich. Unsere Bildkette mit dem Modell Z-Image Turbo in 8 Schritten brauchte für ein Bild mit 1248 x 832 Pixeln auf der RTX 4090 meist 11 bis 13 Sekunden, auf der RTX 5060 Ti 26 bis 28 Sekunden11. Stable Diffusion 1.5 mit 512 x 512 Pixeln und 20 Schritten lief auf der 4090 in 1,36 Sekunden je Bild10. Die vollständigen Reihen mit Modellen bis 32 Milliarden Parameter, SDXL und Flux stehen in den Praxistests RTX 4090, RTX 5060 Ti und Bildmodelle in ComfyUI.
Welche Karte für welche Aufgabe
Wer erst einmal ausprobieren will, ob lokale KI in den Alltag passt, kauft am besten keine neue Karte. Ein vorhandener Rechner mit 8 GB reicht für kleine Modelle, und die Erfahrungen zeigen dann, ob 16 oder 32 GB sinnvoll sind8. Für diesen ersten Versuch reichen ein kostenloses Programm und ein kleines Modell, wie bei lokaler KI für Einsteiger beschrieben.
Für Chat, Zusammenfassungen und Übersetzungen mit Modellen bis 14 Milliarden Parametern reicht eine 16-GB-Karte8. Hier ist die RTX 5060 Ti 16 GB wegen des niedrigen Strombedarfs angenehm, die RTX 5070 Ti antwortet schneller.
Für Bildgenerierung mit SDXL, Z-Image oder Flux in verkleinerter Form sind 16 GB ebenfalls die Untergrenze für entspanntes Arbeiten; Z-Image Turbo passt laut Modellkarte in 16 GB13. Wer viele Bilder am Stück erzeugt, profitiert von einer schnelleren Karte mehr als von zusätzlichem Speicher. Die Bildmodelle mit Lizenz und Dateigröße stellt Bildmodelle lokal nutzen nebeneinander.
Für Modelle mit 32 Milliarden Parametern, lange Dokumente oder Programmierhilfe mit großem Kontext führt an 24 bis 32 GB kaum ein Weg vorbei18. Eine gebrauchte RTX 3090 ist hier der günstigste Einstieg, die RTX 5090 der schnellste. Wer noch mehr Speicher will, ohne mehrere Karten zu betreiben, schaut sich Rechner mit großem gemeinsamem Speicher an: Lokale KI auf dem Mac beschreibt die Apple-Seite, Mini-PCs mit AMD Ryzen AI Max und NVIDIA DGX Spark stehen in KI-PC kaufen oder bauen.
| Karte | Grafikspeicher | Leistungsaufnahme | Netzteil laut Hersteller | Sprachmodelle in Q4 bis etwa |
|---|---|---|---|---|
| RTX 5060 Ti 16 GB | 16 GB GDDR7 | 180 Watt | 600 Watt | 14 Milliarden Parameter |
| RTX 5070 Ti | 16 GB GDDR7 | 300 Watt | 750 Watt | 14 Milliarden Parameter |
| RTX 5080 | 16 GB GDDR7 | 360 Watt | 850 Watt | 14 Milliarden Parameter |
| RTX 4090 | 24 GB GDDR6X | 450 Watt | 850 Watt | 32 Milliarden Parameter, knapp |
| RTX 5090 | 32 GB GDDR7 | 575 Watt | 1.000 Watt | 32 Milliarden Parameter mit Kontextreserve |
| RTX 3090 (gebraucht) | 24 GB GDDR6X | 350 Watt | 750 Watt | 32 Milliarden Parameter, knapp |
| Radeon RX 9070 XT | 16 GB GDDR6 | 304 Watt | 750 Watt | 14 Milliarden Parameter |
| Radeon AI PRO R9700 | 32 GB GDDR6 | 300 Watt | 750 Watt | 32 Milliarden Parameter mit Kontextreserve |
Stand: 22.11.2026 Speicher, Leistungsaufnahme und Netzteil laut NVIDIA und AMD. Die Modellgrößen leiten sich aus den Dateigrößen der Ollama-Bibliothek ab (Qwen3, Q4_K_M) und lassen Platz für einen kurzen Kontext.
Was das für dich heißt
Leg zuerst fest, welches Modell du nutzen willst, dann wählst du die Karte.
- Rechne den Bedarf deines Wunschmodells im VRAM-Rechner aus und plane etwas Reserve für den Kontext ein.
- Prüf, ob dein Netzteil die Empfehlung des Herstellers erfüllt und die passenden Stecker hat.
- Vergleiche beim Kauf den Preis je Gigabyte Grafikspeicher statt nur die Spieleleistung.
- Lass dir bei gebrauchten Karten Rechnung und Restgarantie zeigen.
Häufige Fragen
Lohnt sich die RTX 5090 für lokale KI?
Reichen 8 GB VRAM für lokale KI?
Für kleine Modelle bis etwa 4 Milliarden Parameter und für Stable Diffusion 1.5 ja8. Größere Sprachmodelle laufen nur teilweise auf der Karte und werden dann langsam. Wer neu kauft, nimmt besser gleich 16 GB.
Kann ich zwei Grafikkarten zusammen nutzen?
Ja. Passt ein Modell nicht auf eine Karte, verteilt Ollama es auf alle verfügbaren Karten16, der Speicher addiert sich also grob. Schneller wird es dadurch meist nicht, weil die Karten nacheinander an den Schichten rechnen. Netzteil, Gehäuse und Mainboard müssen beide Karten tragen.
Ist eine AMD-Karte unter Windows brauchbar?
Für Text mit Ollama ja, über ROCm bei der RX-7000-Serie oder über Vulkan bei den übrigen Karten5. Bei Bildwerkzeugen und Feintuning ist die Auswahl kleiner als bei NVIDIA.
Quellen
Stand:
- NVIDIA: GeForce-Grafikkarten im Vergleich: technische Daten der Serien 30, 40 und 50, abgerufen am 22.11.2026. zurück
- NVIDIA: RTX PRO 6000 Blackwell: technische Daten, abgerufen am 22.11.2026. zurück
- AMD: Radeon RX 9070 XT: Specifications, abgerufen am 22.11.2026. zurück
- AMD: Radeon AI PRO R9700: Specifications, abgerufen am 22.11.2026. zurück
- Ollama: Hardware support: NVIDIA, AMD Radeon, Apple, Vulkan, abgerufen am 22.11.2026. zurück
- Comfy-Org: ComfyUI Installation: Windows Portable, abgerufen am 22.11.2026. zurück
- Comfy-Org: ComfyUI auf GitHub (README), abgerufen am 22.11.2026. zurück
- Ollama: Bibliothek: qwen3 (Größen der Modelle), abgerufen am 22.11.2026. zurück
- Eigene Messung: Probemessung Llama 3.2 3B Q4_K_M mit Ollama 0.40.0 auf RTX 4090 und RTX 5060 Ti, Treiber 621.35, drei Läufe, Median, Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- Eigene Messung: Probemessung ComfyUI 0.46.0, Stable Diffusion 1.5 fp16, 512 x 512, 20 Schritte, RTX 4090, drei Läufe, Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- Eigene Messung: Bildkette des KI-Blogs: Z-Image Turbo, 8 Schritte, RTX 4090 und RTX 5060 Ti, Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- Black Forest Labs auf Hugging Face: FLUX.2 [dev], Modellkarte, abgerufen am 22.11.2026. zurück
- Tongyi-MAI auf Hugging Face: Z-Image-Turbo, Modellkarte, abgerufen am 22.11.2026. zurück
- Stability AI auf Hugging Face: stable-diffusion-xl-base-1.0, Dateien, abgerufen am 22.11.2026. zurück
- Comfy-Org auf Hugging Face: Flux-1-Dev, Dateien, abgerufen am 22.11.2026. zurück
- Ollama: FAQ: Modelle auf mehrere Grafikkarten verteilen, abgerufen am 22.11.2026. zurück
- NVIDIA: GeForce RTX 5060-Familie (UVP), Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- NVIDIA: GeForce RTX 5070-Familie (UVP), Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- NVIDIA: GeForce RTX 5080 (UVP), Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- NVIDIA: GeForce RTX 5090 (UVP), Stand 22.11.2026, abgerufen am 22.11.2026. zurück