Lexikon · V
Variational Autoencoder
Kurzantwort
Ein Variational Autoencoder presst Daten mit einem Kodierer in eine kompakte Zwischendarstellung und baut sie mit einem Dekodierer wieder auf1. Weil er dabei eine Wahrscheinlichkeitsverteilung lernt, lassen sich aus der Zwischendarstellung auch neue, ähnliche Beispiele ziehen. In Bildgeneratoren wie Stable Diffusion übersetzt ein solcher Autoencoder zwischen dem Bild und dem kleineren Arbeitsraum des Modells34.
Wer Bilder mit Stable Diffusion erzeugt, begegnet früher oder später VAE-Dateien. Auf Hugging Face gibt es sie einzeln zum Austauschen, etwa eine nachtrainierte Fassung für Stable Diffusion, die sich mit der Bibliothek Diffusers laden lässt3. Dahinter steckt ein Verfahren, das Diederik Kingma und Max Welling im Dezember 2013 vorgestellt haben1. Im Bildmodell sorgt es dafür, dass aus den Zahlen, mit denen das Modell rechnet, am Ende ein sichtbares Bild wird.
Kodieren, verdichten, dekodieren
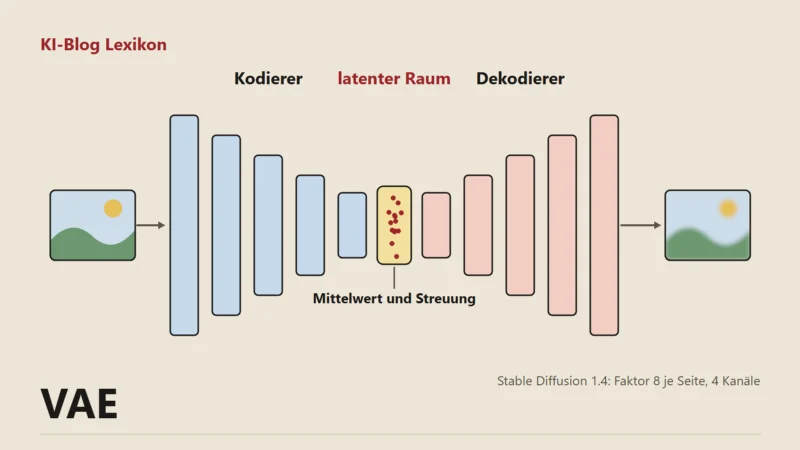
Ein gewöhnlicher Autoencoder hat die Form einer Sanduhr. Der Kodierer verkleinert die Eingabe Schicht für Schicht bis zu einer schmalen Mitte, dem latenten Raum; der Dekodierer vergrößert sie wieder auf die ursprüngliche Größe. Trainiert wird darauf, dass die Ausgabe der Eingabe möglichst gleicht. Weil die Mitte zu schmal für alle Einzelheiten ist, muss das Netz lernen, was an den Daten wesentlich ist.
Der Variational Autoencoder beschreibt jedes Beispiel in der Mitte als kleine Wolke mit Mittelwert und Streuung. Kingma und Welling zeigten, wie sich ein solches Modell mit gewöhnlichen Gradientenverfahren wie dem Gradientenabstieg trainieren lässt; der zugehörige Rechentrick heißt Reparametrisierung1. Dabei zieht das Netz zunächst reines Rauschen und verschiebt und streckt es dann mit Mittelwert und Streuung, sodass der Zufall den Weg der Gradienten beim Training nicht unterbricht. Der latente Raum wird dadurch gleichmäßiger, sodass ein zufällig gewählter Punkt darin nach dem Dekodieren oft ein neues, plausibles Beispiel ergibt. In Diffusers liefert der Kodierer entsprechend Mittelwert und Varianz einer Normalverteilung zurück, aus der sich Stichproben ziehen lassen3.
Der VAE in Stable Diffusion
Im Dezember 2021 verlegte eine Gruppe um Robin Rombach die Arbeit eines Diffusionsmodells in den latenten Raum eines vortrainierten Autoencoders2. Diffusionsmodelle, die direkt auf Bildpunkten rechnen, brauchten oft Hunderte GPU-Tage fürs Training; im verdichteten Raum wurde das Training auf kleinerer Hardware möglich und die Bilderzeugung günstiger2. Stable Diffusion ist ein solches latentes Diffusionsmodell4.
Bei Stable Diffusion 1.4 verkleinert der Autoencoder ein Bild in Höhe und Breite um den Faktor 8 und legt es in vier Kanälen ab4. Aus einem Bild mit 512 mal 512 Bildpunkten wird so ein Raster von 64 mal 64 Stellen. Das Diffusionsmodell arbeitet nur in diesem kleinen Raster; erst ganz am Ende rechnet der Dekodierer das Ergebnis in Bildpunkte zurück. Die Modellkarte nennt diesen Teil ausdrücklich verlustbehaftet4, feine Details können also verloren gehen.
Bei großen Bildern belegt der Dekodierer viel Grafikspeicher. Diffusers kann ihn deshalb in Kacheln arbeiten lassen, was den Speicherbedarf unabhängig von der Bildgröße hält, aber leichte Übergänge zwischen den Kacheln erzeugen kann3. Bei knappem VRAM hilft diese Einstellung.
Abgrenzung und andere Einsätze
Ein GAN erzeugt Bilder ohne Kodierer, allein aus dem Wettstreit zweier Netze. Außerhalb der Bilderzeugung dient der Fehler beim Wiederherstellen auch der Anomalieerkennung: Was sich schlecht rekonstruieren lässt, weicht vom Gelernten ab, und dafür braucht man keine beschrifteten Fehlerbeispiele.
Häufige Fragen
Brauche ich in ComfyUI eine eigene VAE-Datei?
Was unterscheidet Autoencoder und Variational Autoencoder?
Ein Autoencoder legt jedes Beispiel als festen Punkt ab und eignet sich vor allem zum Verdichten. Der VAE lernt eine Verteilung und kann deshalb neue Beispiele erzeugen1.
Ist der VAE dasselbe wie das Bildmodell?
Nein. In Stable Diffusion übersetzt er nur zwischen Bild und latentem Raum, das eigentliche Bild entsteht im Diffusionsmodell4.
Quellen
Stand:
- arXiv (Kingma, Welling): Auto-Encoding Variational Bayes, Stand 10.12.2022, abgerufen am 22.11.2026. zurück
- arXiv (Rombach u. a.): High-Resolution Image Synthesis with Latent Diffusion Models, Stand 13.04.2022, abgerufen am 22.11.2026. zurück
- Hugging Face: Diffusers: AutoencoderKL (Version 0.43.0), abgerufen am 22.11.2026. zurück
- Hugging Face (CompVis): Modellkarte stable-diffusion-v1-4, abgerufen am 22.11.2026. zurück