Lexikon · G
Gradientenabstieg
Kurzantwort
Stell dir vor, du stehst im Nebel an einem Hang und willst ins Tal: Du tastest, wo es am steilsten bergab geht, und machst dorthin einen kleinen Schritt. Nach diesem Prinzip verringert der Gradientenabstieg, englisch gradient descent, den Fehler eines Modells, bis weitere Schritte kaum noch etwas bringen1. Beim Training neuronaler Netze laufen meist Varianten wie SGD mit kleinen Datenpaketen oder Adam2.
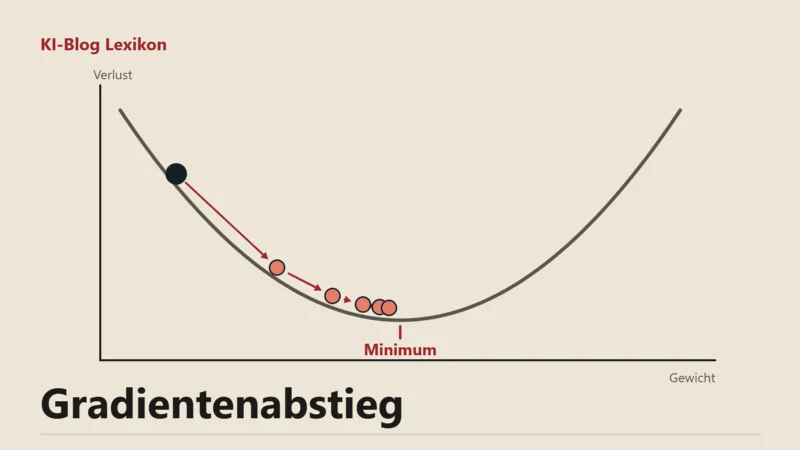
Google beschreibt den Gradientenabstieg als mathematische Technik, die wiederholt nach den Gewichten und dem Bias sucht, bei denen ein Modell den kleinsten Verlust hat1. Neuronale Netze werden in der Regel mit einer seiner Varianten trainiert2. Die Idee selbst ist alt: Als Verfahren, das die Lösung eines Optimierungsproblems schrittweise annähert, führte Augustin-Louis Cauchy es im Jahr 1847 ein5.
Ein Durchgang Schritt für Schritt
Der Ablauf wiederholt sich immer gleich1:
- Das Modell startet mit Anfangswerten für seine Parameter, im Lehrbeispiel von Google mit Gewicht und Bias null.
- Es berechnet mit diesen Werten den Verlust, also wie weit seine Vorhersagen danebenliegen. Wie dieser Wert entsteht, legt die Verlustfunktion fest.
- Der Gradient zeigt, in welche Richtung der Verlust am stärksten wächst. Das Modell rückt ein wenig in die Gegenrichtung.
- Mit den neuen Werten beginnt der nächste Durchgang.
Die Gradienten liefert in neuronalen Netzen die Backpropagation. Wie groß jeder Schritt ausfällt, regelt ein eigener Einstellwert, die Lernrate. Irgendwann senken weitere Durchgänge den Verlust nicht mehr; das Modell ist dann konvergiert1. Bei linearen Modellen ist die Verlustfläche konvex, ein konvergiertes Modell hat also das tiefste erreichbare Tal gefunden1. Die Fläche eines neuronalen Netzes ist zerklüftet. Sebastian Ruder verweist in seiner Übersicht auf Arbeiten, nach denen vor allem Sattelpunkte bremsen: Stellen, an denen es in einer Richtung bergauf und in einer anderen bergab geht und der Gradient fast überall null ist2.
Wie viele Daten in einen Schritt fließen
Ruder unterscheidet drei Varianten2. Der klassische Batch-Gradientenabstieg berechnet den Gradienten über den gesamten Trainingsdatensatz. Das ist langsam, und passt der Datensatz nicht in den Speicher, geht es gar nicht. Der stochastische Gradientenabstieg (SGD) aktualisiert die Parameter nach jedem einzelnen Beispiel; das spart Rechenarbeit, macht die Schritte aber unruhig. Der Mini-Batch-Gradientenabstieg liegt dazwischen und nimmt jeweils ein kleines Paket von Beispielen, laut Ruder meist zwischen 50 und 2562. Diese Form ist beim Training neuronaler Netze die Regel, und der Name SGD wird in der Praxis auch für sie verwendet2.
Schwung und angepasste Schritte
Reiner SGD pendelt in schmalen Tälern hin und her. Das Momentum-Verfahren addiert deshalb einen Teil des vorigen Schritts zum aktuellen und dämpft so das Pendeln2. Diederik Kingma und Jimmy Ba stellten im Dezember 2014 den Optimierer Adam vor, ein Verfahren erster Ordnung für verrauschte Zielfunktionen, das wenig Speicher braucht und dessen Einstellwerte selten nachjustiert werden müssen3. Adam passt die Schrittweite für jeden Parameter einzeln an und merkt sich dafür gleitende Mittel der bisherigen Gradienten und ihrer Quadrate; die Autoren schlagen als Vorgaben 0,9 und 0,999 für die beiden Mittelwerte vor2. Unter den Verfahren mit angepasster Schrittweite hält Ruder Adam für die wohl beste Gesamtwahl. Er merkt aber an, dass viele Arbeiten mit schlichtem SGD und einer sinkenden Lernrate auskommen; SGD findet sein Minimum meist auch, braucht dafür aber unter Umständen deutlich länger2.
In PyTorch stehen 15 Optimierer bereit, darunter SGD, Adam, AdamW und RMSprop. Jeder hat eine Methode `step()`, die nach der Berechnung der Gradienten die Parameter aktualisiert4.
Häufige Fragen
Was unterscheidet Gradientenabstieg und Backpropagation?
Backpropagation rechnet aus, wie sich der Fehler mit jedem Gewicht ändert. Der Gradientenabstieg nutzt diese Werte und verschiebt die Gewichte.
Findet der Gradientenabstieg immer die beste Lösung?
Quellen
Stand:
- Google for Developers: Machine Learning Crash Course: Linear regression, Gradient descent, abgerufen am 22.11.2026. zurück
- arXiv (Sebastian Ruder): An overview of gradient descent optimization algorithms, Stand 15.06.2017, abgerufen am 22.11.2026. zurück
- arXiv (Kingma, Ba): Adam: A Method for Stochastic Optimization, Stand 30.01.2017, abgerufen am 22.11.2026. zurück
- PyTorch-Dokumentation 2.15: torch.optim, Stand 27.08.2026, abgerufen am 22.11.2026. zurück
- Goodfellow, Bengio, Courville: Deep Learning, Kapitel 6: Deep Feedforward Networks, Stand 2016, abgerufen am 22.11.2026. zurück