Lokale KI · Praxistest
Lokale Sprachmodelle auf 16 GB
Kurzantwort
Auf der RTX 5060 Ti mit 16 GB liefen Qwen3 8B und Qwen3 14B in Q4_K_M komplett im Grafikspeicher, mit 75,1 und 43,3 Token je Sekunde im Median1. Das reicht für flüssige Chats und das Zusammenfassen von Dokumenten. Qwen3 32B ist als Download 20 GB groß, knapp ein Drittel lag im Arbeitsspeicher, und das Tempo fiel auf 5,1 Token je Sekunde16.

Für lokale Sprachmodelle bis 14 Milliarden Parameter ist die RTX 5060 Ti mit 16 GB eine brauchbare Karte. In unserer Messreihe mit Ollama 0.40.0 erzeugte Qwen3 14B im Median 43,3 Token je Sekunde und blieb mit 9,3 GiB zusätzlichem Grafikspeicher deutlich unter der Grenze1. Qwen3 8B kam auf 75,1 Token je Sekunde1. Beim 32B-Modell beginnt die Auslagerung in den Arbeitsspeicher, und das Tempo fiel auf 5,1 Token je Sekunde1.
Sprachmodelle in Ollama auf der RTX 5060 Ti
- Hardware
- RTX 5060 Ti (16 GB), Treiber 621.35; AMD Ryzen 9 7950X3D, 128 GB
- Modell
- Qwen3 8B, 14B und 32B, jeweils Q4_K_M
- Werkzeug
- Ollama 0.40.0
- Messgröße
- Ausgabe-Token je Sekunde, Zeit bis zum ersten Token, zusätzlich belegter Grafikspeicher, Anteil auf dem Prozessor; Median aus drei Läufen
- Gemessen am
| Qwen3 8B: Token je Sekunde | 75,1 |
|---|---|
| Qwen3 14B: Token je Sekunde | 43,3 |
| Qwen3 32B: Token je Sekunde | 5,1 |
| Qwen3 8B: erstes Token | 0,07 s |
| Qwen3 14B: erstes Token | 0,09 s |
| Qwen3 32B: erstes Token | 1,13 s |
| Qwen3 8B: Grafikspeicher zusätzlich | 5,6 GiB |
| Qwen3 14B: Grafikspeicher zusätzlich | 9,3 GiB |
| Qwen3 32B: Grafikspeicher zusätzlich | 13,9 GiB |
| Qwen3 32B: Anteil auf dem Prozessor | 31,8 Prozent |
Kontext 8.192 Token, Temperatur 0, 256 Token Ausgabe, Denkmodus aus
Was in 16 GB hineinpasst
Die Download-Größen in der Ollama-Bibliothek geben eine erste Orientierung: Qwen3 8B in Q4_K_M ist 5,2 GB groß, Qwen3 14B 9,3 GB und Qwen3 32B 20 GB6. Dazu kommt im Betrieb der Speicher für den Kontext. In unserer Messung mit 8.192 Token Kontext belegte das 8B-Modell 5,6 GiB zusätzlich, das 14B-Modell 9,3 GiB1. Beide meldete Ollama mit 0 Prozent Anteil auf dem Prozessor, sie lagen also vollständig im Grafikspeicher1.
Mit dem 14B-Modell bleiben auf der Karte rund 6 GB frei1. Das ist Reserve für einen längeren Kontext, etwa für ein ganzes Kapitel eines Dokuments, oder für ein kleines zweites Programm. Wie schnell der Bedarf mit der Kontextlänge wächst, misst der Praxistest zu langen Kontexten auf der großen Karte; die Werte für den Speicher lassen sich auf die RTX 5060 Ti übertragen, denn der Bedarf folgt aus Modell und Kontextlänge.
Ein Detail aus unserem Aufbau solltest du kennen: Im Testrechner hängt der Bildschirm an der anderen Grafikkarte. Auf der RTX 5060 Ti waren vor dem Start deshalb nur 0,4 bis 0,5 GiB belegt1. Ist sie die einzige Karte im Rechner, zweigen Windows, Browser und andere Programme einen Teil der 16 GB ab, und für das Modell bleibt weniger übrig.
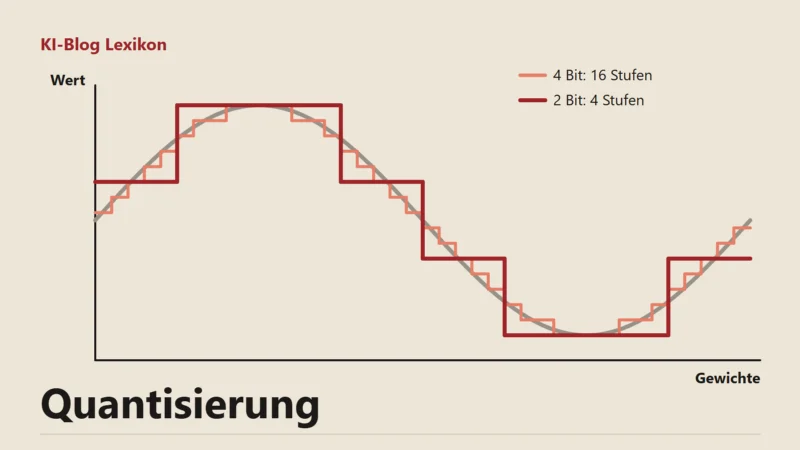
Das Speicherformat spielt auch eine Rolle. Alle drei Modelle liefen in der Quantisierung Q4_K_M, dem Standard der Ollama-Bibliothek für diese Modelle6. In acht Bit wäre schon das 14B-Modell 16 GB groß und würde die Karte allein füllen6.
Tempo der Modelle, die ganz passen
75,1 Token je Sekunde beim 8B-Modell und 43,3 beim 14B-Modell sind Werte, bei denen eine Antwort schneller entsteht, als du sie liest1. Für einen Chat, das Umformulieren von Mails oder das Zusammenfassen eines Berichts ist das flüssig. Die drei gezählten Läufe lagen eng beieinander, beim 14B-Modell zwischen 43,2 und 43,4 Token je Sekunde1.
Auch das erste Token kam schnell: nach 0,07 Sekunden beim 8B-Modell und nach 0,09 Sekunden beim 14B-Modell, bei einem Prompt mit knapp 90 Token1. Den Prompt las die Karte mit rund 2.356 Token je Sekunde beim 8B-Modell und 1.483 beim 14B-Modell1. Bei langen Dokumenten macht sich das bemerkbar: 10.000 Token Eingabe brauchen beim 14B-Modell nach dieser Rate knapp sieben Sekunden, bevor die Antwort beginnt (Rechenbeispiel)1.

- Hell RTX 5060 Ti mit 16 GB
- Dunkel RTX 4090 mit 24 GB
Wo die Auslagerung bremst
Qwen3 32B ist mit 20 GB größer als der gesamte Speicher der Karte6. Ollama verteilt ein solches Modell auf Grafikkarte und Prozessor; mit dem Befehl ollama ps siehst du die Aufteilung als Prozentangabe für CPU und GPU7. Der Teil im Arbeitsspeicher wird vom Prozessor gerechnet, und der ist bei dieser Aufgabe viel langsamer als die Grafikkarte. In unserer Messung legte Ollama 13,7 GiB des Modells auf die Karte und meldete 31,8 Prozent Anteil auf dem Prozessor1. Das Ergebnis: 5,1 Token je Sekunde im Median, die drei Läufe lagen zwischen 5,06 und 5,151. Eine Antwort mit 256 Token dauerte damit rund 51 Sekunden, das erste Token kam nach 1,13 Sekunden1. Gegenüber dem 14B-Modell, das ganz auf der Karte lag, ist das mehr als achtmal langsamer, obwohl das Modell nur gut doppelt so groß ist1.
Während dieser Läufe hatte die Grafikkarte im Mittel wenig zu tun: 17 bis 28 Prozent Last, 45 Watt im Median1. Sie wartete die meiste Zeit auf den Prozessor, der das knappe Drittel im Arbeitsspeicher rechnet.
Wie stark, hängt vor allem an diesem Anteil. Auf der RTX 4090 haben wir Llama 3.3 70B gemessen, bei dem fast die Hälfte im Arbeitsspeicher lag; dort kamen nur noch 1,8 Token je Sekunde heraus1. Je größer der Teil, den der Prozessor übernimmt, desto näher rückt das Tempo an das eines reinen Prozessorbetriebs. Wer ein Modell knapp über der Grenze nutzen will, sollte deshalb zuerst versuchen, es mit kleinerem Kontext oder in einer kleineren Stufe ganz auf die Karte zu bringen.
Für die Praxis heißt das: Mit 16 GB sind Modelle bis etwa 14 Milliarden Parameter in vier Bit die sinnvolle Obergrenze36. Ein größeres Modell lässt sich laden, wenn genug Arbeitsspeicher vorhanden ist, aber das Tempo fällt deutlich. Wer regelmäßig mit 30B-Modellen arbeiten will, braucht mehr Grafikspeicher.
Etwas Luft verschaffen zwei Einstellungen von Ollama. Flash Attention senkt den Speicherbedarf, vor allem bei wachsendem Kontext, und ist eingeschaltet, sofern Karte und Programm sie unterstützen7. Zusätzlich lässt sich der Zwischenspeicher für den Kontext mit der Variable OLLAMA_KV_CACHE_TYPE verkleinern: Die Stufe q8_0 braucht laut Dokumentation etwa halb so viel Speicher wie der Standard f16, bei sehr geringem Qualitätsverlust7. Ein 20-GB-Modell bekommst du damit trotzdem nicht in 16 GB, aber ein 14B-Modell mit langem Kontext bleibt länger vollständig auf der Karte.
Warum die Karte etwa halb so schnell ist
Beim Erzeugen jedes Tokens liest die Grafikkarte im Kern alle Gewichte des Modells einmal aus ihrem Speicher. Wie schnell der Speicher angebunden ist, bestimmt deshalb das Tempo. Die RTX 5060 Ti hat GDDR7 an einer Schnittstelle mit 128 Bit4. Multipliziert man die Modellgröße, die Ollama meldet, mit den gemessenen Token je Sekunde, liest die Karte bei beiden Modellen rund 400 GiB je Sekunde (unsere Rechnung)1. Auf der RTX 4090 mit ihrer 384-Bit-Schnittstelle kommt dieselbe Rechnung auf rund 780 GiB je Sekunde, entsprechend schneller ist sie dort15. Die vollständige Messreihe der großen Karte steht im Praxistest zur RTX 4090.
Die Rechenleistung der Karte spielt beim Antworten eine kleinere Rolle. Sie zeigt sich beim Einlesen des Prompts, bei dem viele Token auf einmal verarbeitet werden. NVIDIA gibt für die RTX 5060 Ti 4.608 CUDA-Recheneinheiten an4.
Strom: wenig Watt, gleiche Energie je Token
Die Karte zog während der Läufe laut nvidia-smi im Median 157 Watt beim 8B-Modell und 165 Watt beim 14B-Modell1. NVIDIA nennt eine Leistungsaufnahme der Karte von 180 Watt und empfiehlt ein Netzteil mit 600 Watt4. Im Leerlauf vor den Läufen lag die Karte bei 4 bis 8 Watt1.
Teilt man die Token je Sekunde durch die Watt, kommt die RTX 5060 Ti auf fast genau dieselbe Zahl von Token je Wattsekunde wie die RTX 4090 mit demselben Modell (ebenfalls aus den Messwerten errechnet)1. Die kleine Karte braucht für eine Antwort also etwa doppelt so lange, zieht dabei aber nur rund halb so viel Leistung. Die Kosten je Antwort in Cent stehen im Praxistest zum Stromverbrauch.
Preis je Leistung
Zur Markteinführung im April 2025 nannte NVIDIA für die RTX 5060 Ti mit 16 GB einen Preis ab 429 US-Dollar2. Die RTX 4090 kam im Oktober 2022 für 1.599 US-Dollar auf den Markt8. Beide Angaben sind Einführungspreise in den USA; was die Karten heute im Handel kosten, schwankt und steht hier nicht.
Setzt man die Einführungspreise ins Verhältnis zum gemessenen Tempo mit Qwen3 14B, liefert die RTX 5060 Ti rund 10 Token je Sekunde je 100 US-Dollar, die RTX 4090 rund 5 (Rechnung der Redaktion aus Messwerten und Einführungspreisen)128. Für Modelle, die in 16 GB passen, bekommst du mit der kleinen Karte also mehr Tempo fürs Geld. Der Vorteil endet dort, wo das Modell nicht mehr in den Speicher passt: Für 30B-Modelle und lange Kontexte zahlst du bei der großen Karte vor allem für die zusätzlichen 8 GB45. Eine Übersicht, welche Karte zu welchem Zweck passt, gibt der Ratgeber zur Grafikkarte für KI.
Vorsicht beim Kauf: Die RTX 5060 Ti gibt es auch mit 8 GB, zur Einführung für 379 US-Dollar2. Für Sprachmodelle ist der Aufpreis zur 16-GB-Fassung gut angelegt. Unser 14B-Modell belegte allein 9,3 GiB und hätte auf der kleinen Fassung nicht mehr vollständig Platz gehabt, nur das 8B-Modell mit 5,6 GiB wäre noch ganz auf die Karte gegangen1.
Protokoll der Messung
Gemessen haben wir auf einem PC mit Ryzen 9 7950X3D von AMD und 128 GB RAM, in dem die RTX 5060 Ti neben einer RTX 4090 steckt1. Grafiktreiber 621.35, CUDA 13.5 laut Treiber, Ollama 0.40.01. Für die RTX 5060 Ti lief ein eigener Ollama-Server, der über CUDA_VISIBLE_DEVICES nur diese Karte sah1. So konnte kein Modell heimlich auf die große Karte ausweichen.
Zu Beginn jeder Messung stellte das Skript fünf Sekunden lang sicher, dass die Karte frei war, also unter zehn Prozent Last blieb1. Danach kamen ein Aufwärmlauf, der das Modell lädt und nicht zählt, und drei gezählte Läufe. Jeder Lauf dauerte mindestens acht Sekunden, weil nvidia-smi Leistung und Speicher nur einmal je Sekunde meldet; beim teilweise ausgelagerten 32B-Modell galt diese Mindestdauer nicht1. In den Messwertkasten kommt der Median der drei Läufe.
Alle Modelle bekamen denselben deutschen Prompt und liefen mit Temperatur 0, festem Startwert, 256 Token Ausgabe und einem Kontext von 8.192 Token1. Den Kontext haben wir festgelegt, weil Ollama ihn sonst nach dem Grafikspeicher wählt; unter 24 GiB sind das 4k Token9. Der Denkmodus von Qwen3 war abgeschaltet, damit nur der Antworttext zählt13.
Für wen 16 GB reichen
Wer lokal chatten, Texte umformulieren, Dokumente zusammenfassen oder einen Kontext von einigen Zehntausend Token nutzen will, kommt mit der RTX 5060 Ti und einem 8B- oder 14B-Modell gut zurecht. Die Karte braucht wenig Strom, NVIDIA empfiehlt für einen Rechner mit ihr ein Netzteil mit 600 Watt4.
Knapp wird es, wenn du die größten offenen Modelle ausprobieren oder ein Sprachmodell und ein Bildmodell gleichzeitig auf derselben Karte halten willst. Dann wird der Speicher knapp, während das Tempo für einzelne Modelle weiter reicht. Modelle der einzelnen Größenklassen stellt der Vergleich lokaler Sprachmodelle vor.
Die Messung deckt ein Werkzeug, eine Modellfamilie und eine Quantisierungsstufe ab. Andere Modelle gleicher Größe und Stufe dürften im Tempo ähnlich liegen, weil die Speicheranbindung den Ausschlag gibt; gemessen haben wir sie nicht, und ihr Speicherbedarf für den Kontext kann sich unterscheiden.
Was das für dich heißt
Mit 16 GB fährst du am besten mit Modellen bis 14 Milliarden Parametern in vier Bit.
- Wähle ein 14B-Modell in Q4_K_M als Standard für Chat und Zusammenfassungen.
- Prüfe mit ollama ps, ob dort 100% GPU steht, bevor du dich über langsame Antworten wunderst.
- Rechne beim Kauf mit dem Speicher, den Windows und Browser auf derselben Karte belegen.
- Greife zu einer Karte mit mehr Speicher, wenn du regelmäßig 30B-Modelle nutzen willst.
Häufige Fragen
Ist die RTX 5060 Ti mit 16 GB gut für lokale KI?
Für Sprachmodelle bis 14 Milliarden Parameter in vier Bit ja. In unserer Messung schaffte Qwen3 14B 43,3 Token je Sekunde komplett im Grafikspeicher.
Welche Modelle passen in 16 GB VRAM?
In Q4_K_M passten Qwen3 8B und 14B mit Kontext 8.192 vollständig auf die Karte. Qwen3 32B ist mit 20 GB zu groß; knapp ein Drittel landete im Arbeitsspeicher, und es kamen nur noch 5,1 Token je Sekunde heraus.
Wie viel langsamer ist die RTX 5060 Ti als die RTX 4090?
Mit demselben Modell erreichte sie in unserer Messung etwa die Hälfte der Token je Sekunde. Der Hauptgrund ist die schmalere Speicheranbindung.
Wie viel Strom braucht die Karte beim Antworten?
Rund 157 bis 165 Watt laut nvidia-smi, je nach Modell. Je erzeugtem Token war das fast genauso viel Energie wie bei der RTX 4090.
Quellen
Stand:
- Eigene Messung: Messreihe Ollama 0.40.0 auf RTX 5060 Ti (16 GB) und RTX 4090 (Treiber 621.35, CUDA 13.5), Testrechner Ryzen 9 7950X3D, 128 GB; qwen3:8b, qwen3:14b, qwen3:32b in Q4_K_M, Kontext 8192, Temperatur 0, 256 Ausgabe-Token, Aufwärmlauf und drei Läufe, Median, Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- NVIDIA: Pressemitteilung: GeForce RTX 5060 Familie ab 299 US-Dollar, Stand 15.04.2025, abgerufen am 22.11.2026. zurück
- Qwen (Alibaba): Modellkarte Qwen3-14B, abgerufen am 22.11.2026. zurück
- NVIDIA: GeForce RTX 5060 Familie: technische Daten, abgerufen am 22.11.2026. zurück
- NVIDIA: GeForce RTX 4090: technische Daten, abgerufen am 22.11.2026. zurück
- Ollama: Bibliothek: qwen3, Tags und Größen, abgerufen am 22.11.2026. zurück
- Ollama: Häufige Fragen (FAQ), abgerufen am 22.11.2026. zurück
- NVIDIA: Pressemitteilung: GeForce RTX 40 Serie, Stand 20.09.2022, abgerufen am 22.11.2026. zurück
- Ollama: Kontextlänge (Dokumentation), abgerufen am 22.11.2026. zurück