Lokale KI · Praxistest
Bildmodelle in ComfyUI gemessen
Kurzantwort
In ComfyUI 0.46.0 brauchte SDXL mit 20 Schritten bei 1024 x 1024 Pixeln auf der RTX 4090 im Median 3,01 Sekunden je Bild, auf der RTX 5060 Ti 8,05 Sekunden1. FLUX.1 schnell kam auf der RTX 4090 mit 4 Schritten auf 2,80 Sekunden je Bild, belegte aber 18,5 GiB Grafikspeicher1. Je Karte und Modell liefen drei Durchgänge mit 20 Bildern.

Eine RTX 4090 erzeugt mit SDXL ein Bild in 1024 x 1024 Pixeln in rund drei Sekunden, die RTX 5060 Ti braucht für dasselbe Bild gut acht1. Gemessen haben wir das in ComfyUI 0.46.0, auf der großen Karte zusätzlich mit FLUX.1 schnell, das mit 2,80 Sekunden je Bild kaum schneller war als SDXL1. Beide Modelle liefen mit derselben deutschen Bildbeschreibung, je 20 Bilder hintereinander und in drei gezählten Läufen1. FLUX.1 schnell braucht nur vier Rechenschritte, SDXL zwanzig, dafür ist das Flux-Modell deutlich größer und belegte mehr als doppelt so viel Grafikspeicher13.
Bildmodelle in ComfyUI auf zwei Grafikkarten
- Hardware
- RTX 4090 (24 GB) und RTX 5060 Ti (16 GB), Treiber 621.35; AMD Ryzen 9 7950X3D, 128 GB
- Modell
- SDXL base 1.0 (fp16) und FLUX.1 schnell (fp8)
- Werkzeug
- ComfyUI 0.46.0 mit PyTorch 2.14.1+cu130
- Messgröße
- Sekunden je Bild, zusätzlich belegter Grafikspeicher, Leistungsaufnahme der Karte; 1024 x 1024 Pixel, 20 Bilder je Lauf, Median aus drei Läufen
- Gemessen am
| SDXL, RTX 4090: Sekunden je Bild | 3,01 s |
|---|---|
| SDXL, RTX 5060 Ti: Sekunden je Bild | 8,05 s |
| FLUX.1 schnell, RTX 4090: Sekunden je Bild | 2,80 s |
| SDXL, RTX 4090: Grafikspeicher zusätzlich | 9,2 GiB |
| SDXL, RTX 5060 Ti: Grafikspeicher zusätzlich | 9,3 GiB |
| FLUX.1 schnell, RTX 4090: Grafikspeicher zusätzlich | 18,5 GiB |
| SDXL, RTX 4090: Leistungsaufnahme der Karte | 387 W |
| SDXL, RTX 5060 Ti: Leistungsaufnahme der Karte | 167 W |
| FLUX.1 schnell, RTX 4090: Leistungsaufnahme der Karte | 383 W |
SDXL 20 Schritte, CFG 7; FLUX.1 schnell 4 Schritte, CFG 1; Sampler Euler
Zwei Modelle mit unterschiedlicher Bauart
SDXL von Stability AI ist ein Latent-Diffusion-Modell, das mit zwei Textencodern arbeitet, OpenCLIP-ViT/G und CLIP-ViT/L2. Es steht unter der Lizenz CreativeML Open RAIL++-M2. Die Grundfassung lässt sich allein nutzen, optional übernimmt ein zweites Modell, der Refiner, die letzten Schritte2. Für diese Messung lief nur die Grundfassung. Unsere Datei in 16 Bit ist 6,94 GB groß1.
FLUX.1 schnell von Black Forest Labs ist ein Transformer mit 12 Milliarden Parametern nach dem Verfahren Rectified Flow3. Durch eine besondere Form der Destillation kommt es laut Modellkarte mit einem bis vier Schritten aus3. Es steht unter Apache 2.0 und darf ausdrücklich auch kommerziell genutzt werden3. Wir verwenden die Einzeldatei von Comfy-Org mit Gewichten in 8 Bit (fp8), die alle Teile in einer Datei bündelt; sie ist 17,24 GB groß1.
Die verwandte Fassung FLUX.1 dev steht unter einer Lizenz für nicht kommerzielle Nutzung4. Weil ki-blog.de Werbung zeigt, haben wir dieses Modell weder gemessen noch Bilder damit erzeugt. Was die Lizenzen der Bildmodelle im Einzelnen erlauben, behandelt die Seite zur lokalen Bildgenerierung.
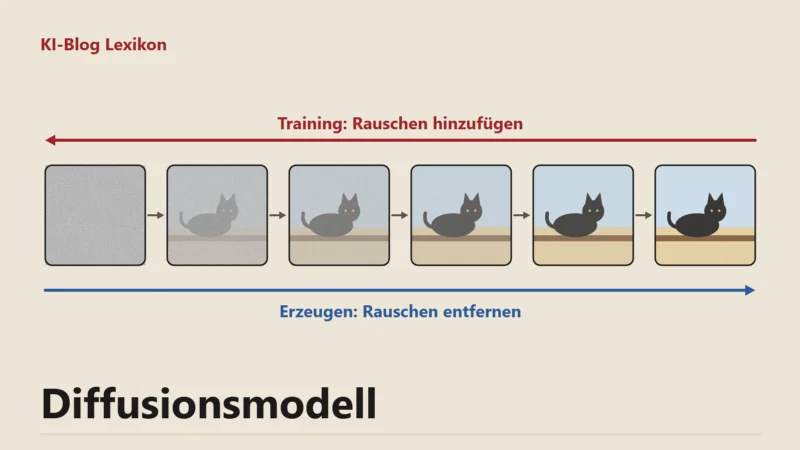
Beide Modelle gehören zur Familie der Diffusionsmodelle im weiteren Sinn: Sie beginnen mit Rauschen und formen daraus Schritt für Schritt ein Bild, gesteuert durch die Beschreibung. Die Zahl der Schritte bestimmt deshalb einen großen Teil der Rechenzeit.
So lief die Messung
Auf dem Testrechner, ausgestattet mit 128 GB Arbeitsspeicher und dem Prozessor Ryzen 9 7950X3D von AMD, lief ComfyUI als Windows-Paket für NVIDIA in Version 0.46.0 mit PyTorch 2.14.1 für CUDA 13.0, unter dem Grafiktreiber 621.351. Je Karte lief eine eigene Instanz: Port 8188 sah nur die RTX 4090, Port 8189 nur die RTX 5060 Ti1. FLUX.1 schnell stand im Messplan nur für die RTX 4090.
Das Messskript schickt jedes Bild als eigenen Auftrag über die Schnittstelle von ComfyUI und stoppt die Zeit vom Absenden bis zur Meldung "fertig". In dieser Zeit stecken also alle Schritte des Samplers, das Umrechnen in Pixel durch den VAE-Decoder und das Speichern der Datei1. Das Laden des Modells zählt nicht mit, weil ein nicht gezählter Aufwärmlauf es vorher in den Speicher holt. Ein Lauf besteht aus 20 Bildern mit wechselndem Startwert, gezählt wird der Mittelwert je Bild, und aus drei Läufen bilden wir den Median1.
Die Einstellungen waren:
- Auflösung 1024 x 1024 Pixel, ein Bild je Auftrag1
- SDXL: 20 Schritte, Sampler Euler, Scheduler normal, CFG 71
- FLUX.1 schnell: 4 Schritte, Sampler Euler, CFG 11
- Bildbeschreibung auf Deutsch: ein aufgeräumter Schreibtisch am Fenster mit zwei Bildschirmen und einer Tasse Kaffee im Morgenlicht; als negative Beschreibung "text, watermark, blurry"
Gestartet wurde eine Messung erst, wenn die Karte fünf Sekunden lang unter zehn Prozent Last blieb; andere Programme beendete es nicht1. Die Messung lief in einem Zeitfenster, in dem die Bildproduktion des Blogs auf beiden Karten pausierte, denn dieselben Karten erzeugen sonst die Titelbilder. Leistung, Grafikspeicher und Temperatur las nvidia-smi im Sekundentakt mit1.
Was die Sekunden je Bild bedeuten
SDXL brauchte auf der RTX 4090 im Median 3,01 Sekunden je Bild, auf der RTX 5060 Ti 8,05 Sekunden1. Auf der großen Karte war das schnellste der 60 gezählten Bilder nach 2,85 Sekunden fertig, das langsamste nach 3,25 Sekunden1. Die Karte zog dabei im Median 387 Watt, in der Spitze 466 Watt, und belegte bis zu 9,2 GiB Grafikspeicher zusätzlich zum Desktop1.
FLUX.1 schnell war auf der RTX 4090 mit 2,80 Sekunden je Bild im Median etwas schneller als SDXL; die Bilder eines Laufs lagen zwischen 2,60 und 3,05 Sekunden1. Die Karte zog dabei im Median 383 Watt und belegte 18,5 GiB zusätzlich1.
Für den Alltag zählt, wie lange du auf eine brauchbare Auswahl wartest. Wer eine Bildidee in mehreren Fassungen ausprobiert und dann das beste Bild heraussucht, rechnet die Wartezeit einfach hoch: Sekunden je Bild mal Anzahl der Bilder. Acht Varianten mit SDXL dauern auf der RTX 4090 also rund 24 Sekunden (Rechenbeispiel)1.
Bei SDXL hängt die Zeit vor allem an der Zahl der Schritte, denn jeder Schritt ist ein vollständiger Durchlauf durch das Modell. Wer mehr als unsere 20 Schritte einstellt, wartet entsprechend länger. FLUX.1 schnell ist auf wenige Schritte trainiert; mehr Schritte bringen dort laut Hersteller keinen Gewinn, weil das Modell für eins bis vier ausgelegt ist3.
Das erste Bild nach dem Start dauert länger, weil ComfyUI das Modell von der SSD laden muss. Bei der Flux-Datei mit 17,24 GB macht das spürbar etwas aus1. Unsere Werte gelten für den Fall, dass das Modell schon geladen ist.

- Balken Sekunden je Bild
- Zahl dahinter Grafikspeicher und Watt
Warum vier Schritte nicht fünfmal schneller sind
Auf den ersten Blick müsste FLUX.1 schnell mit vier Schritten fünfmal so schnell sein wie SDXL mit zwanzig. Jeder einzelne Schritt läuft bei Flux durch einen Transformer mit 12 Milliarden Parametern3. SDXL ist deutlich kleiner, das zeigt schon die Dateigröße: 6,94 GB in 16 Bit gegen 17,24 GB für Flux in 8 Bit, obwohl 8 Bit nur halb so viel Platz je Gewicht braucht1. Ein Flux-Schritt kostet also erheblich mehr Rechenzeit als ein SDXL-Schritt.
Dazu kommen die Teile, die bei beiden Modellen unabhängig von der Schrittzahl anfallen: das Umrechnen der Beschreibung durch die Textencoder vor dem ersten Schritt und das Umrechnen des fertigen Ergebnisses in Pixel durch den VAE-Decoder danach. Bei wenigen Schritten dürften diese festen Anteile einen größeren Teil der Gesamtzeit ausmachen; die Einzelzeiten haben wir nicht gemessen. Auf der RTX 4090 ergab sich am Ende ein knapper Abstand: 2,80 Sekunden je Bild für FLUX.1 schnell gegen 3,01 Sekunden für SDXL, Flux war also nur rund 7 Prozent schneller1.
Der Workflow zum Nachbauen
ComfyUI baut jede Bilderzeugung aus Knoten auf, die in einem Graphen verbunden sind7. Unser Messworkflow ist der kleinste, der ein Bild ergibt, und besteht aus sieben Knoten: Ein Lader öffnet die Modelldatei, zwei Textencoder verarbeiten die positive und die negative Beschreibung, ein Knoten legt ein leeres Bild in der Zielgröße an, der Sampler rechnet die Schritte, der VAE-Decoder macht daraus Pixel, und der letzte Knoten speichert die Datei1. Beide Modelle liefen mit genau diesem Aufbau, nur Schrittzahl und CFG unterscheiden sich.
Jedes der 20 Bilder eines Laufs bekam einen anderen Startwert, damit ComfyUI kein Ergebnis aus dem Zwischenspeicher wiederverwendet1. Neben dem Mittelwert je Lauf hält das Protokoll auch das schnellste und das langsamste Bild fest. So fällt auf, wenn einzelne Bilder aus der Reihe tanzen, etwa weil ein Hintergrundprogramm kurz Leistung abzieht.
Grafikspeicher und die kleinere Karte
Der belegte Grafikspeicher entscheidet, ob ein Modell auf einer Karte flüssig läuft. Die RTX 4090 hat 24 GB GDDR6X5. Unsere Flux-Datei ist mit 17,24 GB schon größer als der gesamte Speicher einer 16-GB-Karte, und im Betrieb belegte FLUX.1 schnell auf der RTX 4090 18,5 GiB zusätzlich zum Desktop1. Mit Desktop lag die Karte damit bei 20,2 von 24,0 GiB1.
Auf der RTX 5060 Ti mit 16 GB GDDR7 haben wir SDXL gemessen6. Sie brauchte im Median 8,05 Sekunden je Bild, also rund 2,7-mal so lange wie die RTX 4090, und belegte 9,3 GiB zusätzlich1. Die drei Durchgänge lagen zwischen 8,03 und 8,11 Sekunden, die Karte zog im Median 167 Watt und in der Spitze 183 Watt1. Für SDXL reichen 16 GB also gut aus, das Modell lag komplett auf der Karte.
FLUX.1 schnell haben wir auf der RTX 5060 Ti nicht gemessen. Ob es auf 16 GB läuft, lässt sich deshalb nur nach den Angaben der Entwickler beantworten: ComfyUI bringt nach eigener Beschreibung eine Speicherverwaltung mit, die Teile von Modellen zwischen Grafikspeicher und Arbeitsspeicher verschiebt, und unterstützt quantisierte Modelle7. Das Modell sollte also laden, aber langsamer rechnen als auf einer Karte, auf der es ganz Platz hat; wie groß der Abstand ist, bleibt offen. Bei Sprachmodellen zeigt der Praxistest zur RTX 5060 Ti, wie stark Auslagerung bremst.
Die SDXL-Datei ist mit knapp 7 GB in 16 Bit deutlich kleiner und bleibt unter dem Speicher einer Karte mit 12 GB1. Auf kleineren Karten ist SDXL deshalb die Wahl mit weniger Speicherdruck.
Bildqualität: nicht bewertet
Tempo allein sagt wenig, wenn die Bilder nicht taugen. Beide Modelle bekamen dieselbe Beschreibung. Auf dem Titelbild dieser Seite siehst du die Warteschlange von ComfyUI mit den Zeiten je Bild.
Die Modellkarte von SDXL nennt selbst die typischen Schwächen: kein perfekter Fotorealismus, keine lesbare Schrift im Bild, Probleme mit Anordnungen wie "ein roter Würfel auf einer blauen Kugel" und teils falsch gezeichnete Gesichter und Personen2. Unsere Testbeschreibung mit Schreibtisch, zwei Bildschirmen und Tasse ist bewusst eine Szene mit mehreren Gegenständen in fester Anordnung, also genau die Art Aufgabe, an der solche Schwächen sichtbar werden.
Eine Bewertung der Bildqualität mit Noten haben wir nicht vorgenommen. Der Eindruck hängt stark vom Motiv ab, und schon eine andere Beschreibung kann das Bild zugunsten des einen oder anderen Modells drehen. Wer sich entscheiden will, erzeugt am besten zehn Bilder zu einem eigenen typischen Motiv mit beiden Modellen und vergleicht selbst.
Ein Hinweis zur Sprache: Wir haben die Beschreibung auf Deutsch gegeben, damit der Test zum Alltag deutschsprachiger Nutzer passt. Ob die Modelle deutsche Beschreibungen genauso gut umsetzen wie englische, haben wir nicht geprüft, eine englische Fassung kann andere Bilder ergeben. Für den Zeitvergleich spielt das keine Rolle, für die Qualität möglicherweise schon.
Strom je Bild
nvidia-smi meldet während der Läufe die Leistungsaufnahme der Karte im Sekundentakt1. Aus Watt und Sekunden je Bild ergibt sich die Energie je Bild in Wattstunden. Für SDXL auf der RTX 4090 sind das 387 Watt mal 3,01 Sekunden, also rund 0,32 Wattstunden je Bild, nur für die Grafikkarte (Rechnung aus den Messwerten)1. Die RTX 5060 Ti braucht mit 167 Watt und 8,05 Sekunden rund 0,37 Wattstunden, also etwas mehr Energie je Bild als die große Karte1. FLUX.1 schnell kommt auf der RTX 4090 mit 383 Watt und 2,80 Sekunden auf rund 0,30 Wattstunden je Bild1. Cent-Beträge für die Karte allein behandelt der Praxistest zum Stromverbrauch. Dort steht auch eine eigene Messung mit SDXL und zehn Bildern je Lauf.
Einordnung und Grenzen
Die Messung zeigt, was eine RTX 4090 mit Standardeinstellungen schafft. Optimierte Workflows mit anderen Datentypen, anderen Samplern, Erweiterungen oder mehreren Bildern je Auftrag können andere Zeiten ergeben; das haben wir nicht gemessen. Wir haben bewusst einfach gemessen, mit einem Bild je Auftrag und dem einfachsten Workflow aus Lader, Textencoder, Sampler, Decoder und Speichern, damit sich die Werte mit einer frischen Installation nachstellen lassen.
Die Zeit je Bild schwankt außerdem mit der Auflösung. Ein Bild mit doppelter Kantenlänge hat viermal so viele Bildpunkte. Wer andere Formate rechnet, etwa 16:9 für Titelbilder, kommt auf andere Zeiten.
Wer die Werte auf dem eigenen Rechner nachprüfen will, braucht kein Messskript. ComfyUI zeigt nach jedem Auftrag im Konsolenfenster an, wie lange er gedauert hat. Lass zuerst ein Bild rechnen, das du nicht zählst, damit das Modell geladen ist, und stelle dann zehn oder zwanzig Bilder mit derselben Beschreibung in die Warteschlange. Der Mittelwert dieser Zeiten ist mit unseren Werten vergleichbar, solange Auflösung, Schritte und Sampler übereinstimmen. Läuft nebenher ein Spiel, ein Video oder ein Sprachmodell auf derselben Karte, verfälscht das jede Messung.
Die Installation von ComfyUI und das Ablegen der Modelle in die richtigen Ordner beschreibt die Anleitung ComfyUI installieren. Welche Grafikkarte sich für Bildmodelle eignet, steht im Kaufratgeber Grafikkarte für KI. Was Text-zu-Bild grundsätzlich bedeutet, steht im Lexikon.
Was das für dich heißt
Für SDXL reichen auch 16 GB, bei FLUX.1 schnell wird der Speicher kleinerer Karten knapp.
- Rechne die Wartezeit für deine übliche Zahl von Varianten mit den Sekunden je Bild hoch.
- Teste beide Modelle mit zehn Bildern zu einem eigenen typischen Motiv.
- Prüfe vor jeder Veröffentlichung die Lizenz des Modells auf der Modellkarte.
- Lass das Modell geladen, wenn du viele Bilder hintereinander erzeugst.
Häufige Fragen
Wie schnell ist ComfyUI auf der RTX 4090?
Bei 1024 x 1024 Pixeln brauchte SDXL mit 20 Schritten im Median 3,01 Sekunden je Bild, FLUX.1 schnell mit 4 Schritten 2,80 Sekunden. Gemessen ist die Zeit bei geladenem Modell, als Median aus drei Läufen mit je 20 Bildern.
Läuft FLUX.1 schnell auf einer RTX 5060 Ti mit 16 GB?
Die fp8-Datei ist mit 17,24 GB größer als der Speicher der Karte, ComfyUI muss dann Teile in den Arbeitsspeicher verschieben. Gemessen haben wir auf der RTX 5060 Ti nur SDXL, mit 8,05 Sekunden je Bild.
Warum fehlt FLUX.1 dev?
FLUX.1 dev steht unter einer Lizenz für nicht kommerzielle Nutzung. ki-blog.de zeigt Werbung, deshalb haben wir nur FLUX.1 schnell unter Apache 2.0 getestet.
Zählt die Ladezeit des Modells mit?
Nein. Ein Aufwärmlauf lädt das Modell vorher, gemessen wird die Zeit je Bild bei geladenem Modell, einschließlich Decoder und Speichern.
Quellen
Stand:
- Eigene Messung: Messreihe ComfyUI 0.46.0 (Windows-Paket nvidia, PyTorch 2.14.1+cu130) auf RTX 4090, Treiber 621.35; SDXL base 1.0 fp16 (6,94 GB) und FLUX.1 schnell fp8 (17,24 GB), 1024 x 1024, 20 Bilder je Lauf, drei Läufe, Median, Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- Stability AI: Modellkarte stable-diffusion-xl-base-1.0, abgerufen am 22.11.2026. zurück
- Black Forest Labs: Modellkarte FLUX.1 [schnell], abgerufen am 22.11.2026. zurück
- Black Forest Labs: Modellkarte FLUX.1 [dev] (Lizenz), abgerufen am 22.11.2026. zurück
- NVIDIA: GeForce RTX 4090: technische Daten, abgerufen am 22.11.2026. zurück
- NVIDIA: GeForce RTX 5060 Familie: technische Daten, abgerufen am 22.11.2026. zurück
- Comfy-Org: ComfyUI auf GitHub (README), abgerufen am 22.11.2026. zurück