Lokale KI · Praxistest
Lokale Sprachmodelle auf der RTX 4090
Kurzantwort
In Ollama auf der RTX 4090 schaffte Qwen3 8B im Median 145,9 Token je Sekunde, Qwen3 14B 85,7 und Qwen3 32B 39,7, alle in Q4_K_M und vollständig im Grafikspeicher1. Mit 32 Milliarden Parametern ist die Karte praktisch voll. Llama 3.3 70B ist als Download 43 GB groß, knapp die Hälfte lag im Arbeitsspeicher, und das Tempo fiel auf 1,8 Token je Sekunde15.

Mit 24 GB Grafikspeicher führt die RTX 4090 Sprachmodelle bis etwa 32 Milliarden Parameter in vier Bit komplett auf der Karte aus. In unserer Messreihe mit Ollama 0.40.0 erzeugte Qwen3 32B im Median 39,7 Token je Sekunde und belegte dabei 20,1 GiB zusätzlich zum Desktop1. Die kleineren Qwen3-Modelle mit 8 und 14 Milliarden Parametern sind entsprechend schneller. Mit Llama 3.3 70B reicht der Speicher nicht mehr: Knapp die Hälfte des Modells lag im Arbeitsspeicher, und es kamen nur noch 1,8 Token je Sekunde heraus1.
Sprachmodelle in Ollama auf der RTX 4090
- Hardware
- RTX 4090 (24 GB), Treiber 621.35; AMD Ryzen 9 7950X3D, 128 GB
- Modell
- Qwen3 8B, 14B, 32B und Llama 3.3 70B, jeweils Q4_K_M
- Werkzeug
- Ollama 0.40.0
- Messgröße
- Ausgabe-Token je Sekunde, Zeit bis zum ersten Token, zusätzlich belegter Grafikspeicher; Median aus drei Läufen
- Gemessen am
| Qwen3 8B: Token je Sekunde | 145,9 |
|---|---|
| Qwen3 14B: Token je Sekunde | 85,7 |
| Qwen3 32B: Token je Sekunde | 39,7 |
| Llama 3.3 70B: Token je Sekunde | 1,8 |
| Qwen3 8B: erstes Token | 0,04 s |
| Qwen3 14B: erstes Token | 0,05 s |
| Qwen3 32B: erstes Token | 0,08 s |
| Llama 3.3 70B: erstes Token | 0,92 s |
| Qwen3 8B: Grafikspeicher zusätzlich | 5,7 GiB |
| Qwen3 14B: Grafikspeicher zusätzlich | 9,6 GiB |
| Qwen3 32B: Grafikspeicher zusätzlich | 20,1 GiB |
| Llama 3.3 70B: Grafikspeicher zusätzlich | 20,9 GiB |
| Llama 3.3 70B: Anteil auf dem Prozessor | 48,1 Prozent |
Kontext 8.192 Token, Temperatur 0, 256 Token Ausgabe, Denkmodus aus
Die Messreihe in Zahlen
Gemessen haben wir am 22.11.2026 drei Modelle der Familie Qwen3 und Llama 3.3 70B, alle in der Quantisierungsstufe Q4_K_M aus der Ollama-Bibliothek156. Jedes Modell bekam denselben deutschen Prompt. Die Qwen3-Modelle zählten dafür 88 bis 89 Token, Llama 3.3 zählte 79 bis 80, und alle sollten 256 Token Antwort erzeugen1.
Qwen3 8B, laut Modellkarte 8,2 Milliarden Parameter, kam im Median auf 145,9 Token je Sekunde12. Das ist schneller, als irgendjemand mitlesen kann. Qwen3 14B mit 14,8 Milliarden Parametern lag bei 85,7 Token je Sekunde, Qwen3 32B mit 32,8 Milliarden bei 39,7134. Die Streuung zwischen den drei gezählten Läufen war klein: Beim 8B-Modell lagen die Läufe zwischen 145,7 und 146,0 Token je Sekunde, beim 32B-Modell zwischen 39,5 und 40,51.
Auch 39,7 Token je Sekunde sind für einen Chat flüssig, eine Antwort mit einer halben Seite steht nach wenigen Sekunden da. Was Tokens pro Sekunde im Verhältnis zum Lesetempo bedeuten, erklärt das Lexikon.

- Balken Ausgabe-Token je Sekunde
- Zahl dahinter zusätzlich belegter Grafikspeicher
Warum das Tempo mit der Modellgröße fällt
Für jedes neue Token muss die Grafikkarte im Kern alle Gewichte des Modells einmal aus dem Speicher lesen. Das Tempo hängt deshalb vor allem von der Geschwindigkeit des Grafikspeichers ab. Unsere Werte zeigen das deutlich: Ollama meldete für die drei Qwen3-Modelle eine Größe im Grafikspeicher von 5,3, 9,2 und 19,7 GiB1. Multipliziert man diese Größe mit den gemessenen Token je Sekunde, ergibt sich bei allen drei Modellen fast derselbe Wert von rund 780 GiB, die die Karte je Sekunde aus dem Speicher liest (Rechnung der Redaktion aus den Messwerten)1. Doppelt so viele Gewichte bedeuten also ungefähr halb so viele Token je Sekunde.
Die RTX 4090 hat GDDR6X-Speicher an einer 384-Bit-Schnittstelle9. Diese breite Anbindung ist der Grund, warum sie bei Sprachmodellen so weit vor kleineren Karten liegt. Wie viel langsamer die RTX 5060 Ti mit ihrer schmaleren Anbindung ist, steht im eigenen Praxistest mit 16 GB.
Was auf 24 GB passt
Der Grafikspeicher ist die harte Grenze. Bei unseren Messungen belegten Desktop, Browser und andere Programme schon vor dem Start rund 2,4 GiB der 24 GB1. Darauf kamen beim 8B-Modell 5,7 GiB, beim 14B-Modell 9,6 GiB und beim 32B-Modell 20,1 GiB1. Die Spitze lag mit Qwen3 32B bei 22,5 von 24,0 GiB1. Ollama meldete für alle drei Modelle 0 Prozent Auslagerung auf den Prozessor1.
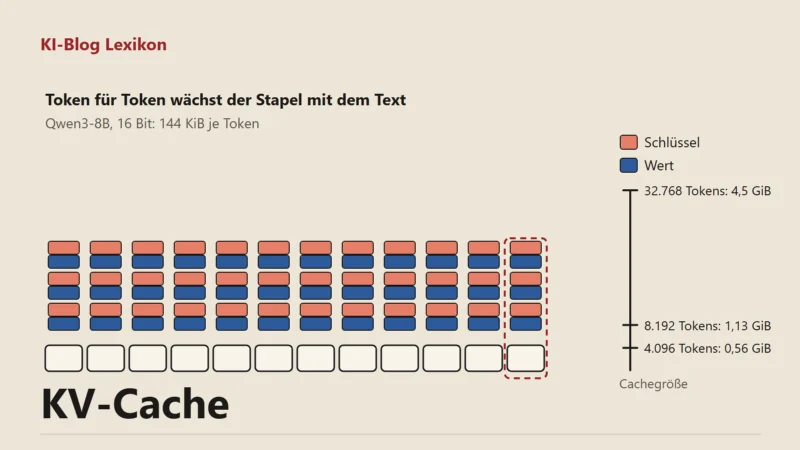
Diese Werte gelten für einen Kontext von 8.192 Token1. Jedes Token im Kontext belegt zusätzlich Platz im KV-Cache, und bei Qwen3 32B bleibt dafür kaum Reserve. Wer längere Dokumente verarbeiten will, landet mit dem 32B-Modell schnell bei der Auslagerung oder muss auf das 14B-Modell zurückgehen. Wie stark der Speicher mit dem Kontext wächst, zeigt unsere Reihe zur Kontextlänge.
Ollama zeigt mit dem Befehl ollama ps, wie ein geladenes Modell verteilt ist. Steht dort "100% GPU", liegt es vollständig im Grafikspeicher; eine Angabe mit CPU-Anteil heißt, dass ein Teil im Arbeitsspeicher liegt7. Das lohnt sich nach jedem Wechsel von Modell oder Kontextlänge zu prüfen.
Die Grenze: Llama 3.3 mit 70 Milliarden Parametern
Llama 3.3 70B ist in der Standardfassung von Ollama 43 GB groß, fast doppelt so viel wie die Karte fassen kann5. Reicht der Grafikspeicher nicht, verteilt Ollama das Modell auf Grafikkarte und Prozessor7. Der Testrechner hat 128 GB Arbeitsspeicher, das Modell ließ sich also laden. Ollama legte 20,9 GiB auf die Karte und meldete für den Rest 48,1 Prozent Anteil auf dem Prozessor1. Im Median entstanden 1,76 Token je Sekunde, die drei Läufe lagen zwischen 1,75 und 1,811. Eine Antwort mit 256 Token dauerte damit gut zwei Minuten, genauer 143 bis 147 Sekunden je Lauf1. Das erste Token kam nach 0,92 Sekunden, den kurzen Prompt las das System mit rund 90 Token je Sekunde1.
Die Grafikkarte kam dabei im Mittel auf eine Auslastung von nur 11 bis 14 Prozent, bei 56 Watt im Median1. Die meiste Zeit wartete sie auf den Teil des Modells, den der Prozessor aus dem Arbeitsspeicher rechnet.
Der Engpass verschiebt sich vom Grafikspeicher zum Arbeitsspeicher, der deutlich langsamer angebunden ist. Gegenüber Qwen3 32B auf der Karte ist das 70B-Modell bei gut doppelter Größe mehr als zwanzigmal langsamer1. Ein 70B-Modell auf einer einzelnen 24-GB-Karte ist damit eher etwas zum Ausprobieren als für den täglichen Chat. Wer solche Modelle flüssig nutzen will, braucht mehr Grafikspeicher, etwa eine zweite große Karte oder eine Profikarte mit doppelt so viel Speicher; die Seite zur Wahl der Grafikkarte ordnet die Möglichkeiten ein.
Unser Testrechner hat zwar zwei Grafikkarten, für diese Reihe sah Ollama aber nur die RTX 4090. Ohne diese Einschränkung würde Ollama ein Modell, das nicht auf eine Karte passt, auf alle verfügbaren Karten verteilen7. Zusammen kämen RTX 4090 und RTX 5060 Ti auf 40 GB, für die 43 GB von Llama 3.3 70B samt Kontext reicht auch das nicht ganz5911. Eine Messung mit beiden Karten gehört deshalb nicht in diese Reihe, die eine einzelne 24-GB-Karte beschreibt.
Wie schnell die erste Antwort kommt
Bei kurzen Prompts kommt die Antwort sofort. Das erste Token erschien im Median nach 0,04 Sekunden beim 8B-Modell, nach 0,05 Sekunden beim 14B-Modell und nach 0,08 Sekunden beim 32B-Modell1. Den Prompt selbst las die Karte mit rund 5.000 Token je Sekunde beim 8B-Modell, 3.262 beim 14B-Modell und 1.671 beim 32B-Modell1.
Spürbar wird diese Zeit erst bei langen Eingaben. Ein Dokument mit 20.000 Token bräuchte beim 32B-Modell nach dieser Rate etwa zwölf Sekunden, bevor das erste Wort der Antwort erscheint (Rechenbeispiel aus der Prompt-Rate, ohne den Mehraufwand eines größeren Kontexts)1. Die echten Werte bei langen Kontexten misst der Praxistest zur Kontextlänge.
Strom und Wärme während der Messung
Die Karte zog laut nvidia-smi während der Läufe im Median 310 Watt beim 8B-Modell, 324 Watt beim 14B-Modell und 339 Watt beim 32B-Modell1. Beim teilweise ausgelagerten 70B-Modell waren es nur 56 Watt, dafür arbeitete der Prozessor1. Im Leerlauf vor den Läufen waren es 15 bis 17 Watt1. NVIDIA gibt für die Karte eine Leistungsaufnahme von 450 Watt an9. Die Kerntemperatur blieb bei Läufen von jeweils mindestens acht Sekunden unter 54 Grad1. Was das in Euro bedeutet, rechnet der Stromverbrauch-Test für die Karte allein vor; den übrigen Rechner haben wir nicht gemessen.
Messaufbau und Protokoll
Im Testrechner arbeiten ein AMD Ryzen 9 7950X3D und 128 GB Arbeitsspeicher, neben der RTX 4090 steckt als zweite Karte die RTX 5060 Ti1. Die Grafiktreiber haben die Version 621.35, CUDA 13.5 laut Treiber1. Ein eigener Ollama-Server sah über CUDA_VISIBLE_DEVICES nur die RTX 4090, damit kein Modell auf die zweite Karte ausweicht1.
Jede Messung begann mit einer Prüfung: Fünf Sekunden lang durfte die Last der Karte zehn Prozent nicht überschreiten, sonst wartete das Skript1. Alle vier Messungen starteten mit einer freien Karte. Auf einen ungezählten Lauf zum Laden des Modells folgten drei gezählte Läufe. Jeder Lauf wiederholte die Anfrage, bis mindestens acht Sekunden erreicht waren, so dass für Strom und Speicher genug Sekundenwerte von nvidia-smi zusammenkamen1. Beim 70B-Modell galt diese Mindestdauer nicht, weil ein einzelner Lauf ohnehin lange dauert. In die Tabelle kommt der Median der drei Läufe.
Die Einstellungen waren für alle Modelle gleich: Temperatur 0, fester Startwert, 256 Token Ausgabe, Kontext 8.192 Token1. Den Kontext haben wir ausdrücklich gesetzt, weil Ollama sonst nach der Größe des Grafikspeichers einen eigenen Standard wählt, bei 24 GiB sind das 32k Token8. Den Denkmodus von Qwen3, der laut Modellkarte standardmäßig aktiv ist, haben wir abgeschaltet, damit nur Antworttext gezählt wird12. Die Token je Sekunde stammen aus den Zählern von Ollama selbst: Anzahl der erzeugten Token geteilt durch die Zeit für ihre Erzeugung10.
Warum Q4_K_M? In der Ollama-Bibliothek ist diese Stufe der Standard für die getesteten Modelle, und sie gilt als verbreiteter Kompromiss aus Größe und Qualität6. Laut den Entwicklern von llama.cpp speichert sie 4,89 Bit je Gewicht, also knapp ein Drittel dessen, was die Gewichte in 16 Bit bräuchten12. Gespeichert sind die Modelle im Format GGUF, das Ollama und llama.cpp gemeinsam nutzen.
Welche Modelle sich auf der RTX 4090 lohnen
Für den Alltag liegt auf dieser Karte ein Modell mit 14 Milliarden Parametern nahe, weil es in unserer Messung schnell lief und wenig Speicher belegte1. Es ist schnell, belegt weniger als die Hälfte des Speichers und lässt Platz für längere Dokumente oder ein zweites Programm.
Das 8B-Modell spielt seine Stärke dort aus, wo viele kurze Anfragen hintereinander kommen: Texte sortieren, Stichworte herausziehen, kurze Mails umformulieren oder als Helfer in einem Editor, der bei jedem Tastendruck fragt. Mit fast 146 Token je Sekunde und weniger als 6 GiB Speicher bleibt die Karte dabei für anderes frei1. Bei Fragen mit mehreren Denkschritten hat es von den drei Qwen-Modellen die wenigsten Parameter zur Verfügung, dort lohnt der Vergleich mit dem 14B-Modell an eigenen Beispielen. Das 32B-Modell ist die Obergrenze für den reinen Betrieb auf der Karte und lohnt sich, wenn dir die Qualität der Antworten wichtiger ist als Reserve beim Speicher. Welche Modellfamilie sich für Deutsch eignet, vergleicht die Seite zu lokalen Sprachmodellen.
Beim Denkmodus lohnt ein zweiter Blick. Qwen3 schreibt standardmäßig zuerst einen Denkabschnitt und dann die Antwort2. Das Tempo je Token bleibt dabei gleich, aber vor der eigentlichen Antwort entstehen zusätzliche Token, die du gar nicht als Antwort liest. Mit dem 32B-Modell und knapp 40 Token je Sekunde kosten 1.000 Denk-Token rund 25 Sekunden Wartezeit, bevor der erste Satz der Antwort erscheint (Rechenbeispiel)1. Für schnelle Fragen schaltest du das Denken ab, für Rechenaufgaben und knifflige Logik lässt du es an.
Die Kontextlänge setzt du in Ollama auf drei Wegen: global mit der Umgebungsvariablen OLLAMA_CONTEXT_LENGTH, im Chat mit /set parameter num_ctx oder je Anfrage über die Option num_ctx der Schnittstelle7. Wer auf der RTX 4090 mit dem 32B-Modell arbeitet, fährt mit einem bewusst gesetzten Wert besser als mit dem Standard, weil dann klar ist, wie viel Speicher übrig bleibt.
Die Messung zeigt Tempo und Speicher. Wie sich die Antwortqualität lokaler und Cloud-Modelle nach veröffentlichten Auswertungen unterscheidet, fasst der Ratgeber lokal oder Cloud zusammen.
Was die Messung nicht abdeckt
Gemessen wurde mit einem kurzen Prompt und kurzen Antworten. Bei sehr langen Antworten wächst der Kontext während der Erzeugung, und die Rate kann sinken. Alle Modelle liefen in derselben Stufe Q4_K_M. Mit acht Bit ist schon die Datei deutlich größer, beim 14B-Modell 16 GB statt 9,3 GB6; was das für Tempo und Antworten bedeutet, misst der Praxistest zur Quantisierung. Andere Programme wie LM Studio oder llama.cpp können bei gleichem Modell etwas abweichen.
Was das für dich heißt
Auf einer RTX 4090 bestimmt der Grafikspeicher, welches Modell sinnvoll ist, das Tempo reicht bis 32B für flüssiges Arbeiten.
- Starte mit einem 14B-Modell in Q4_K_M, wenn du Reserve für lange Dokumente brauchst.
- Prüfe nach jedem Modellwechsel mit ollama ps, ob dort 100% GPU steht.
- Setze die Kontextlänge bewusst, statt den Standard von Ollama zu übernehmen.
- Schließe speicherhungrige Programme, bevor du ein 32B-Modell lädst.
Häufige Fragen
Welche Modelle laufen auf der RTX 4090 komplett im Grafikspeicher?
In unserer Messung mit Kontext 8.192 und Stufe Q4_K_M lagen Qwen3 8B, 14B und 32B vollständig auf der Karte. Mit dem 32B-Modell waren 22,5 von 24,0 GiB belegt, für deutlich mehr Kontext bleibt dann kaum Platz.
Wie schnell ist Ollama auf der RTX 4090?
Qwen3 8B schaffte 145,9 Token je Sekunde, Qwen3 14B 85,7 und Qwen3 32B 39,7, jeweils im Median aus drei Läufen. Das erste Token kam bei kurzen Prompts nach weniger als einer Zehntelsekunde.
Läuft ein 70B-Modell auf einer RTX 4090?
Es lässt sich mit genug Arbeitsspeicher laden, aber nur gut die Hälfte passt auf die Karte. In unserer Messung kamen 1,8 Token je Sekunde heraus, eine kurze Antwort dauerte gut zwei Minuten.
Warum ist der Kontext auf 8.192 Token gesetzt?
Damit der Speicherbedarf über alle Modelle und beide Karten vergleichbar bleibt. Ollama würde auf der RTX 4090 sonst einen größeren Standard wählen, der zusätzlichen Speicher belegt.
Quellen
Stand:
- Eigene Messung: Messreihe Ollama 0.40.0 auf RTX 4090 (Treiber 621.35, CUDA 13.5), Testrechner Ryzen 9 7950X3D, 128 GB; qwen3:8b, qwen3:14b, qwen3:32b, llama3.3:70b in Q4_K_M, Kontext 8192, Temperatur 0, 256 Ausgabe-Token, Aufwärmlauf und drei Läufe, Median, Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- Qwen (Alibaba): Modellkarte Qwen3-8B, abgerufen am 22.11.2026. zurück
- Qwen (Alibaba): Modellkarte Qwen3-14B, abgerufen am 22.11.2026. zurück
- Qwen (Alibaba): Modellkarte Qwen3-32B, abgerufen am 22.11.2026. zurück
- Ollama: Bibliothek: llama3.3, abgerufen am 22.11.2026. zurück
- Ollama: Bibliothek: qwen3, Tags und Größen, abgerufen am 22.11.2026. zurück
- Ollama: Häufige Fragen (FAQ), abgerufen am 22.11.2026. zurück
- Ollama: Kontextlänge (Dokumentation), abgerufen am 22.11.2026. zurück
- NVIDIA: GeForce RTX 4090: technische Daten, abgerufen am 22.11.2026. zurück
- Ollama: API: Antwort erzeugen (generate), abgerufen am 22.11.2026. zurück
- NVIDIA: GeForce RTX 5060 Familie: technische Daten, abgerufen am 22.11.2026. zurück
- ggml-org: llama.cpp: Quantisierung (README zu llama-quantize), abgerufen am 22.11.2026. zurück