Lokale KI
LM Studio
Kurzantwort
LM Studio ist eine Desktop-App, mit der du Sprachmodelle von Hugging Face suchst, lädst und im eigenen Chatfenster nutzt2. Nach der Installation lädst du im Reiter Discover ein Modell, stellst beim Laden Kontextlänge und GPU-Auslagerung ein und chattest offline. Über den Reiter Developer startest du einen Server, den andere Programme wie die OpenAI-Schnittstelle ansprechen68.

Wer lokale Sprachmodelle ausprobieren will, ohne ein Terminal zu öffnen, ist mit LM Studio gut bedient. Die App des Herstellers Element Labs verbindet Modellsuche, Download, Chat und einen lokalen Server in einem Fenster; sobald die Modelldateien auf der Platte liegen, läuft sie ohne Internet213. Seit dem 08.07.2025 ist LM Studio auch für die Arbeit im Unternehmen kostenlos, ein Antrag auf eine Firmenlizenz entfällt12. Wir haben die Version 0.4.28-2 auf unserem Testrechner mit RTX 4090 installiert und mit Llama 3.2 3B betrieben16.
Passt dein Rechner?
Unter Windows braucht LM Studio einen x64-Prozessor mit dem Befehlssatz AVX2 oder einen ARM-Chip vom Typ Snapdragon X Elite. Empfohlen sind 16 GB Arbeitsspeicher und mindestens 4 GB eigener Grafikspeicher1. Auf dem Mac läuft die App nur mit Apple-Chips der Reihen M1 bis M4 und ab macOS 14; Intel-Macs werden nicht unterstützt1. Für Linux gibt es ein AppImage, vorausgesetzt ist Ubuntu 20.04 oder neuer1.
Wie große Modelle flüssig laufen, hängt vor allem am Grafikspeicher: Was ganz hineinpasst, rechnet schnell, was in den Arbeitsspeicher ausweicht, wird langsamer.
LM Studio herunterladen und installieren
- Öffne die Downloadseite auf lmstudio.ai. Am 22.11.2026 bot sie für Windows die Version 0.4.28 an14.
- Prüfe vor dem Start, ob das Installationsprogramm signiert ist (Rechtsklick, Eigenschaften, Digitale Signaturen). Unsere Datei trug eine gültige Signatur von Element Labs Inc.16
- Installiere die App und starte sie einmal. Beim ersten Start legt LM Studio im Benutzerordner das Verzeichnis .lmstudio an; bei uns lagen dort nach der Einrichtung rund 2,6 GB an Laufzeitumgebungen und einem mitgelieferten Einbettungsmodell16.
- Stell die Sprache um, wenn du die Oberfläche lieber auf Deutsch hättest: Strg und Komma öffnen die Einstellungen, unter Preferences und Language wählst du Deutsch10.
Die Einstellungen erreichst du erst ab dem Modus Power User10. Die deutsche Übersetzung stammt aus der Community; LM Studio nennt unter anderem Englisch, Chinesisch, Spanisch, Französisch, Deutsch, Koreanisch und Russisch und dazu mehr als 26 weitere Sprachen10.
Den Ordner für Modelle änderst du im Reiter My Models3. Bei uns setzte LM Studio einen geänderten Download-Ordner beim nächsten Start wieder zurück. Wir haben den Unterordner models deshalb mit einer Verzeichnisverknüpfung auf das zweite Laufwerk umgeleitet16. Wenn dein Systemlaufwerk klein ist, richte das vor dem ersten großen Download ein.
Modelle suchen und auswählen
Der Reiter Discover ist die eingebaute Modellsuche; Strg und 2 öffnen ihn von jeder Stelle der App3. Du suchst nach dem Namen einer Modellfamilie wie "qwen" oder "gemma", gibst einen Namen im Muster nutzer/modell ein oder fügst die vollständige Adresse einer Modellseite auf Hugging Face ein3. Die Treffer kommen direkt von dort.
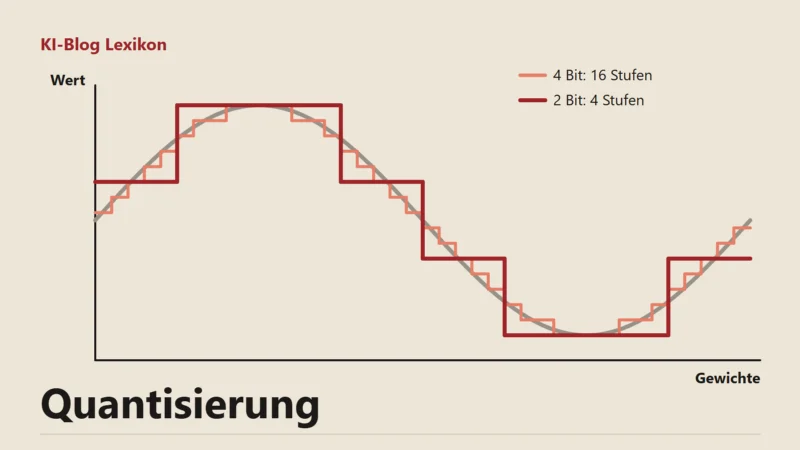
Zu fast jedem Modell gibt es mehrere Dateien mit Kürzeln wie Q3_K_S, Q4_K_M oder Q8_0. Das sind Fassungen desselben Modells mit unterschiedlich starker Quantisierung: je kleiner die Zahl, desto kleiner die Datei und desto größer der Qualitätsverlust. LM Studio rät zu vier Bit oder mehr, wenn der Rechner es schafft3. Unter Windows und Linux lädt die App Dateien im Format GGUF und rechnet sie mit llama.cpp, auf Macs mit Apple-Chip zusätzlich Modelle im Format MLX2.
Bei unserer Installation löste der Befehl lms get das gewünschte Modell ohne Anmeldung nicht auf. Wir haben die GGUF-Datei von Llama 3.2 3B Instruct in Q4_K_M deshalb direkt aus dem Bereich lmstudio-community auf Hugging Face geladen; lms ls zeigte sie danach mit 2,02 GB an16. Für Antworten auf Deutsch eignet sich das Modell, denn Meta führt Deutsch unter den acht offiziell unterstützten Sprachen17.
Laden mit Kontext und GPU-Auslagerung
Gechattet wird im Reiter Chat. Über die Modellauswahl oben wählst du ein heruntergeladenes Modell und kannst vor dem Laden die Ladeparameter anpassen18. Am meisten bewirken dabei Kontextlänge und GPU-Auslagerung.
Die Kontextlänge legt fest, wie viele Token das Modell gleichzeitig im Blick behält, also Frage, bisherigen Verlauf und angehängte Texte zusammen5. Mehr Kontext belegt mehr Speicher. Unser Llama 3.2 3B lief mit 8192 Token, das zeigte lms ps in der Spalte CONTEXT16. Für lange Dokumente lohnt ein größeres Kontextfenster, solange alles in den Grafikspeicher passt.
Die GPU-Auslagerung bestimmt, welcher Anteil des Modells auf der Grafikkarte rechnet. Auf der Befehlszeile entspricht das der Option --gpu mit einem Wert zwischen 0 und 1, mit max für alles oder off für reinen Prozessorbetrieb5. Passt das ganze Modell samt Kontext in den VRAM, stellst du die Auslagerung auf das Maximum. Reicht der Speicher nicht, verschiebt ein kleinerer Wert einen Teil der Schichten in den Arbeitsspeicher; das Modell läuft dann, aber langsamer. Wie viel Speicher ein Modell mit bestimmten Einstellungen brauchen wird, schätzt lms load --estimate-only, ohne es zu laden5.
Mit zwei Grafikkarten schaltest du in den Einstellungen jede Karte einzeln an oder aus und legst bei NVIDIA eine Reihenfolge fest. Die Option "Limit Model Offload to Dedicated GPU Memory" hält die Modellgewichte im eigenen Speicher der Karte und schiebt den Rest in den Arbeitsspeicher, statt den langsamen gemeinsamen Grafikspeicher von Windows zu nutzen15. Gefundene Werte speicherst du als Standard für das Modell: Im Reiter My Models öffnet das Zahnrad die Voreinstellungen für GPU-Auslagerung, Kontextgröße und Flash Attention4.
Bei voller Auslagerung auf unsere RTX 4090 erzeugte Llama 3.2 3B in einer Probemessung im Mittel 282,4 Token je Sekunde, das erste Token kam nach 0,01 Sekunden16. Der Grafikspeicher wuchs dabei um rund 3,4 GB16.
Mit Dokumenten chatten
An eine Chatnachricht hängst du Dateien im Format .docx, .pdf oder .txt an11. Kurze Dokumente fügt LM Studio vollständig in das Gespräch ein. Ist ein Dokument zu lang für den Kontext, sucht die App mit RAG die passenden Abschnitte heraus und gibt nur diese an das Modell weiter11. Für einzelne Unterlagen ist das der kürzeste Weg. Für eine ganze Dokumentensammlung, die mehrere Leute nutzen, ist eine Weboberfläche wie Open WebUI oder ein eigenes RAG-System die bessere Wahl.
LM Studio als lokaler Server
Im Reiter Developer startet ein Schalter den Server, auf der Befehlszeile tut es lms server start6. Andere Programme sprechen ihn wie die Schnittstelle von OpenAI an, mit der Basisadresse http://localhost:1234/v18. Unterstützt werden unter anderem die Endpunkte /v1/models, /v1/chat/completions, /v1/completions, /v1/embeddings und /v1/responses8. Im Feld model steht der Name, den LM Studio dem Modell gibt8. Unser Server auf Port 1234 meldete unter /v1/models das Sprachmodell llama-3.2-3b-instruct und das mitgelieferte Einbettungsmodell text-embedding-nomic-embed-text-v1.516. Daneben gibt es Endpunkte im Format von Anthropic sowie eine eigene REST-Schnittstelle6.
In den Servereinstellungen legst du fest, wer zugreifen darf7:
- Serve on Local Network macht den Server für andere Geräte im Netz erreichbar.
- Require Authentication verlangt von jedem Programm einen gültigen API-Schlüssel im Header Authorization.
- Just in Time Model Loading lädt ein Modell erst bei der ersten Anfrage; zusätzliche Schalter entladen unbenutzte Modelle wieder.
- Enable CORS erlaubt Anfragen von Webseiten anderer Herkunft.
Das Werkzeug lms kommt mit der App, du musst sie nur einmal gestartet haben9. Damit verwaltest du alles aus Skripten heraus: lms ls listet die Modelle auf der Platte, lms ps die geladenen, lms load und lms unload --all laden und entladen, lms server stop beendet den Server9. Für Rechner ohne Bildschirm gibt es eine Fassung ohne Oberfläche, die der Hersteller llmster nennt2.
Zwei Optionen von lms load sind für den Serverbetrieb praktisch. Mit --identifier gibst du dem geladenen Modell einen festen Namen, unter dem deine Programme es ansprechen, auch wenn du später eine andere Datei lädst. Mit --ttl und einer Zahl in Sekunden entlädt LM Studio das Modell, sobald es so lange unbenutzt war; der Wert 3600 entspricht einer Stunde5. So bleibt der Grafikspeicher nicht dauerhaft belegt, wenn du die Karte zwischendurch für Bildmodelle oder Spiele brauchst. Ob der Server antwortet, prüfst du am schnellsten mit einer Anfrage an /v1/chat/completions per curl, wie sie die Dokumentation zeigt8.
Grenzen der App
LM Studio ist auf einen Rechner und eine Person ausgelegt: Die Dokumentation, die wir gelesen haben, beschreibt keine Benutzerverwaltung und keine Weboberfläche für ein Team, Single Sign-on bietet der Enterprise-Tarif12. Für ein Team setzt du eine Oberfläche wie Open WebUI auf den Server. Die Nutzungsbedingungen in der Fassung vom 23.08.2026 erlauben den Einsatz für private Zwecke und interne Geschäftszwecke; Weiterverteilung und den Betrieb als Dienst für Dritte schränken sie ein13. Wer so etwas plant, liest die Bedingungen vorher vollständig.
Unter der Haube rechnet LM Studio mit llama.cpp, bei uns in der Laufzeitumgebung llama.cpp CUDA 2.67.0216. Wer jeden Startparameter selbst setzen will, startet llama.cpp direkt (llama.cpp, GGUF und vLLM). Gegen das Befehlszeilenprogramm Ollama, gemessen mit demselben Modell, tritt die App im Vergleich Ollama oder LM Studio an.
Was das für dich heißt
Für den Einstieg ohne Terminal reicht LM Studio mit einem Modell in vier Bit, das ganz in deinen Grafikspeicher passt.
- Prüf die Signatur des Installers, bevor du ihn startest.
- Leg den Modellordner vor dem ersten Download auf ein großes Laufwerk.
- Stell die GPU-Auslagerung auf das Maximum und senk nur, wenn das Laden scheitert.
- Schalte Require Authentication ein, bevor du den Server im Netz freigibst.
Häufige Fragen
Darf ich LM Studio in der Firma kostenlos nutzen?
Läuft LM Studio auf einem älteren Mac mit Intel-Prozessor?
Nein, unterstützt werden nur Macs mit Apple-Chip ab M1 und macOS 141. Auf einem Intel-Mac ist Ollama eine Möglichkeit, das dort allerdings nur auf dem Prozessor rechnet.
Wo legt LM Studio die Modelle ab?
Brauche ich für LM Studio eine Internetverbindung?
Nur für die Modellsuche und den Download. Danach läuft die App laut Hersteller vollständig offline, auch der Chat mit angehängten Dokumenten2.
Quellen
Stand:
- LM Studio (Element Labs): Systemanforderungen, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): Dokumentation der App: Überblick, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): Modelle herunterladen, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): Standardeinstellungen je Modell, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): lms load: Modelle laden und Speicher schätzen, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): Lokalen Server starten, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): Servereinstellungen, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): OpenAI-kompatible Endpunkte, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): Befehlszeile lms, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): Sprachen der Oberfläche, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): Mit Dokumenten chatten, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): Blogbeitrag: kostenlos auch für die Arbeit, Stand 08.07.2025, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): Nutzungsbedingungen der App, Stand 23.08.2026, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): Downloadseite, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): Versionshinweise 0.3.14: Steuerung mehrerer Grafikkarten, abgerufen am 22.11.2026. zurück
- Eigene Messung: Eigene Installation LM Studio 0.4.28-2 (Laufzeit llama.cpp CUDA 2.67.0) auf RTX 4090, Ausgaben von lms ls, lms ps und /v1/models, Probemessung Llama 3.2 3B Q4_K_M mit drei Läufen, Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- Meta auf Hugging Face: Llama 3.2 3B Instruct, Modellkarte, Stand 25.09.2024, abgerufen am 22.11.2026. zurück
- LM Studio (Element Labs): Erste Schritte, abgerufen am 22.11.2026. zurück