Lokale KI · Praxistest
Lange Dokumente lokal verarbeiten
Kurzantwort
In Ollama legt num_ctx oder die Variable OLLAMA_CONTEXT_LENGTH fest, wie viele Token ein Modell auf einmal verarbeitet3. Auf der RTX 4090 wuchs der Speicher von Qwen3 8B von 4,9 GiB bei 4.096 Token auf 7,2 GiB bei 32.768 Token, das Tempo sank von 139 auf 105 Token je Sekunde1. Mehr als 40.960 Token ließ Ollama bei Qwen3 nicht zu und kürzte längere Eingaben ohne Fehlermeldung18.

Die Kontextlänge in Ollama stellst du mit num_ctx ein, global über die Umgebungsvariable OLLAMA_CONTEXT_LENGTH oder je Anfrage über die Schnittstelle3. Jedes Token mehr kostet Grafikspeicher und Tempo. In unserer Messreihe auf der RTX 4090 belegte Qwen3 8B bei 4.096 Token Kontext 4,9 GiB, bei 32.768 Token 7,2 GiB, und das Tempo sank von 139,3 auf 105,0 Token je Sekunde1. Bei noch längeren Eingaben zeigte sich eine Grenze: Ollama begrenzte den Kontext von Qwen3 auf 40.960 Token und kürzte längere Prompts auf nur 20.482 Token1.
Kontextlänge in Ollama auf der RTX 4090
- Hardware
- RTX 4090 (24 GB), Treiber 621.35; AMD Ryzen 9 7950X3D, 128 GB
- Modell
- Qwen3 8B und Qwen3 14B, jeweils Q4_K_M
- Werkzeug
- Ollama 0.40.0
- Messgröße
- Modellgröße im Grafikspeicher, Ausgabe-Token je Sekunde, Zeit bis zum ersten Token; Prompt auf etwa 80 Prozent des Kontexts gefüllt; Median aus drei Läufen
- Gemessen am
| Qwen3 8B, 4.096 Token: Speicher | 4,9 GiB |
|---|---|
| Qwen3 8B, 16.384 Token: Speicher | 5,9 GiB |
| Qwen3 8B, 32.768 Token: Speicher | 7,2 GiB |
| Qwen3 8B, 40.960 Token (Grenze): Speicher | 8,1 GiB |
| Qwen3 8B, 4.096 / 16.384 / 32.768 Token: Token je Sekunde | 139,3 / 122,0 / 105,0 |
| Qwen3 8B, 4.096 / 16.384 / 32.768 Token: erstes Token | 0,38 s / 1,51 s / 3,49 s |
| Qwen3 14B, 4.096 Token: Speicher | 8,7 GiB |
| Qwen3 14B, 16.384 Token: Speicher | 9,8 GiB |
| Qwen3 14B, 32.768 Token: Speicher | 11,2 GiB |
| Qwen3 14B, 40.960 Token (Grenze): Speicher | 11,9 GiB |
| Qwen3 14B, 4.096 / 16.384 / 32.768 Token: Token je Sekunde | 81,5 / 72,3 / 64,0 |
| Qwen3 14B, 4.096 / 16.384 / 32.768 Token: erstes Token | 0,63 s / 2,71 s / 6,43 s |
Ollama begrenzte den Kontext von Qwen3 auf 40.960 Token; die Stufen 65.536 und 131.072 liefen deshalb mit 40.960 Token Kontext und 20.482 Token Inhalt
Was der Kontext im Speicher belegt
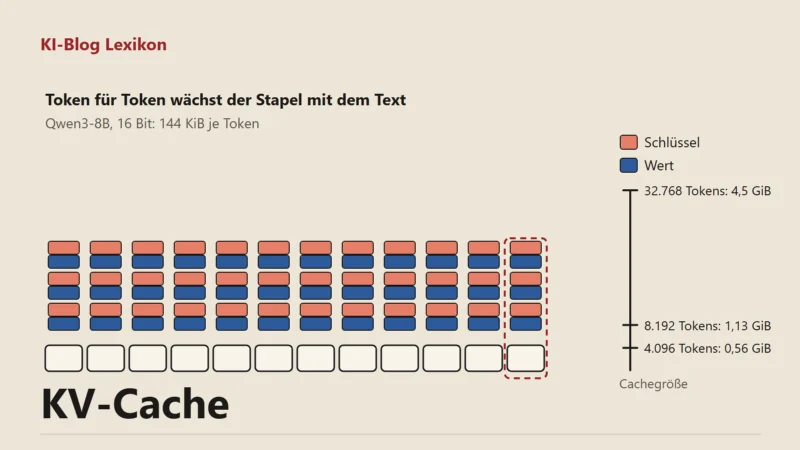
Ein Sprachmodell merkt sich jedes Token im Kontext im sogenannten KV-Cache: Für jede Schicht des Modells speichert es zwei Vektoren je Token. Wie groß dieser Speicher wird, lässt sich aus der Konfiguration des Modells ausrechnen. Qwen3 8B hat 36 Schichten mit je 8 Köpfen für Schlüssel und Werte zu je 128 Zahlen, Qwen3 14B hat 40 solche Schichten67. In 16 Bit ergibt das 144 KiB je Token für das 8B-Modell und 160 KiB für das 14B-Modell (Rechnung der Redaktion aus der Konfiguration)67. Bei 32.768 Token wären das 4,5 und 5,0 GiB zusätzlich zu den Gewichten.
Unsere Messung lag darunter. Beim 8B-Modell stieg die Größe, die Ollama für das geladene Modell meldete, von 4,9 GiB bei 4.096 Token über 5,9 GiB bei 16.384 Token auf 7,2 GiB bei 32.768 Token1. Das sind rund 82 KiB je zusätzlichem Token, also gut die Hälfte des Werts aus der Formel (errechnet aus den Messwerten)1. Beim 14B-Modell wuchs die Größe von 8,7 GiB bei 4.096 Token über 9,8 GiB auf 11,2 GiB bei 32.768 Token, rund 92 KiB je Token und damit im selben Verhältnis zur Formel1. Die Dokumentation von Ollama nennt f16 als Standard für den Zwischenspeicher und gibt an, dass die Stufe q8_0 etwa die Hälfte braucht3. Welche Einstellung Ollama 0.40.0 auf unserer Karte tatsächlich gewählt hat, zeigen die Messdaten nicht; wir geben deshalb die gemessenen Werte an und die Formel als Obergrenze.
Für die Praxis ist die Richtung wichtiger als die genaue Zahl: Der Speicher für den Kontext wächst gleichmäßig mit jedem Token und kommt zu den Gewichten hinzu. Bei kleinen Modellen und langen Dokumenten kann er größer werden als das Modell selbst.

- Durchgezogen gemessen
- Gestrichelt Rechenwert für den Zwischenspeicher in 16 Bit
- Markierung größter Kontext, den Ollama für Qwen3 zulässt
Wie das Tempo mit dem Kontext sinkt
Zwei Zeiten zählen bei langen Dokumenten. Die erste ist das Einlesen: Bevor das Modell antwortet, muss es den ganzen Prompt verarbeiten. Bei Qwen3 8B dauerte das mit 3.371 Token 0,38 Sekunden, mit 12.827 Token 1,51 Sekunden und mit 25.372 Token 3,49 Sekunden1. Die Lesegeschwindigkeit fiel dabei von rund 11.500 auf 8.460 Token je Sekunde, weil jedes neue Token auf mehr vorherige Token achten muss1.
Die zweite ist das Schreiben der Antwort. Auch hier wird es langsamer, aber weniger stark: 139,3 Token je Sekunde bei 4.096 Token Kontext, 122,0 bei 16.384 und 105,0 bei 32.7681. Zum Vergleich: Mit kurzem Prompt und 8.192 Token Kontext schaffte dasselbe Modell in der Reihe auf der RTX 4090 145,9 Token je Sekunde1. Ein voller Kontext von gut 25.000 Token kostet also rund ein Viertel des Tempos.
Beim 14B-Modell sieht es ähnlich aus, auf niedrigerem Niveau. Es schrieb mit 4.096 Token Kontext 81,5 Token je Sekunde, mit 16.384 Token 72,3 und mit 32.768 Token 64,01. Das Einlesen dauerte 0,63, 2,71 und 6,43 Sekunden, die Lesegeschwindigkeit fiel von rund 6.100 auf 4.200 Token je Sekunde1.
Für ein Dokument von 25.000 Token, etwa einen längeren Bericht, heißt das auf dieser Karte: dreieinhalb Sekunden Wartezeit mit dem 8B-Modell, gut sechs mit dem 14B-Modell, dann eine flüssige Antwort1. Wer immer wieder Fragen zum selben Dokument stellt, profitiert zusätzlich vom Zwischenspeicher für Prompts: Ollama liest bereits verarbeitete Token aus dem Cache, die Schnittstelle meldet sie getrennt4.
Die Grenze bei 40.960 Token
Laut Modellkarte verarbeitet Qwen3 nativ 32.768 Token und mit dem Verfahren YaRN bis zu 131.072 Token5. In der Konfiguration steht als größte Position 40.960, und die Ollama-Bibliothek nennt für alle Qwen3-Fassungen einen Kontext von 40K68. Unsere Messreihe sollte bis 131.072 Token gehen. Bei den Läufen mit 65.536 und 131.072 Token meldete Ollama nach dem Laden aber einen Kontext von 40.960 Token, und vom Prompt mit rund 52.000 beziehungsweise 104.000 Token kamen jeweils nur 20.482 Token beim Modell an1.
Ollama hat den Prompt also gekürzt, ohne einen Fehler zu melden. Weil die Verarbeitung danach in allen drei Läufen fast keine Zeit mehr brauchte, war der verbliebene Teil jedes Mal gleich, und die Kennung am Anfang des Prompts, die jeden Lauf eindeutig macht, fehlte. Wir schließen daraus, dass Ollama den Anfang des Dokuments verworfen und das Ende behalten hat1. Wer ein langes Dokument einspielt und eine Frage zum ersten Kapitel stellt, bekommt dann eine Antwort ohne das erste Kapitel. Auffällig ist auch die Zahl: 20.482 Token sind ziemlich genau die Hälfte der 40.960 Token Kontext1. Ollama hat den Prompt also deutlich unter die Grenze gekürzt; in der Dokumentation haben wir dazu keine Angabe gefunden.
Für die Messwerte heißt das: Die Läufe mit 65.536 und 131.072 Token messen in Wirklichkeit 40.960 Token Kontext mit 20.482 Token Inhalt. Wir zeigen für diese beiden Stufen nur den Speicher, 8,1 GiB beim 8B-Modell und 11,9 GiB beim 14B-Modell; das Tempo von 110 und 66 Token je Sekunde gilt für die gekürzte Eingabe1. Die Zeit bis zum ersten Token war wegen des Zwischenspeichers für Prompts nicht aussagekräftig und fehlt deshalb.
YaRN für mehr als 40.960 Token müsste man ausdrücklich einschalten. Die Modellkarte rät, das nur für lange Texte zu tun, weil die statische Skalierung die Leistung bei kürzeren Texten beeinträchtigen kann5. Ollama bietet dafür in der Bibliothek keine eigene Fassung an8. Wir haben diesen Weg nicht gemessen.
So prüfst du die Kontextlänge in Ollama
Nach dem Laden zeigt ollama ps in der Spalte CONTEXT, welche Länge Ollama dem Modell tatsächlich zugewiesen hat, und in der Spalte PROCESSOR, ob das Modell ganz auf der Grafikkarte liegt2. Steht dort eine kleinere Zahl als die eingestellte, hat Ollama begrenzt. Einen Hinweis im Chat gibt es nicht.
Ohne eigene Einstellung wählt Ollama die Länge nach dem Grafikspeicher: unter 24 GiB 4k Token, von 24 bis 48 GiB 32k und ab 48 GiB 256k2. Für Werkzeuge wie Websuche, Agenten und Programmierhilfen empfiehlt Ollama mindestens 64.000 Token2. Mit Qwen3 ist das aus den genannten Gründen nicht ohne weiteres zu erreichen, andere Modellfamilien haben höhere Grenzen. Modelle mit größerem Kontextfenster findest du im Vergleich lokaler Sprachmodelle.
Für Dokumente, die länger sind als das, was ein Modell sicher verarbeitet, gibt es einen anderen Weg: Du teilst sie in Abschnitte und gibst dem Modell nur die Teile, die zur Frage passen. Dieses Verfahren heißt RAG; wie du es mit einer eigenen Oberfläche nutzt, zeigt die Anleitung zu Open WebUI. Es braucht weniger Speicher und umgeht die Grenze, kann aber Zusammenhänge übersehen, die über mehrere Abschnitte verteilt sind.
Hilfreich ist außerdem der Zähler in der Antwort der Schnittstelle: Das Feld prompt_eval_count nennt die Zahl der Token, die tatsächlich verarbeitet wurden4. Ist sie viel kleiner als dein Dokument, wurde gekürzt.
Was auf 24 und 16 GB passt
Auf der RTX 4090 ist Qwen3 8B auch mit 40.960 Token Kontext unkritisch: Insgesamt kamen 8,5 GiB zum Desktop dazu1. Qwen3 14B belegte an der Grenze von 40.960 Token insgesamt 12,3 GiB zusätzlich, auch das lässt auf 24 GB viel Luft1. Eng wird es mit großen Modellen. Qwen3 32B belegte schon mit 8.192 Token Kontext 20,1 GiB auf der Karte, für einen langen Kontext bleiben dann nur wenige GiB1.
Auf der RTX 5060 Ti mit 16 GB haben wir die Kontextreihe nicht gemessen. Der Speicherbedarf folgt aus Modell und Kontextlänge. Mit den Werten oben lässt sich abschätzen, wie viel Kontext neben dem Modell Platz hat: Qwen3 14B mit 32.768 Token Kontext kam auf der großen Karte auf 11,2 GiB und würde damit auch in 16 GB passen, sofern Desktop und andere Programme nicht zu viel davon belegen (Abschätzung aus den Messwerten)1; die Messreihe auf der RTX 5060 Ti nennt den Speicher der Modelle bei 8.192 Token. Für die Rechnung mit eigenen Werten gibt es den VRAM-Rechner.
Aufbau der Kontextreihe
Die Reihe lief auf der RTX 4090 mit 24 GB neben 128 GB Arbeitsspeicher und einem Ryzen 9 7950X3D, Grafiktreiber 621.35, CUDA 13.5 laut Treiber, Ollama 0.40.0, mit Qwen3 8B und Qwen3 14B in Q4_K_M1. Je Stufe setzte das Messskript num_ctx auf 4.096, 16.384, 32.768, 65.536 oder 131.072 Token und füllte den Prompt mit einem deutschen Sachtext auf etwa 80 Prozent der Länge; am Ende stand eine Frage zum Text1. Eine zufällige Kennung am Anfang jedes Prompts sollte verhindern, dass Ollama Ergebnisse aus dem Zwischenspeicher wiederverwendet.
Jede Stufe lief mit einem Aufwärmlauf und drei gezählten Läufen, gewertet ist der Median1. Temperatur 0, fester Startwert, 256 Token Ausgabe, Denkmodus aus. Eine Stufe begann erst, wenn die Karte unter zehn Prozent Last lag; alle Läufe starteten mit freier Karte1. Den Speicher geben wir als Größe an, die Ollama nach dem Laden für das Modell meldet; die Spitze laut nvidia-smi abzüglich der Vorbelegung lag jeweils rund 0,4 GiB darüber1.
Beim Einlesen langer Prompts arbeitete die Karte an ihrer Grenze. Mit Qwen3 14B und 32.768 Token Kontext lag die mittlere Leistung bei 445 Watt, in einzelnen Sekunden bei 500 Watt, der Leistungsgrenze, die der Treiber meldet1. Dass die Karte dabei ans Limit geht, wirkt sich auf den Stromverbrauch aus; der Stromtest rechnet die Energie je Antwort für lange Eingaben aus.
Mit llama.cpp haben wir nicht gemessen.
Grenzen der Messung
Gemessen wurde eine Modellfamilie mit einer Grenze von 40.960 Token1. Bei Modellen mit größerem Kontextfenster wächst der Speicher nach demselben Prinzip, sie kommen aber weiter. Die Lesegeschwindigkeit hängt außerdem vom Inhalt ab; unser Fülltext ist fließender deutscher Text, Programmcode oder Tabellen ergeben andere Tokenzahlen für dieselbe Zeichenmenge. Und ob ein Modell bei 30.000 Token die Details vom Anfang noch richtig wiedergibt, misst diese Reihe nicht, sie misst Speicher und Zeit. Was das Kontextfenster grundsätzlich bedeutet, erklärt das Lexikon.
Was das für dich heißt
Lange Dokumente gehen lokal gut, solange du die Grenze des Modells kennst und prüfst, was ankommt.
- Setze num_ctx bewusst und kontrolliere mit ollama ps die tatsächlich zugewiesene Länge.
- Prüfe bei langen Dokumenten prompt_eval_count, ob alle Token verarbeitet wurden.
- Teile Dokumente, die länger sind als die Grenze des Modells, in Abschnitte.
- Plane neben dem Modell Speicher für den Kontext ein, besonders bei Karten mit 16 GB.
Häufige Fragen
Wie stelle ich die Kontextlänge in Ollama ein?
Global mit der Umgebungsvariablen OLLAMA_CONTEXT_LENGTH, im Chat mit /set parameter num_ctx und über die Schnittstelle mit der Option num_ctx. In der App gibt es dafür einen Regler.
Wie viel Grafikspeicher kostet ein langer Kontext?
Bei Qwen3 8B stieg der Speicher in unserer Messung um rund 82 KiB je Token, von 4,9 GiB bei 4.096 Token auf 7,2 GiB bei 32.768 Token. Größere Modelle brauchen je Token mehr.
Warum ignoriert Ollama meine Kontextlänge?
Ollama begrenzt den Kontext auf das, was das Modell laut seiner Konfiguration unterstützt, bei Qwen3 auf 40.960 Token. Längere Eingaben kürzt es ohne Fehlermeldung, ollama ps zeigt die tatsächliche Länge.
Wird ein Modell mit langem Kontext langsamer?
Ja. Qwen3 8B schrieb bei 32.768 Token Kontext und gut 25.000 Token Inhalt rund ein Viertel langsamer als mit kurzem Prompt, und das Einlesen dauerte 3,5 Sekunden.
Quellen
Stand:
- Eigene Messung: Kontextreihe Ollama 0.40.0 auf RTX 4090 (Treiber 621.35, CUDA 13.5), Testrechner Ryzen 9 7950X3D, 128 GB; qwen3:8b und qwen3:14b in Q4_K_M, num_ctx 4096 bis 131072, Fülltext auf rund 80 Prozent, Aufwärmlauf und drei Läufe, Median, Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- Ollama: Kontextlänge (Dokumentation), abgerufen am 22.11.2026. zurück
- Ollama: Häufige Fragen (FAQ), abgerufen am 22.11.2026. zurück
- Ollama: API: Antwort erzeugen (generate), abgerufen am 22.11.2026. zurück
- Qwen (Alibaba): Modellkarte Qwen3-8B, abgerufen am 22.11.2026. zurück
- Qwen (Alibaba): Qwen3-8B: Konfiguration (config.json), abgerufen am 22.11.2026. zurück
- Qwen (Alibaba): Qwen3-14B: Konfiguration (config.json), abgerufen am 22.11.2026. zurück
- Ollama: Bibliothek: qwen3, Tags und Größen, abgerufen am 22.11.2026. zurück