Lokale KI
Eigenes Modell feinjustieren
Kurzantwort
Eine eigene KI trainierst du zu Hause, indem du ein vorhandenes offenes Modell mit LoRA oder QLoRA feinjustierst12; ein Sprachmodell von Grund auf zu trainieren, übersteigt aus unserer Sicht die Möglichkeiten eines Heimrechners. Nötig sind mindestens 100, besser über 1.000 saubere Beispiele und eine Grafikkarte, für ein Modell mit acht Milliarden Parametern in vier Bit ab etwa 6 GB46. Das Ergebnis ist ein kleiner Adapter, den du als GGUF-Datei in Ollama oder LM Studio nutzt5.
Hinter der Suche nach "eigene KI trainieren" steckt meist der Wunsch, dass ein Sprachmodell so schreibt wie das eigene Unternehmen, ein festes Antwortformat einhält oder Fachbegriffe richtig verwendet. Ein Modell von Grund auf neu zu trainieren, braucht aus unserer Sicht weit mehr Rechenzeit, als ein Heimrechner bietet. Machbar ist das Feinjustieren eines vorhandenen offenen Modells, auf Englisch Fine-Tuning. Das gängige Verfahren dafür heißt LoRA: Die Gewichte des Ausgangsmodells bleiben eingefroren, trainiert werden nur zwei kleine Zusatzmatrizen je Schicht3. Die Autoren berichten für GPT-3 mit 175 Milliarden Parametern, dass LoRA die Zahl der trainierbaren Parameter um das Zehntausendfache und den Grafikspeicher auf ein Drittel senkt, ohne die Antworten zu verlangsamen1.
Einen eigenen Trainingslauf auf unserer RTX 4090 haben wir noch nicht gemessen. Die Schritte unten folgen der Dokumentation von Unsloth und der Bibliothek PEFT von Hugging Face; Dauer und Speicherbedarf aus eigener Messung tragen wir nach.
Feinjustieren oder Dokumente anbinden?
Bevor du Daten sammelst, kläre, ob das Modell anders antworten oder mehr wissen soll. Beim Feinjustieren ändern sich die Gewichte des Modells, beim Verfahren RAG bekommt es zur Laufzeit passende Textstellen aus deinen Unterlagen dazu, ohne dass sich das Modell selbst verändert5. Unsloth vertritt die Ansicht, dass Feinjustieren alles leisten kann, was RAG kann, umgekehrt aber nicht5.
Aus unserer Sicht spricht im Alltag trotzdem vieles für RAG, wenn sich das Wissen oft ändert, etwa bei Preislisten, Handbüchern oder Verträgen. Ein trainiertes Modell müsstest du nach jeder Änderung neu trainieren, eine Dokumentensammlung tauschst du einfach aus. Feinjustieren spielt seine Stärken bei Ton, Format und wiederkehrenden Aufgaben aus. Für Betriebe kommt die Frage dazu, ob ein RAG-System mit Dokumentensuche nicht weniger Pflege braucht (RAG oder Fine-Tuning).
Grafikspeicher und Zeitaufwand
Der Speicherbedarf hängt an der Größe des Modells und am Verfahren. QLoRA lädt das Ausgangsmodell in vier Bit und trainiert darauf die LoRA-Matrizen; so ließ sich in der Studie von 2023 ein Modell mit 65 Milliarden Parametern auf einer einzelnen Karte mit 48 GB feinjustieren2. Unsloth nennt als absolute Untergrenze diese Werte4:
- 3 Milliarden Parameter: 3,5 GB mit QLoRA, 8 GB mit LoRA in 16 Bit4
- 8 Milliarden Parameter: 6 GB mit QLoRA, 22 GB mit LoRA in 16 Bit4
- 14 Milliarden Parameter: 8,5 GB mit QLoRA, 33 GB mit LoRA in 16 Bit4
- 32 Milliarden Parameter: 26 GB mit QLoRA, 76 GB mit LoRA in 16 Bit4
- 70 Milliarden Parameter: 41 GB mit QLoRA, 164 GB mit LoRA in 16 Bit4
Für unseren Testrechner heißt das: Auf der RTX 4090 mit 24 GB und der RTX 5060 Ti mit 16 GB passen Modelle bis 14 Milliarden Parameter mit QLoRA, ein Modell mit 32 Milliarden Parametern schon nicht mehr4. LoRA in 16 Bit ist auf der 4090 nur für Modelle bis etwa acht Milliarden Parameter möglich. Da es sich um Mindestwerte handelt, brauchen längere Trainingsbeispiele mehr Speicher.
Unsloth setzt eine NVIDIA-Karte mit Rechenfähigkeit 7.0 oder höher voraus, also ab der RTX-20-Serie; eine GTX 1070 oder 1080 funktioniert, aber langsam4. Unter Windows 10 und 11 läuft Unsloth Studio ohne WSL, unter Linux ab Ubuntu 20.044. Zur Dauer machen die Quellen nur grobe Angaben: Für einen schnellen Test empfiehlt Unsloth 60 Trainingsschritte, für einen vollständigen Lauf eine bis drei Runden über alle Daten5. In der QLoRA-Studie brauchte das beste Modell 24 Stunden auf einer einzelnen Karte2.
Welche Werkzeuge du brauchst
Zwei Wege sind verbreitet. Unsloth bündelt Training, Speichersparen und Export in einem Paket; unter Windows gibt es dafür Unsloth Studio, das ohne das Linux-Subsystem WSL auskommt4. Für die Ausgangsmodelle bietet Unsloth eigene Fassungen in vier Bit an, erkennbar an der Endung unsloth-bnb-4bit im Namen, und empfiehlt diese, wo es sie gibt5.
Wer lieber selbst programmiert, nutzt die Python-Bibliothek PEFT von Hugging Face. Dort beschreibt eine Konfiguration mit LoraConfig Rang, Skalierung und Zielschichten, und get_peft_model legt den Adapter um das geladene Modell3. Unsloth baut auf denselben Begriffen auf, die Werte aus Schritt 3 gelten für beide Wege.
Praktisch ist, dass sich mehrere Adapter für dasselbe Ausgangsmodell kombinieren lassen. PEFT kann zwei Adapter mit Gewichten wie 0,7 und 0,3 zu einem neuen verrechnen3. So trainierst du etwa einen Adapter für den Ton und einen für ein Antwortformat getrennt. Bei quantisierten Modellen lässt sich ein einmal eingerechneter Adapter allerdings nicht exakt wieder herauslösen, und mehrfaches Zusammenführen und Trennen summiert Rundungsfehler3. Bewahre deshalb immer den ursprünglichen Adapter auf.
Schritt 1: Ziel und Ausgangsmodell festlegen
Schreib in zwei Sätzen auf, was das Modell danach besser können soll, und lege zehn Testfragen fest, an denen du das später prüfst. Als Ausgangsmodell empfiehlt Unsloth ein kleines Instruct-Modell, etwa Llama 3.1 mit acht Milliarden Parametern5. Instruct-Modelle sind schon auf Gespräche trainiert und brauchen weniger Daten als reine Basismodelle5. Beachte die Lizenz: Was du mit dem fertigen Modell tun darfst, regelt die Lizenz des Ausgangsmodells, und die unterscheidet sich zwischen den Familien deutlich (Welches lokale Modell?).
Schritt 2: Trainingsdaten aufbereiten
Die Daten entscheiden über das Ergebnis. Unsloth nennt mindestens 100 Zeilen als Untergrenze für brauchbare Ergebnisse und bezeichnet mehr als 1.000 Zeilen als besser6. Jede Zeile ist ein Beispiel, oft eine Frage mit der gewünschten Antwort5. Für Gespräche mit mehreren Runden gibt es zwei verbreitete Formate: ShareGPT mit den Feldern from und value und ChatML mit role und content; Hugging Face nutzt ChatML als Standard6.
So gehst du vor:
- Sammle echte Beispiele aus deiner Arbeit, etwa beantwortete Kundenanfragen oder Texte im gewünschten Stil.
- Entferne Dubletten, Tippfehler und Antworten, die du selbst nicht mehr so geben würdest. Die Qualität der Trainingsdaten bestimmt die Qualität des Modells6.
- Entferne personenbezogene Angaben, die das Modell nicht lernen soll; was im Training steckt, kann später in Antworten auftauchen. Hinweise zum Umgang mit solchen Daten im Betrieb stehen unter KI und Datenschutz.
- Bring alles in ein einheitliches Format, zum Beispiel eine JSONL-Datei mit einem Gespräch je Zeile im ChatML-Format.
- Leg einen Teil zur Seite. Unsloth schlägt vor, 20 Prozent der Daten für die Prüfung zurückzuhalten5.
Fehlen dir Beispiele, kannst du welche von einem Sprachmodell erzeugen lassen5. Solche Daten prüfst du besonders gründlich und sortierst unpassende Antworten aus6.
Schritt 3: Training einstellen
Unsloth empfiehlt, mit QLoRA zu beginnen; ein volles Feinjustieren aller Gewichte sei selten nötig5. Zwei Werte bestimmen die Größe des Adapters. Der Rang r legt fest, wie viele Parameter der Adapter trainiert: Ein höherer Rang lernt mehr, braucht aber auch mehr Speicher3. lora_alpha skaliert den Einfluss des Adapters, standardmäßig im Verhältnis lora_alpha geteilt durch r3. Mit target_modules="all-linear" bekommt jede lineare Schicht einen Adapter, wie bei QLoRA üblich3.
Als Startwerte nennt Unsloth eine Stapelgröße von 2 mit 4 Schritten Gradientenakkumulation, eine Sequenzlänge von 2048 Token und eine Lernrate von 2e-45. Für feinere Anpassungen schlägt Unsloth kleinere Lernraten wie 1e-4 oder 5e-5 vor5. Trainiere eine Runde über alle Daten und erhöhe höchstens auf drei5.
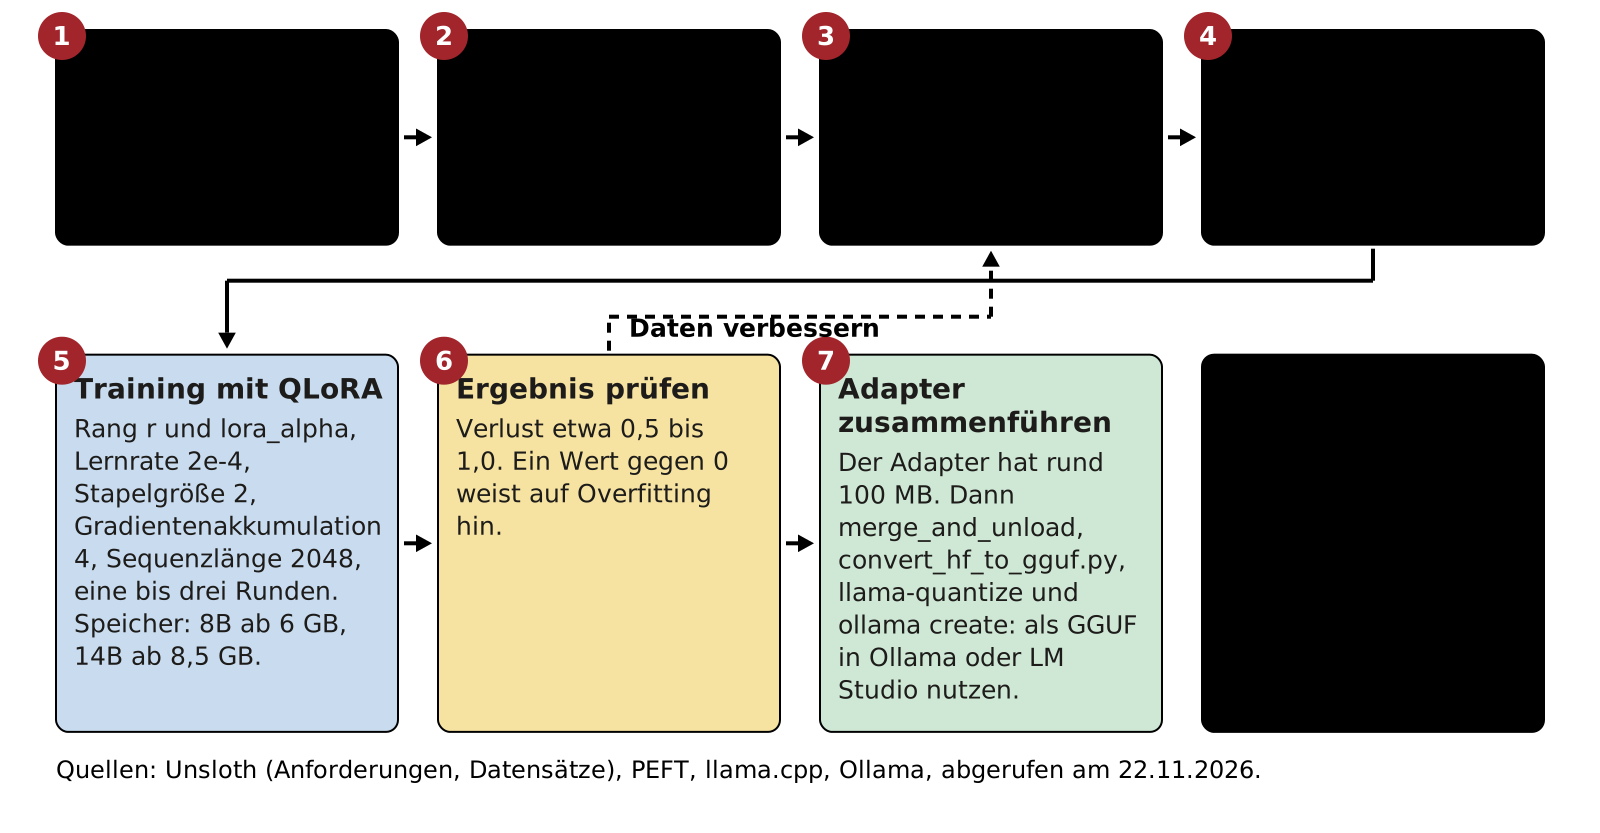
- QLoRA Training auf einem Modell in vier Bit
- Adapter die trainierten Zusatzmatrizen
- GGUF Dateiformat für Ollama und LM Studio
Schritt 4: Ergebnis prüfen
Während des Trainings sinkt der Verlust, eine Kennzahl dafür, wie weit die Antworten des Modells von deinen Beispielen abweichen. Ein Wert zwischen etwa 0,5 und 1,0 ist laut Unsloth oft ein gutes Zeichen; fällt er gegen 0, hat das Modell die Beispiele vermutlich auswendig gelernt5. Dieses Overfitting erkennst du an den zurückgehaltenen Testdaten: Antwortet das Modell dort deutlich schlechter als auf den Trainingsdaten, war das Training zu lang oder die Daten zu einseitig.
Stell danach deine zehn Testfragen aus Schritt 1, einmal an das Ausgangsmodell und einmal an das feinjustierte. Erst dieser Vergleich zeigt, ob sich der Aufwand gelohnt hat.
Schritt 5: Den Adapter nutzen
Das Training liefert einen LoRA-Adapter von etwa 100 MB, der auf dem Ausgangsmodell aufsetzt5. Mit merge_and_unload führst du Adapter und Ausgangsmodell zu einem Modell zusammen3. Für Ollama, llama.cpp oder LM Studio wandelst du das Ergebnis in eine GGUF-Datei um5: zuerst mit dem Skript convert_hf_to_gguf.py, dann mit llama-quantize auf vier Bit7. Beide Werkzeuge gehören zu llama.cpp.
In Ollama bindest du die Datei über eine Modelfile ein und legst das Modell mit ollama create -f Modelfile an8. Danach startest du es wie jedes andere Modell (Ollama installieren). Heb die Trainingsdaten auf: Erscheint ein besseres Ausgangsmodell, trainierst du mit denselben Beispielen einen neuen Adapter.
Was das für dich heißt
Lege vor dem ersten Training fest, was das Modell besser können soll, und prüfe am Ende genau das.
- Schreib zehn Testfragen auf, bevor du Daten sammelst.
- Fang mit einem Instruct-Modell mit acht Milliarden Parametern und QLoRA an.
- Halte ein Fünftel der Beispiele für die Prüfung zurück.
- Prüfe vor dem Einsatz, was die Lizenz des Ausgangsmodells erlaubt.
Häufige Fragen
Wie viele Beispiele brauche ich für LoRA?
Unsloth nennt mindestens 100 Zeilen und mehr als 1.000 als besser6. Wichtiger als die Menge ist, dass die Beispiele sauber und einheitlich sind.
Reicht eine Grafikkarte mit 8 GB?
Lernt das Modell durch Feinjustieren neues Wissen?
Es übernimmt Inhalte aus den Beispielen, aber ändern lässt sich dieses Wissen nur durch neues Training. Für Wissen, das sich oft ändert, ist aus unserer Sicht das Anbinden von Dokumenten per RAG der einfachere Weg, weil du die Dokumente austauschen kannst, ohne neu zu trainieren.
Kann ich das feinjustierte Modell in LM Studio nutzen?
Ja, als GGUF-Datei. Unsloth nennt Ollama, llama.cpp und LM Studio als Ziel für die Umwandlung5.
Quellen
Stand:
- Hu, Shen, Wallis u. a. (arXiv): LoRA: Low-Rank Adaptation of Large Language Models, Stand 17.06.2021, abgerufen am 22.11.2026. zurück
- Dettmers, Pagnoni, Holtzman, Zettlemoyer (arXiv): QLoRA: Efficient Finetuning of Quantized LLMs, Stand 23.05.2023, abgerufen am 22.11.2026. zurück
- Hugging Face: PEFT: LoRA (Entwicklerhandbuch), abgerufen am 22.11.2026. zurück
- Unsloth: Anforderungen an Hardware und System, abgerufen am 22.11.2026. zurück
- Unsloth: Anleitung zum Feinjustieren von Sprachmodellen, abgerufen am 22.11.2026. zurück
- Unsloth: Leitfaden für Datensätze, abgerufen am 22.11.2026. zurück
- ggml-org: llama.cpp: llama-quantize (README), abgerufen am 22.11.2026. zurück
- Ollama: CLI-Referenz, abgerufen am 22.11.2026. zurück