Lexikon · V
Verlustfunktion
Kurzantwort
Liegt eine Vorhersage daneben, macht die Verlustfunktion, englisch loss function, daraus eine einzige Zahl: Je größer sie ist, desto falscher lag das Modell1. Das Training besteht darin, diese Zahl zu senken. Für Zahlenwerte ist oft der mittlere quadratische Fehler im Einsatz, für die Einordnung in Klassen die Kreuzentropie13.
Das Training braucht eine Rückmeldung, wie gut ein Modell gerade ist, und zwar in einer Form, mit der der Gradientenabstieg rechnen kann. Diese Rückmeldung ist der Verlust, ob das Modell nun einen Wohnungspreis schätzt oder E-Mails als Spam aussortiert. Kennzahlen wie die Accuracy oder der F1-Score beurteilen das fertige Modell aus fachlicher Sicht; die Verlustfunktion ist das Maß, auf das hin trainiert wird, und beide können auseinanderlaufen.
Abstand ohne Vorzeichen
Der Verlust ist eine Zahl, die beschreibt, wie falsch die Vorhersagen eines Modells sind1. Es zählt der Abstand zwischen Vorhersage und richtigem Wert, die Richtung spielt keine Rolle. Deshalb wird das Vorzeichen entfernt, entweder über den Betrag oder über das Quadrat der Differenz1. Daraus ergeben sich die gängigen Formen für Zahlenvorhersagen: der L1-Verlust als Summe der Beträge, der mittlere absolute Fehler (MAE) als ihr Durchschnitt, der L2-Verlust als Summe der Quadrate und der mittlere quadratische Fehler (MSE) als deren Durchschnitt1. In PyTorch heißt die Funktion für den MSE `MSELoss`, sie mittelt standardmäßig über alle Werte4.
Was das Quadrieren mit Ausreißern macht
Beim Quadrieren wachsen große Abweichungen überproportional. Ein Fehler von 2 wird zu 4, ein Fehler von 10 zu 100. Der MSE zieht das Modell deshalb stärker zu Ausreißern hin, der MAE gilt als robuster1. Zum MSE rät der Crash Course von Google, wenn große Fehler besonders teuer sind oder wenn die Ausreißer echte Streuung zeigen, die das Modell abbilden soll. Stören einzelne Ausreißer nur, ist der MAE die bessere Wahl1.
Kreuzentropie für Klassen
Gibt ein Modell Wahrscheinlichkeiten aus, passt der quadratische Fehler schlecht. Bei der logistischen Regression ändert sich die Ausgabe über die S-förmige Sigmoidkurve ungleichmäßig, und nahe 0 und 1 bräuchte die quadratische Rechnung immer mehr Genauigkeit2. Dort kommt deshalb der logarithmische Verlust (Log Loss) zum Einsatz2. Er schaut auf die Wahrscheinlichkeit, die das Modell der richtigen Antwort gegeben hat. Weil der Logarithmus gegen null steil abfällt, kostet eine selbstsichere Fehlentscheidung sehr viel. Für mehrere Klassen verallgemeinert die Kreuzentropie dieselbe Idee. In PyTorch erwartet `CrossEntropyLoss` die rohen, nicht normierten Ausgabewerte je Klasse und ist für Klassifikation mit beliebig vielen Klassen gedacht; mit dem Parameter `label_smoothing` lässt sich die Zielverteilung etwas glätten3. Das Lehrbuch "Deep Learning" nennt einen weiteren Vorteil: Der negative Log-Likelihood-Verlust, zu dem die Kreuzentropie gehört, verhindert in vielen Modellen, dass der Gradient in flachen Bereichen der Ausgabefunktion versiegt5.
Die Verlustkurve lesen
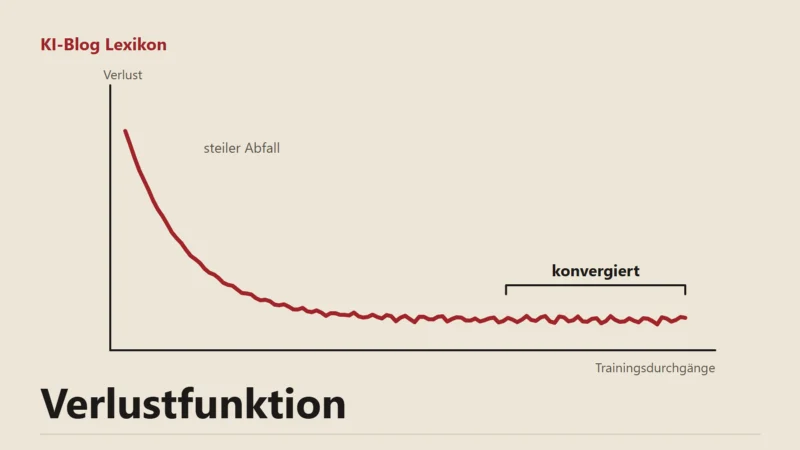
Trägt man den Verlust über die Trainingsdurchgänge auf, fällt die Kurve zuerst steil und flacht dann ab. Hört sie auf zu sinken, ist das Modell konvergiert6. Mehr verrät die Kurve, wenn daneben der Verlust auf zurückgehaltenen Validierungsdaten mitläuft. Laufen beide auseinander, ist das ein Zeichen für Overfitting7.
Häufige Fragen
Ist der Verlust dasselbe wie die Fehlerquote?
Die Fehlerquote zählt nur richtige und falsche Antworten. Der Verlust bezieht ein, wie sicher sich das Modell war, und lässt sich ableiten; deshalb kann das Training mit ihm rechnen.
Warum steigt der Validierungsverlust, während der Trainingsverlust weiter sinkt?
Das Modell passt sich zu eng an die Trainingsbeispiele an und verliert an Treffsicherheit bei neuen Daten. Google beschreibt genau dieses Auseinanderlaufen der Kurven als Hinweis auf Überanpassung7.
MSE oder MAE, was soll ich nehmen?
Sind große Fehler besonders teuer, spricht das für den MSE. Willst du verhindern, dass wenige Ausreißer das Modell verziehen, nimm den MAE1.
Quellen
Stand:
- Google for Developers: Machine Learning Crash Course: Linear regression, Loss, abgerufen am 22.11.2026. zurück
- Google for Developers: Machine Learning Crash Course: Logistic regression, Loss and regularization, abgerufen am 22.11.2026. zurück
- PyTorch-Dokumentation 2.15: CrossEntropyLoss, abgerufen am 22.11.2026. zurück
- PyTorch-Dokumentation 2.15: MSELoss, abgerufen am 22.11.2026. zurück
- Goodfellow, Bengio, Courville: Deep Learning, Kapitel 6: Deep Feedforward Networks, Stand 2016, abgerufen am 22.11.2026. zurück
- Google for Developers: Machine Learning Crash Course: Linear regression, Gradient descent, abgerufen am 22.11.2026. zurück
- Google for Developers: Machine Learning Crash Course: Overfitting, abgerufen am 22.11.2026. zurück