Lexikon · L
Lernrate
Kurzantwort
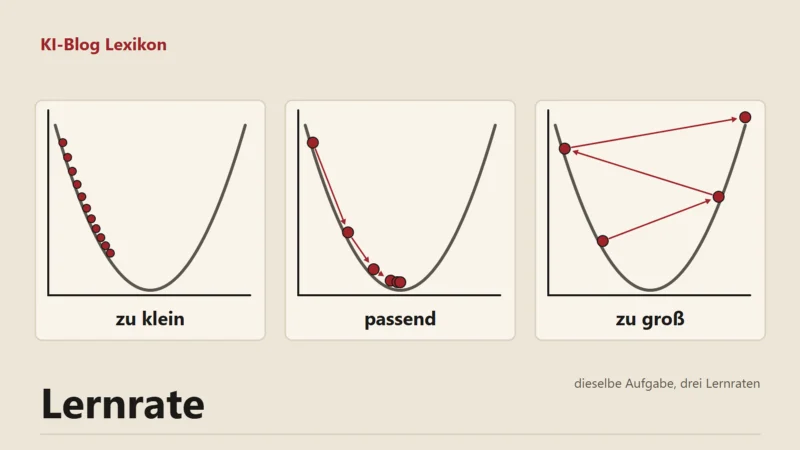
Ein Gradient von 2,5 und eine Lernrate von 0,01 verändern einen Parameter um 0,0251. Die Lernrate ist also der Faktor, mit dem das Training jeden Korrekturschritt verkleinert oder vergrößert. Ist sie zu klein, dauert das Training lange; ist sie zu groß, springt das Modell über das Ziel hinaus12.
Bevor das Training beginnt, legt jemand die Lernrate fest. Sie gehört zu den Hyperparametern, also zu den Werten, die das Modell anders als seine Parameter nicht selbst lernt. Laut Google beeinflusst sie, wie schnell das Training konvergiert1. Im Englischen heißt der Wert learning rate, in den Formeln bei Ruder steht dafür der griechische Buchstabe Eta2.
Zu klein, zu groß
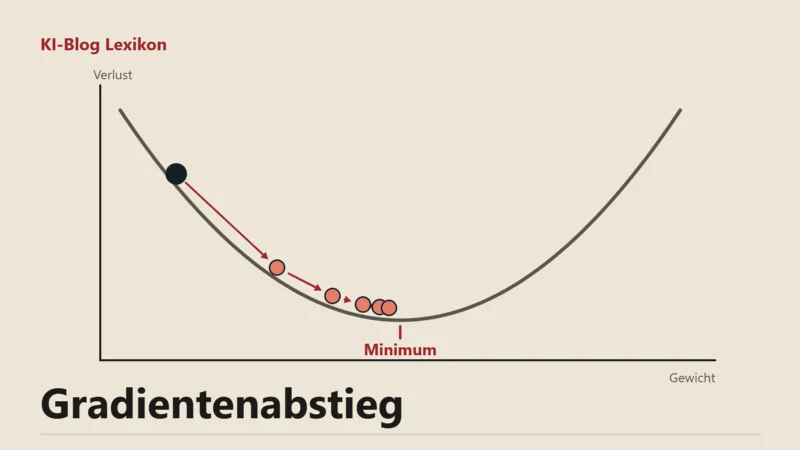
Mit einer sehr kleinen Lernrate kommt das Training zwar voran, aber zäh: Jede Runde bringt nur einen winzigen Fortschritt, und bis zur Konvergenz vergeht viel Zeit1. Sebastian Ruder nennt diese Langsamkeit in seiner Übersicht über Optimierungsverfahren schmerzhaft2. Am anderen Ende springt das Modell um das Minimum herum und kommt dort nie zur Ruhe. Der Verlust schwankt dann oder steigt sogar, das Training kann ganz auseinanderlaufen12. In tiefen Netzen kann eine zu große Lernrate außerdem die Gradienten explodieren lassen oder ReLU-Einheiten dauerhaft stilllegen; in beiden Fällen hilft eine kleinere Lernrate7. Die richtige Größe hängt vom Problem ab; Google empfiehlt einen Wert, der weder zu hoch noch zu niedrig ist, damit das Modell zügig konvergiert1.
Das Verfahren, das die Schritte ausführt, ist der Gradientenabstieg; die Lernrate entscheidet dort nur über die Weite jedes Schritts.
Ausgangswerte aus der Dokumentation
Als Ausgangswerte dienen die Vorgaben der Bibliothek. Der Optimierer Adam ist in PyTorch mit einer Lernrate von 0,001 voreingestellt4. Die Übersichtsseite der Optimierer zeigt als Beispiel einfachen SGD mit 0,01 und Momentum3. Mit genau dieser Schrittweite von 0,01 rechnet auch das Lehrbeispiel von Google zum Gradientenabstieg; das kleine lineare Modell dort konvergiert nach rund 1.000 Durchgängen8. Solche Werte sind Startpunkte für eigene Versuche. Leslie Smith schlug 2015 einen schnellen Test vor: Man erhöht die Lernrate über wenige Epochen gleichmäßig und beobachtet, ab wann das Training anspricht und ab wann es aus dem Ruder läuft5. Aus diesem Bereich lassen sich vernünftige Grenzen ablesen.
Die Lernrate während des Trainings ändern
Die Lernrate muss nicht über das ganze Training gleich bleiben. Lernratenpläne senken den Wert nach einem vorher festgelegten Schema oder dann, wenn sich der Verlust zwischen zwei Epochen kaum noch ändert2. PyTorch bringt dafür fertige Bausteine mit, etwa `StepLR`, `CosineAnnealingLR`, `ReduceLROnPlateau` und `OneCycleLR`3. Smith ging einen anderen Weg und ließ die Lernrate zwischen zwei Grenzen zyklisch auf und ab schwanken; nach seinen Versuchen erspart das weitgehend die Suche nach dem besten festen Wert und Plan5. Adam wiederum passt die Schrittweite für jeden Parameter einzeln an2. Die globale Lernrate legt dabei aber weiterhin den Maßstab fest.
Wer die Lernrate ändert, sollte nach dem Rat von Google auch die Rate der Regularisierung neu abstimmen, weil beide die Gewichte in entgegengesetzte Richtungen ziehen6.
Häufige Fragen
Woran erkenne ich, dass meine Lernrate zu hoch ist?
Der Verlust springt von Runde zu Runde hin und her oder wächst sogar. Das Modell kommt dann nicht zur Konvergenz1.
Was ist ein Learning Rate Finder?
So heißen Werkzeuge, die den Test von Leslie Smith automatisieren: Die Lernrate steigt über wenige Epochen an, und aus dem Verlauf des Verlusts lässt sich ein sinnvoller Bereich ablesen5.
Quellen
Stand:
- Google for Developers: Machine Learning Crash Course: Linear regression, Hyperparameters, abgerufen am 22.11.2026. zurück
- arXiv (Sebastian Ruder): An overview of gradient descent optimization algorithms, Stand 15.06.2017, abgerufen am 22.11.2026. zurück
- PyTorch-Dokumentation 2.15: torch.optim, Stand 27.08.2026, abgerufen am 22.11.2026. zurück
- PyTorch-Dokumentation 2.15: Adam, abgerufen am 22.11.2026. zurück
- arXiv (Leslie N. Smith): Cyclical Learning Rates for Training Neural Networks, Stand 04.04.2017, abgerufen am 22.11.2026. zurück
- Google for Developers: Machine Learning Crash Course: Overfitting, L2 regularization, abgerufen am 22.11.2026. zurück
- Google for Developers: Machine Learning Crash Course: Neural networks, Backpropagation, abgerufen am 22.11.2026. zurück
- Google for Developers: Machine Learning Crash Course: Linear regression, Gradient descent, abgerufen am 22.11.2026. zurück