Lexikon · R
ROC-Kurve
Lange vor dem maschinellen Lernen nutzte die Signalentdeckungstheorie solche Kurven, um Trefferquote und Fehlalarmrate gegeneinander abzuwägen; später übernahm sie die medizinische Diagnostik2. ROC steht für Receiver Operating Characteristic. Tom Fawcett hat 2006 eine Einführung veröffentlicht, die erklärt, wie man die Kurven im maschinellen Lernen liest und wo die Fallstricke liegen2.
Was auf den Achsen steht
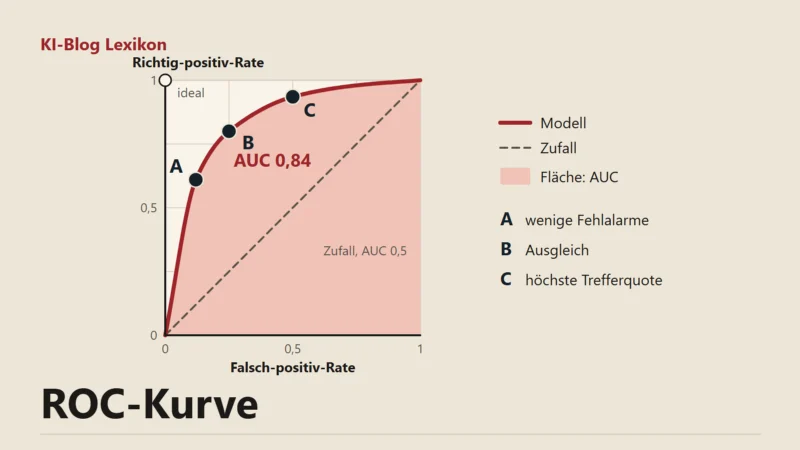
Auf der waagerechten Achse steht die Falsch-positiv-Rate: der Anteil der negativen Fälle, die das Modell fälschlich als positiv meldet1. Auf der senkrechten Achse steht die Richtig-positiv-Rate, also der Recall aus Präzision und Recall1. Jeder Punkt der Kurve gehört zu einer Schwelle. Ist sie sehr hoch, meldet das Modell fast nichts und sitzt links unten; ist sie sehr niedrig, meldet es alles und landet rechts oben.
Wie ein einzelner Punkt entsteht, zeigt ein Test an 100 kranken und 900 gesunden Personen: Bei einer bestimmten Schwelle meldet er 80 Kranke und 45 Gesunde als positiv. Die Richtig-positiv-Rate beträgt 80 von 100, also 0,8, die Falsch-positiv-Rate 45 von 900, also 0,05. Der Punkt liegt damit bei 0,05 auf der waagerechten und 0,8 auf der senkrechten Achse. Für jede weitere Schwelle kommt ein Punkt hinzu, und zusammen ergeben sie die Kurve.
Die Diagonale von links unten nach rechts oben ist die Linie des Zufalls, ein Münzwurf läge auf ihr1. Je weiter sich die Kurve nach links oben wölbt, desto besser trennt das Modell die beiden Klassen. Der ideale Punkt liegt in der Ecke oben links, mit allen Treffern und keinem Fehlalarm1.
Die Fläche unter der Kurve (AUC)
AUC steht für Area Under the Curve. Die Zahl hat eine anschauliche Bedeutung: Sie gibt die Wahrscheinlichkeit an, dass das Modell einem zufällig gezogenen positiven Fall einen höheren Wert gibt als einem zufällig gezogenen negativen12. Fawcett setzt das mit dem Rangtest nach Wilcoxon gleich2. Liegt die AUC unter 0,5, sortiert das Modell schlechter als der Zufall1, und wer seine Entscheidungen umkehrt, bekommt ein besseres Modell2.
Weil die AUC alle Schwellen einbezieht, eignet sie sich für den Vergleich von Modellen, bevor feststeht, wo die Schwelle im Einsatz liegen soll. In scikit-learn berechnet die Funktion roc_auc_score sie aus den Wahrscheinlichkeiten oder Rohwerten eines Modells3.
Eine Schwelle aus der Kurve wählen
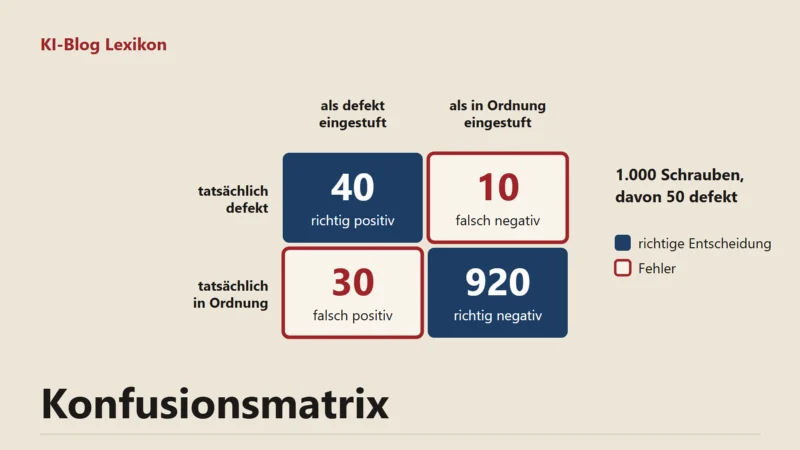
Google empfiehlt, die Schwelle nach den Kosten der Fehler zu wählen1. Die Grafik am Anfang dieser Seite folgt einem Beispiel aus diesem Kurs mit einer AUC von 0,84. Punkt A liefert eine niedrige Falsch-positiv-Rate und nimmt dafür weniger Treffer in Kauf; er passt, wenn Fehlalarme teuer sind. Punkt C holt die höchste Richtig-positiv-Rate heraus und passt, wenn übersehene Fälle viel teurer sind als Fehlalarme. Sind beide Fehler etwa gleich teuer, bietet Punkt B den besten Ausgleich1. Beim Spamfilter, wo eine wichtige Mail im Spamordner der teure Fehler ist, fällt die Wahl auf einen Punkt mit niedriger Falsch-positiv-Rate1. Was an diesem Punkt passiert, zeigt die Konfusionsmatrix mit den vier Zählwerten.
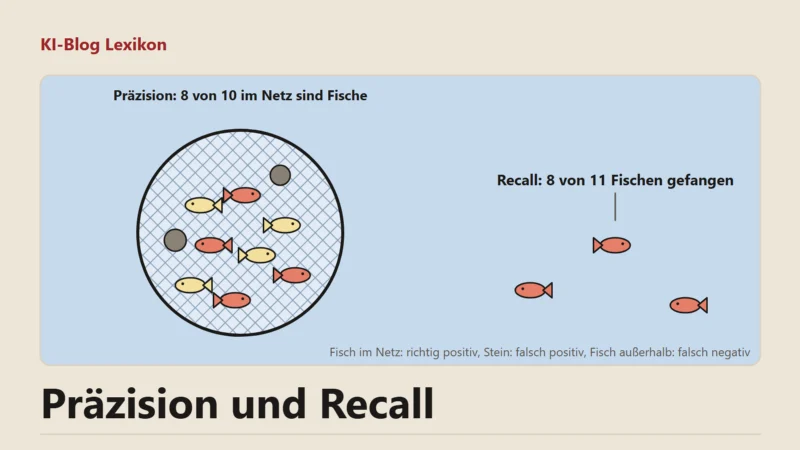
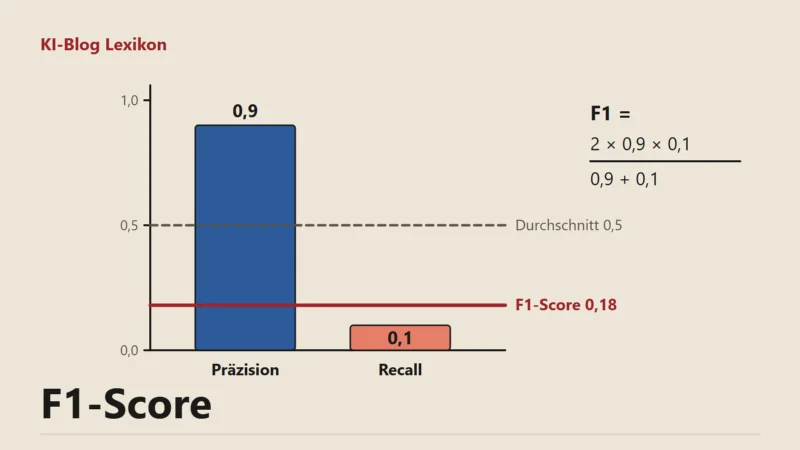
Bei sehr seltenen Zielklassen ist Vorsicht angebracht. Die ROC-Kurve bleibt gleich, egal wie die Klassen verteilt sind, und kann dadurch eine Flut von Fehlalarmen verbergen4. Takaya Saito und Marc Rehmsmeier empfehlen für solche Daten die Precision-Recall-Kurve, die den Einbruch der Präzision zeigt4. Wer Modelle bei einer bereits festgelegten Schwelle vergleicht, greift eher zum F1-Score.
Häufige Fragen
Kann die AUC hoch sein, obwohl das Modell im Einsatz versagt?
Ja, vor allem bei sehr seltenen positiven Fällen. Viele Fehlalarme fallen in der ROC-Kurve dann kaum auf, während die Präzision im Betrieb niedrig ist4.
Was hat der Gini-Koeffizient mit der AUC zu tun?
Er entspricht der doppelten Fläche zwischen Diagonale und Kurve. Es gilt: Gini plus 1 ergibt zweimal AUC2.
Quellen
Stand:
- Google for Developers: Machine Learning Crash Course: Classification, ROC and AUC, abgerufen am 22.11.2026. zurück
- Pattern Recognition Letters (Tom Fawcett): An introduction to ROC analysis, Stand 2006, abgerufen am 22.11.2026. zurück
- scikit-learn: Metrics and scoring: quantifying the quality of predictions (Version 1.9.1), abgerufen am 22.11.2026. zurück
- PLOS ONE (Saito, Rehmsmeier): The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets, Stand 04.03.2015, abgerufen am 22.11.2026. zurück