Lokale KI · Ratgeber
Whisper auf der eigenen Grafikkarte: ein Ratgeber nach Quellen
Kurzantwort
Whisper large-v3 braucht laut OpenAI rund 10 GB Grafikspeicher, die Variante turbo rund 6 GB und läuft etwa achtmal so schnell4. Beide passen damit auf eine RTX 4090 mit 24 GB und auf eine RTX 5060 Ti mit 16 GB67. Whisper selbst haben wir auf diesen Karten nicht gemessen; die Seite stützt sich auf die Angaben von OpenAI und faster-whisper.
Für deutsche Abschriften auf dem eigenen Rechner reicht eine Grafikkarte mit 16 GB: Whisper large-v3 braucht nach den Angaben von OpenAI rund 10 GB Grafikspeicher, large-v3-turbo rund 6 GB4. Turbo rechnet laut OpenAI etwa achtmal so schnell wie large und verliert dabei nur wenig an Qualität34. Mit faster-whisper geht es noch einmal schneller und sparsamer5. Whisper lief auf unserem Testrechner bisher nicht. Was hier zu Tempo, Speicher und Genauigkeit steht, stammt aus den Modellkarten und den Projektseiten; selbst gemessen haben wir nur, wie viel Platz ein Sprachmodell für die Zusammenfassung danach auf denselben Karten braucht1.
Platz für die Zusammenfassung: Qwen3 auf beiden Karten
- Hardware
- RTX 4090 (24 GB) und RTX 5060 Ti (16 GB), Treiber 621.35; AMD Ryzen 9 7950X3D, 128 GB
- Modell
- Qwen3 8B und Qwen3 14B, jeweils Q4_K_M
- Werkzeug
- Ollama 0.40.0
- Messgröße
- zusätzlich belegter Grafikspeicher und Ausgabe-Token je Sekunde; Median aus drei Läufen
- Gemessen am
| Qwen3 8B, RTX 4090: Grafikspeicher zusätzlich | 5,7 GiB |
|---|---|
| Qwen3 14B, RTX 4090: Grafikspeicher zusätzlich | 9,6 GiB |
| Qwen3 8B, RTX 5060 Ti: Grafikspeicher zusätzlich | 5,6 GiB |
| Qwen3 14B, RTX 5060 Ti: Grafikspeicher zusätzlich | 9,3 GiB |
| Qwen3 8B, RTX 4090: Token je Sekunde | 145,9 |
| Qwen3 14B, RTX 4090: Token je Sekunde | 85,7 |
| Qwen3 8B, RTX 5060 Ti: Token je Sekunde | 75,1 |
| Qwen3 14B, RTX 5060 Ti: Token je Sekunde | 43,3 |
Whisper selbst ist nicht gemessen; Kontext 8.192 Token, Temperatur 0, 256 Token Ausgabe, Denkmodus aus
Ohne eigene Whisper-Messung
Der Messlauf vom 22.11.2026 umfasste nur Sprach- und Bildmodelle1. Eine eigene Messreihe mit deutschen Aufnahmen gibt es nicht. Wortfehlerraten oder Echtzeitfaktoren von Whisper auf der RTX 4090 oder der RTX 5060 Ti nennen wir nicht.
Der Messwertkasten zeigt Werte aus demselben Lauf, die für eine typische Kette aus Abschrift und Zusammenfassung zählen: Wie viel Grafikspeicher belegen Qwen3 8B und Qwen3 14B auf beiden Karten, und wie schnell schreiben sie1? Damit lässt sich abschätzen, ob Whisper und ein Sprachmodell gleichzeitig auf eine Karte passen.
Die Modelle und die Programme
Whisper large-v3 ist das große mehrsprachige Modell von OpenAI mit 1.550 Millionen Parametern2. Laut Modellkarte wurde es mit einer Million Stunden schwach beschrifteter und vier Millionen Stunden maschinell beschrifteter Audiodaten trainiert und macht gegenüber large-v2 je nach Sprache 10 bis 20 Prozent weniger Fehler2. Die Variante large-v3-turbo ist eine abgespeckte Fassung desselben Modells: Der Decoder hat nur noch 4 statt 32 Schichten, das Modell kommt auf 809 Millionen Parameter3. OpenAI beschreibt es als deutlich schneller bei einer geringen Einbuße an Qualität3.
Die Original-Implementierung von OpenAI nennt für large rund 10 GB Grafikspeicher und für turbo rund 6 GB, dazu eine etwa achtmal höhere Geschwindigkeit für turbo4. Diese Tempoangaben stammen aus Abschriften englischer Sprache auf einer Rechenzentrumskarte vom Typ A100, und OpenAI weist darauf hin, dass Sprache, Sprechtempo und Hardware das Ergebnis deutlich verschieben4. Auf einer Spielegrafikkarte und mit deutschen Aufnahmen können die Werte also anders ausfallen.
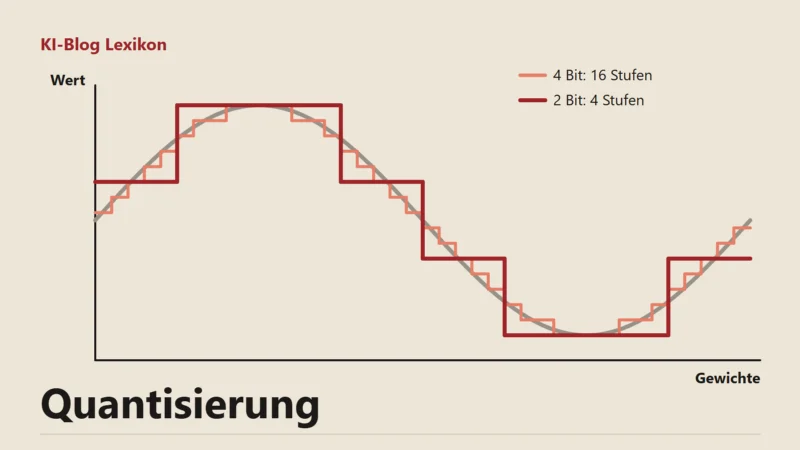
faster-whisper ist eine Neuimplementierung auf Basis von CTranslate2. Das Projekt gibt an, bei gleicher Genauigkeit bis zu viermal schneller als die Fassung von OpenAI zu sein und weniger Speicher zu brauchen5. Für die Ausführung auf der Grafikkarte verlangt es die CUDA-12-Fassungen von cuBLAS und cuDNN 95. Was hinter den Präzisionen int8 und fp16 steckt, erklärt das Lexikon unter Quantisierung.
Warum turbo schneller ist
Whisper besteht aus zwei Teilen. Der Encoder verarbeitet das Audio in Abschnitten, der Decoder erzeugt daraus den Text Token für Token. Bei large-v3-turbo hat OpenAI den Decoder von 32 auf 4 Schichten gekürzt3. Weil der Decoder für jedes einzelne Token neu rechnet, spart diese Kürzung bei langen Abschriften viel Zeit, während die Verarbeitung des Audios im Encoder gleich aufwendig bleibt.
Large-v3 verarbeitet das Audio außerdem mit 128 Frequenzbändern statt der 80 früherer Fassungen2. Für Übersetzungen ist turbo laut OpenAI nicht trainiert4. Wer deutsche Aufnahmen direkt in englischen Text übertragen will, bleibt deshalb bei large; für reine deutsche Abschriften spielt das keine Rolle.
Tempo und Speicher nach den Projektangaben
Die genaueste veröffentlichte Gegenüberstellung der Programme liefert faster-whisper selbst. Gemessen wurde mit dem älteren Modell large-v2 an 13 Minuten Audio auf einer RTX 3070 Ti mit 8 GB unter CUDA 12.4, jeweils mit Beam-Größe 55.

- Links Rechenzeit in Sekunden
- Rechts Grafikspeicher in MB
Die Fassung von OpenAI brauchte dort in fp16 2 Minuten und 23 Sekunden bei 4.708 MB Grafikspeicher5. faster-whisper schaffte dieselbe Aufnahme in fp16 in 1 Minute und 3 Sekunden bei 4.525 MB, mit 8-Bit-Gewichten in 59 Sekunden bei 2.926 MB5. Mit Stapelverarbeitung (batch_size 8) sank die Zeit auf 17 Sekunden in fp16 und 16 Sekunden in int8, der Speicher stieg dabei auf 6.090 beziehungsweise 4.500 MB5. Rechnet man das in einen Echtzeitfaktor um, also Länge der Aufnahme geteilt durch Rechenzeit, kommt die Fassung von OpenAI auf etwa 5,5, faster-whisper ohne Stapel auf etwa 12 und mit Stapel auf etwa 46 (eigene Rechnung aus der Tabelle)5.
Zwei weitere Umsetzungen stehen in derselben Tabelle. whisper.cpp mit Flash Attention brauchte 1 Minute und 5 Sekunden bei 4.127 MB, die Bibliothek transformers mit SDPA 1 Minute und 52 Sekunden bei 4.960 MB5. Ohne Stapel liegen whisper.cpp und faster-whisper beim Tempo damit fast gleichauf. faster-whisper bietet mit int8 und Stapelverarbeitung aber zwei Stellschrauben, die in der Tabelle Speicher oder Zeit deutlich senken5. Wer ohne NVIDIA-Karte arbeitet, findet whisper.cpp und weitere Varianten in der Anleitung zur lokalen Transkription.
Die RTX 3070 Ti aus dieser Tabelle ist eine ältere Karte mit 8 GB. Wie schnell Whisper auf einer RTX 4090 oder RTX 5060 Ti läuft, lässt sich daraus ohne eigene Messung nicht ableiten. Für eine Abschätzung hilft die Messreihe mit Sprachmodellen: Auf der RTX 4090 erzeugte Qwen3 14B 85,7 Token je Sekunde, auf der RTX 5060 Ti 43,31. Die beiden Karten unterscheiden sich vor allem beim Speicher und bei der Speicheranbindung, die RTX 4090 hat 24 GB an einer 384-Bit-Schnittstelle, die RTX 5060 Ti 16 GB an 128 Bit67. Ob Whisper im selben Verhältnis profitiert, ist offen, weil der Encoder anders rechnet als ein Sprachmodell.
Abschrift und Zusammenfassung auf einer Karte
Viele lassen eine Abschrift anschließend von einem Sprachmodell zusammenfassen. Qwen3 14B brauchte im Betrieb 9,6 GiB zusätzlichen Grafikspeicher auf der RTX 4090 und 9,3 GiB auf der RTX 5060 Ti1. Zusammen mit large-v3 und seinen rund 10 GB nach OpenAI reichen 16 GB nicht. Mit turbo und seinen rund 6 GB bleibt rechnerisch nur etwa 1 GB Reserve, grob geschätzt aus der Angabe von OpenAI und unserer Messung14. Qwen3 8B brauchte auf beiden Karten nur 5,6 bis 5,7 GiB und schrieb auf der RTX 5060 Ti 75,1 Token je Sekunde1. Auf der RTX 4090 mit 24 GB haben large-v3 und Qwen3 14B gemeinsam Platz.
Eine lange Abschrift braucht beim Zusammenfassen außerdem viel Kontext, und der kostet Speicher. Bei Qwen3 14B wuchs die Modellgröße auf der RTX 4090 von 8,7 GiB mit 4.096 Token Kontext auf 11,2 GiB mit 32.768 Token1. Mehr als 40.960 Token nahm Ollama bei Qwen3 gar nicht an, der Rest einer längeren Eingabe fiel weg1. Das Protokoll einer mehrstündigen Besprechung solltest du deshalb in Abschnitten zusammenfassen lassen; die Einzelheiten stehen im Test zur Kontextlänge.
Wer die Modelle nacheinander lädt, umgeht das Problem: Erst die Abschrift, dann Whisper entladen, dann das Sprachmodell laden. Das kostet ein paar Sekunden Ladezeit, spart aber den Speicher. Mit int8 in faster-whisper sinkt der Bedarf von Whisper zusätzlich, in der Tabelle des Projekts um gut ein Drittel5. Welche Größen von Qwen3 auf 16 GB passen und wie schnell sie dort sind, steht auf unserer Seite zur RTX 5060 Ti.
Kleinere Modelle für schwächere Karten
Wer keine Karte mit 16 GB hat, kann zu einer kleineren Whisper-Größe greifen. OpenAI nennt in seiner Übersicht für medium mit 769 Millionen Parametern rund 5 GB Grafikspeicher bei etwa doppeltem Tempo von large, für small mit 244 Millionen Parametern rund 2 GB bei etwa vierfachem Tempo4. Die kleinsten Größen tiny und base kommen mit rund 1 GB aus4. Diese Tempoangaben beziehen sich wie alle in der Übersicht auf englische Sprache und eine A1004.
Für Deutsch kommen nur die mehrsprachigen Fassungen in Frage. Die Modelle mit der Endung .en gibt es laut OpenAI nur bis zur Größe medium, und sie sind für englische Aufnahmen gedacht4. Turbo ist mit rund 6 GB oft der bessere Kompromiss als medium, weil es auf dem großen Modell aufbaut und laut OpenAI schneller ist als medium4. Auf einer Karte mit 8 GB bleibt neben turbo und seinen rund 6 GB kaum Platz für ein zusätzliches Sprachmodell.
Wo Whisper Fehler macht
Zu erwarten ist, dass mehrere Stimmen, Hall und schmale Bandbreite wie beim Telefon die Abschrift erschweren; auch bei einer einzelnen Stimme sind Fachwörter und Eigennamen eine Fehlerquelle. Belegte Zahlen für deutsche Aufnahmen haben wir dazu nicht.
Die Modellkarte von large-v3 warnt ausdrücklich, dass das Modell Text ausgeben kann, der im Audio nicht gesprochen wird, und zu Wiederholungen neigt2. Wiederholungen lassen sich laut Modellkarte durch Beam Search und Temperaturvorgaben mindern, aber nicht ganz vermeiden2. Was eine Halluzination bei Sprachmodellen bedeutet, erklärt das Lexikon.
faster-whisper bringt dagegen einen Filter mit: Das Modell Silero VAD schneidet Passagen ohne Sprache heraus, bevor Whisper sie sieht5. In der Standardeinstellung entfernt der Filter nur Stille von mehr als zwei Sekunden, bei der Stapelverarbeitung ist er von vornherein eingeschaltet5. Für Aufnahmen mit vielen Pausen lohnt es sich, den Filter bewusst einzuschalten.
Zum Gegenhören liefert faster-whisper auf Wunsch für jedes Wort Start- und Endzeit5. Damit springst du direkt an jede Stelle, die dir in der Abschrift verdächtig vorkommt.
Genauigkeit an eigenen Aufnahmen prüfen
OpenAI veröffentlicht Fehlerraten nach Sprache auf den Datensätzen Common Voice 15 und Fleurs4. Diese Datensätze bestehen aus vorgelesenen Sätzen und geben eine Richtung vor, sagen aber wenig über dein Besprechungsprotokoll oder deine Sprachnachrichten. Eine kurze eigene Probe ist deshalb der beste Weg.
Das gängige Maß ist die Wortfehlerrate. Sie zählt, wie viele Wörter das Modell gegenüber einer geprüften Abschrift ersetzt, auslässt oder hinzufügt, und teilt diese Summe durch die Zahl der Wörter in der Abschrift. Eine Rate von null bedeutet eine fehlerfreie Abschrift. Vor dem Vergleich solltest du beide Texte gleich behandeln: alles klein, Satzzeichen entfernt, Zahlen einheitlich als Ziffern. Sonst zählt ein Modell, das "zwanzig" schreibt, wo deine Abschrift "20" hat, als Fehler.
Die Rate behandelt jeden Fehler gleich. Ein falsch geschriebener Nachname wiegt so schwer wie ein verschlucktes Füllwort, obwohl der Nachname viel wichtiger ist. Markiere deshalb zusätzlich Fehler bei Namen, Zahlen und Fachwörtern. Für das Tempo genügt eine Stoppuhr: Teile die Länge der Aufnahme durch die Rechenzeit ohne das Laden des Modells. Bei einem Faktor von 30 ist eine Stunde Audio in zwei Minuten abgeschrieben.
Wie du Whisper und faster-whisper unter Windows installierst, steht in derselben Anleitung. Für den Datenschutz spricht der eigene Rechner ohnehin: Bei einer lokalen Spracherkennung verlassen die Aufnahmen ihn nicht.
Was das für dich heißt
Für deutsche Abschriften auf dem eigenen Rechner zählen die Art deiner Aufnahmen und der freie Grafikspeicher.
- Starte mit large-v3-turbo in faster-whisper und wechsle zu large-v3, wenn dir Fehler auffallen.
- Teste das Modell mit einer eigenen kurzen Aufnahme, die deinem Alltag entspricht.
- Lies Namen, Zahlen und Fachwörter in jeder Abschrift gegen, auch bei niedriger Fehlerquote.
- Schalte den VAD-Filter ein, wenn deine Aufnahmen lange Pausen haben.
Häufige Fragen
Habt ihr Whisper auf der RTX 4090 selbst gemessen?
Nein. Die Werte zu Whisper stammen von OpenAI und faster-whisper. Selbst gemessen haben wir Sprachmodelle auf denselben Karten, die für die Zusammenfassung einer Abschrift in Frage kommen.
Wie viel Grafikspeicher braucht Whisper large-v3?
OpenAI nennt für large rund 10 GB, für turbo rund 6 GB. faster-whisper braucht laut eigener Tabelle weniger, besonders mit 8-Bit-Gewichten.
Ist Whisper turbo auf Deutsch schlechter als large-v3?
OpenAI beschreibt turbo als deutlich schneller mit einer geringen Einbuße an Qualität. Zahlen für deutsche Alltagsaufnahmen gibt es von OpenAI nicht, nur Fehlerraten auf öffentlichen Datensätzen.
Kann Whisper Wörter erfinden?
Ja. Die Modellkarte von large-v3 warnt, dass das Modell Text ausgeben kann, der im Audio nicht vorkommt, und zu Wiederholungen neigt.
Quellen
Stand:
- Eigene Messung: Testrechner Ryzen 9 7950X3D, 128 GB, RTX 4090 (24 GB) und RTX 5060 Ti (16 GB), Treiber 621.35, Ollama 0.40.0; qwen3:8b und qwen3:14b in Q4_K_M, Kontext 8192, Aufwärmlauf und drei Läufe, Median; Whisper nicht gemessen, Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- OpenAI auf Hugging Face: Modellkarte whisper-large-v3, abgerufen am 22.11.2026. zurück
- OpenAI auf Hugging Face: Modellkarte whisper-large-v3-turbo, abgerufen am 22.11.2026. zurück
- OpenAI: Whisper auf GitHub (README, Modellgrößen), abgerufen am 22.11.2026. zurück
- SYSTRAN: faster-whisper auf GitHub (README, Benchmarks), abgerufen am 22.11.2026. zurück
- NVIDIA: GeForce RTX 4090: technische Daten, abgerufen am 22.11.2026. zurück
- NVIDIA: GeForce RTX 5060 Familie: technische Daten, abgerufen am 22.11.2026. zurück