Unternehmen
Lokale KI im Betrieb
Kurzantwort
Ein eigener KI-Server lohnt sich, wenn Daten das Haus nicht verlassen sollen oder sehr viele Anfragen anfallen. Mit einer Grafikkarte mit 24 bis 32 GB Speicher und einem offenen Modell wie gpt-oss-20b lässt sich ein Teamserver aufbauen34. In unserem Rechenbeispiel mit mäßiger Nutzung ist die Cloud über drei Jahre günstiger, weil beim eigenen Server Hardware, Strom und Betreuung dazukommen8.
Lokale KI im Unternehmen heißt: Ein Sprachmodell läuft auf einem Rechner im eigenen Haus oder im eigenen Rechenzentrum, und die Beschäftigten greifen über das Netz darauf zu. Anfragen und Dokumente gehen an keinen Cloud-Anbieter. Das ist der Hauptgrund, warum Betriebe darüber nachdenken. Der zweite ist die Hoffnung, Kosten zu sparen, und die geht nicht immer auf. Hier geht es um einen gemeinsamen Server für das Team; den Einzelplatz am eigenen Rechner behandelt der Einstieg in lokale KI.
Gründe für den eigenen Server
Der stärkste Grund ist die Kontrolle über die Daten. Läuft Ollama auf eigener Hardware, schickt es laut Hersteller weder Eingaben noch Daten an ollama.com1. Das vereinfacht vieles, was bei Cloud-Diensten Prüfung braucht: kein Vertrag zur Auftragsverarbeitung (AVV) mit einem Modellanbieter, keine Übermittlung in Drittländer, keine Frage, ob Eingaben ins Training fließen. Die Datenschutzpflichten innerhalb des Betriebs, von Zugriffsrechten bis zu Löschfristen, bleiben bestehen (KI und Datenschutz).
Ollama bietet inzwischen auch Modelle an, die in der Cloud des Herstellers laufen. Diese Funktionen lassen sich laut Dokumentation mit der Einstellung OLLAMA_NO_CLOUD=1 abschalten1. Auf einem Firmenserver gehört das in die Grundkonfiguration, damit niemand versehentlich ein Cloud-Modell wählt.
Weitere Gründe sind feste Kosten statt nutzungsabhängiger Rechnungen, Unabhängigkeit von Preisänderungen und abgekündigten Modellen der Anbieter und Betrieb ohne Internetverbindung, etwa in der Fertigung. Dagegen stehen ein höherer Einstiegspreis, eigene Arbeit für Betrieb und Sicherheit und Modelle, die bei schwierigen Aufgaben meist nicht an die größten Cloud-Modelle heranreichen.
Hardware: was ein Teamserver braucht
Wie groß ein Modell sein darf, bestimmt der Speicher der Grafikkarte, der VRAM. Das Modell muss mitsamt dem Platz für laufende Anfragen hineinpassen, sonst wird es langsam. Zwei Beispiele für die Größenordnung: Die GeForce RTX 5090 hat 32 GB Speicher, eine Leistungsaufnahme von bis zu 575 Watt und laut NVIDIA eine unverbindliche Preisempfehlung von 2.099 Euro4. Die Workstation-Karte RTX PRO 6000 Blackwell bringt 96 GB Speicher mit Fehlerkorrektur und bis zu 600 Watt Leistungsaufnahme5; einen Preis nennt NVIDIA auf der Datenseite nicht.
Mehrere Nutzer gleichzeitig kosten zusätzlichen Speicher. Ollama verarbeitet laut FAQ auf den meisten Systemen standardmäßig eine Anfrage je Modell zur selben Zeit; mit OLLAMA_NUM_PARALLEL lässt sich das erhöhen, wobei jede parallele Anfrage den Kontext und damit den Speicherbedarf vervielfacht1. Weitere Anfragen warten in einer Schlange, die standardmäßig 512 Plätze hat1. Gleichzeitig geladen hält Ollama standardmäßig bis zu drei Modelle je Grafikkarte, sofern sie in den Speicher passen1. Wer dem Team ein Modell für Texte und eines für Programmcode anbieten will, plant den Speicher für beide ein. Für kleine Teams reicht das oft. Für viele gleichzeitige Nutzer ist eine Serversoftware wie vLLM gedacht, die eingehende Anfragen laufend zu Stapeln zusammenfasst und eine zur OpenAI-Schnittstelle kompatible Schnittstelle mitbringt2.
Welche Karte für welche Modellgröße reicht, rechnet der VRAM-Rechner aus, Kaufberatung für Grafikkarten gibt Grafikkarte für lokale KI. Den Rest des Servers, also Prozessor, Arbeitsspeicher, Netzteil und Kühlung, solltest du nicht unterschätzen: Für die RTX 5090 nennt NVIDIA 1.000 Watt erforderliche Systemleistung4.
Welche Modelle in Frage kommen
Für den Betrieb im Unternehmen brauchst du Modelle mit offenen Gewichten (Open Weights) und einer Lizenz, die gewerbliche Nutzung erlaubt. Ein Beispiel ist gpt-oss von OpenAI: Die Modelle stehen unter der Apache-2.0-Lizenz; gpt-oss-20b hat 21 Milliarden Parameter und läuft dank Quantisierung innerhalb von 16 GB Speicher, gpt-oss-120b passt auf eine einzelne Grafikkarte mit 80 GB3. Daneben gibt es viele weitere offene Modelle mit unterschiedlichen Lizenzen, eine Auswahl mit Hardwarebedarf steht bei den lokalen Sprachmodellen. Die Lizenz gehört vor dem Einsatz geprüft, denn nicht jede erlaubt jede Nutzung.
Für den Alltag im Team zählt neben der Qualität die Sprache: Ein Modell, das auf Deutsch hölzern antwortet, wird im Betrieb wenig genutzt. Teste deshalb mit echten Aufgaben aus eurem Alltag, bevor du dich festlegst.
Was unsere Messungen zeigen
Für die Rechnung brauchst du zwei Werte: wie schnell die Karte Text erzeugt, gemessen in Token je Sekunde, und wie viel Strom sie dabei zieht. Wir messen beides auf zwei eigenen Karten. In einer ersten Probemessung mit dem kleinen Modell Llama 3.2 3B in vierbittiger Quantisierung unter Ollama 0.40.0 erzeugte die RTX 4090 rund 282 Token je Sekunde bei rund 275 Watt Leistungsaufnahme der Karte, die RTX 5060 Ti rund 161 Token je Sekunde bei rund 157 Watt6. Im Leerlauf vor der Messung zog die RTX 4090 rund 57 Watt6.
Ein so kleines Modell ist für viele Aufgaben im Betrieb zu schwach; größere Modelle laufen deutlich langsamer. Die vollständigen Messreihen mit mehreren Modellgrößen erscheinen in den Praxistests zur RTX 4090 und zur RTX 5060 Ti, der Strombedarf im Praxistest Stromverbrauch.
Cloud oder eigener Server über drei Jahre
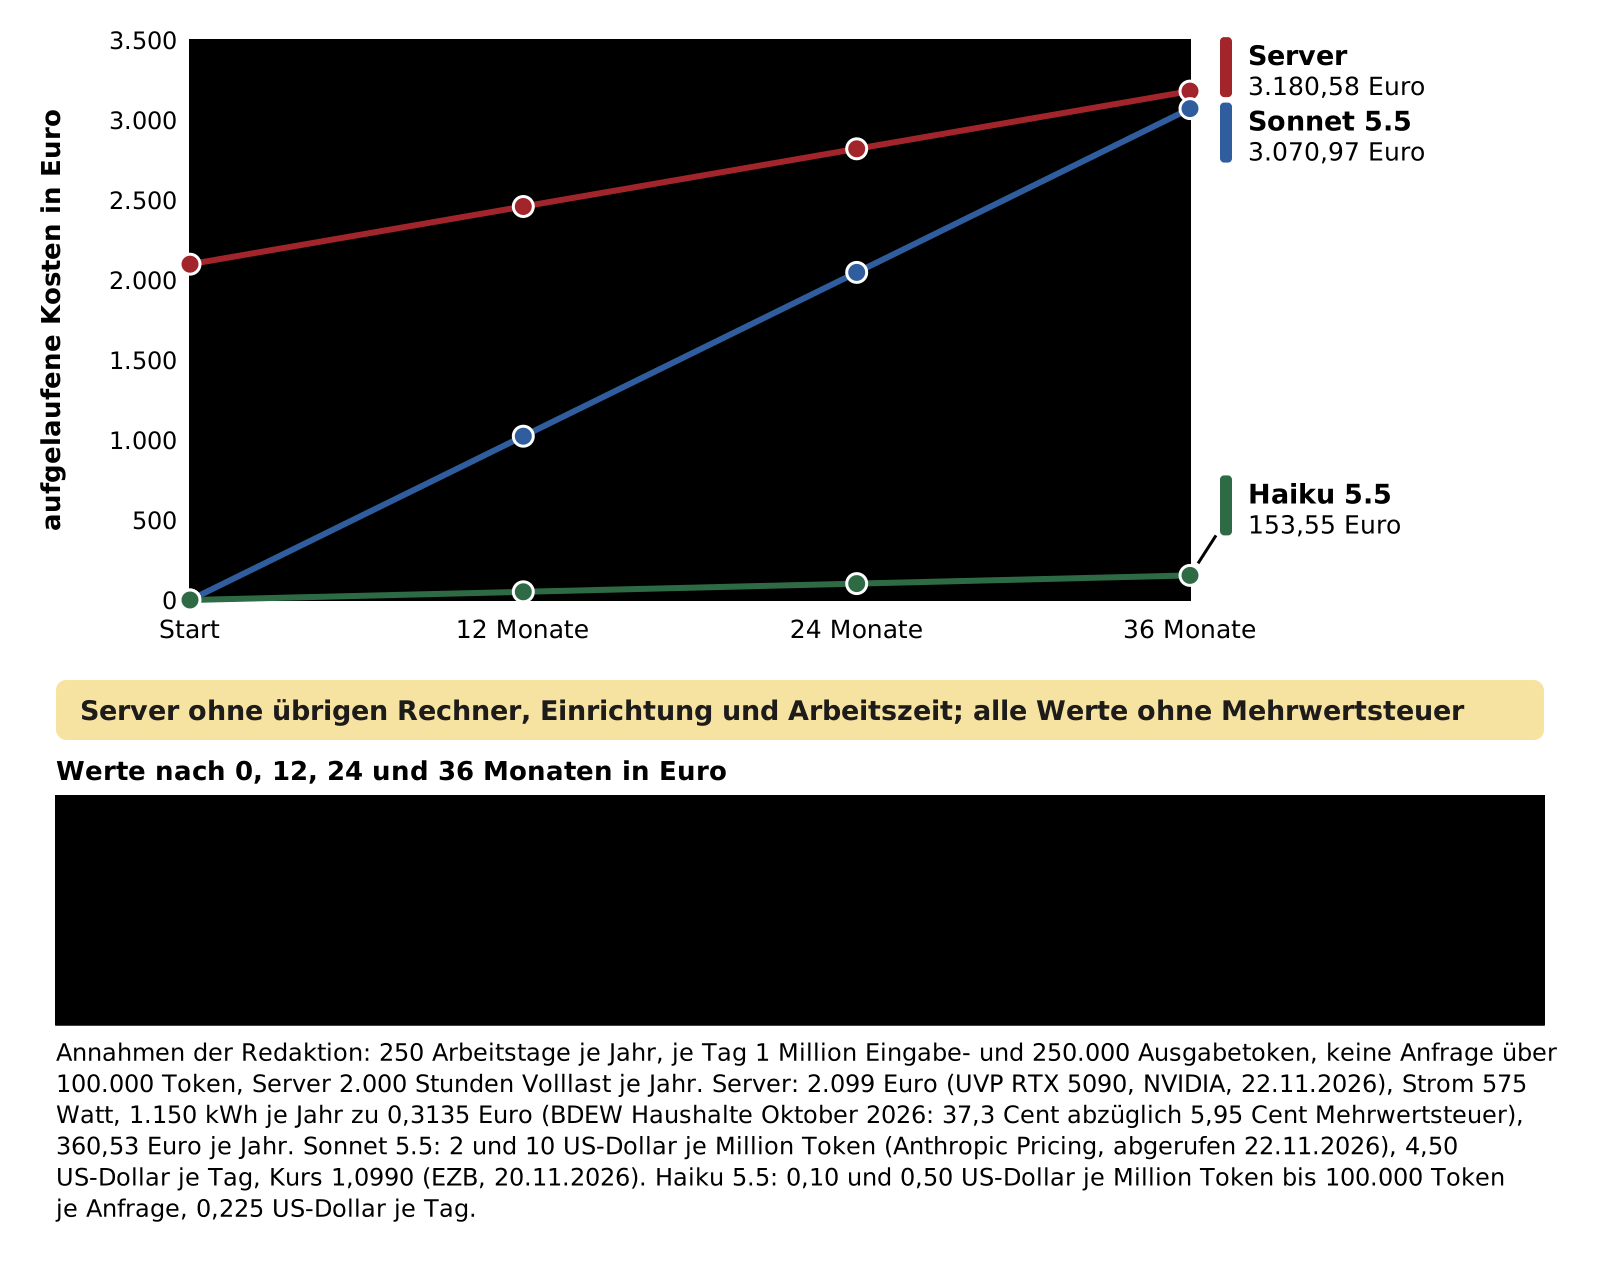
- Server Grafikkarte und Strom netto
- Sonnet 5.5 Cloud, größeres Modell
- Haiku 5.5 Cloud, kleines Modell
Für das folgende Rechenbeispiel gelten Annahmen der Redaktion: Das Team schickt an 250 Arbeitstagen im Jahr je 1 Million Token an das Modell und bekommt 250.000 Token zurück. Der Server läuft mit einer RTX 5090 und wird mit 2.000 Stunden Volllast im Jahr angesetzt, was den Strom eher zu hoch schätzt. Für die Cloud nehmen wir an, dass keine einzelne Anfrage mehr als 100.000 Token mitschickt.
Auf der Serverseite stehen die Grafikkarte mit 2.099 Euro4 und der Strom: 575 Watt mal 2.000 Stunden ergeben 1.150 Kilowattstunden im Jahr4. Die BDEW-Strompreisanalyse vom Oktober 2026 nennt für Haushalte im Schnitt 37,3 Cent je Kilowattstunde, davon 5,95 Cent Mehrwertsteuer, und für kleine und mittlere Industriebetriebe ab 160.000 Kilowattstunden Jahresverbrauch 17,9 Cent7. Ein Büro liegt meist unter der Industrieschwelle und zahlt einen Tarif wie ein Haushalt, kann die Mehrwertsteuer aber als Vorsteuer abziehen. Wir rechnen deshalb mit netto 31,35 Cent: Der Strom kostet rund 361 Euro im Jahr, nach drei Jahren steht der Server bei rund 3.181 Euro47. Mit dem Industriepreis wären es rund 2.717 Euro. Nicht enthalten sind der übrige Rechner, Einrichtung, Wartung und die Arbeitszeit für Updates und Sicherheit.
Auf der Cloudseite rechnen wir mit der aktuellen Modellreihe von Anthropic. Claude Sonnet 5.5 kostet 2 US-Dollar je Million Eingabetoken und 10 US-Dollar je Million Ausgabetoken, für dieselbe Menge also 4,50 US-Dollar am Tag8. Das kleine Claude Haiku 5.5 kostet bei Anfragen bis 100.000 Token 0,10 und 0,50 US-Dollar, am Tag also 0,225 US-Dollar; darüber steigt der Preis auf 0,50 und 2,50 US-Dollar8. Mit dem Referenzkurs der EZB von 1,0990 US-Dollar je Euro vom 20.11.2026 sind das über drei Jahre rund 3.071 Euro für Sonnet 5.5 und rund 154 Euro für Haiku 5.589. Steuern auf die Cloudrechnung sind dabei so wenig eingerechnet wie beim Strom.
Bei dieser Menge liegt die Cloud also vorn: mit Sonnet 5.5 knapp, mit Haiku 5.5 um ein Vielfaches. Dabei enthält die Serverrechnung den Rechner um die Karte herum und die Arbeitszeit noch gar nicht. Der eigene Server holt auf, wenn die Menge deutlich steigt, weil seine Kosten kaum mit der Nutzung wachsen. Die Rechnung vergleicht außerdem ungleiche Modelle: Ein lokales Modell auf einer Karte mit 32 GB ist nicht mit den großen Cloud-Modellen gleichzusetzen4. Deine eigenen Mengen und Preise rechnest du im KI-Kostenrechner durch.
Ein Pilot vor dem Kauf
Bevor du einen Server bestellst, lohnt ein Probelauf mit vorhandener Hardware. Ein Arbeitsplatzrechner mit einer Grafikkarte genügt für einen Probelauf mit einem kleineren offenen Modell. Damit lässt sich klären, was später den Ausschlag gibt:
- Sammle zehn bis zwanzig typische Aufgaben aus dem Alltag, etwa Mails zusammenfassen, Angebote formulieren oder Fragen zu internen Regeln beantworten.
- Lass dieselben Aufgaben einmal vom lokalen Modell und einmal von einem Cloud-Tarif mit Vertrag bearbeiten und vergleiche die Ergebnisse mit den Leuten, die die Aufgaben sonst erledigen.
- Notiere, wie lange die Antworten dauern und wie viele Personen gleichzeitig arbeiten würden.
- Entscheide erst danach über Modellgröße, Grafikspeicher und damit über das Budget.
Fällt der Vergleich bei den vertraulichen Aufgaben gut aus und bei den schwierigen schlecht, ist das ein starkes Argument für die Mischform weiter unten.
Betrieb: wer kümmert sich?
Ein KI-Server ist ein Server wie jeder andere und braucht Updates, Sicherungen, Überwachung und einen Plan für Ausfälle. Ollama hört nach der Installation nur auf dem eigenen Rechner (127.0.0.1, Port 11434); erst über die Einstellung OLLAMA_HOST wird es im Netz erreichbar1. Bevor du das tust, gehört eine Oberfläche mit Anmeldung davor, etwa Open WebUI, und der Zugriff sollte auf das Firmennetz beschränkt bleiben.
Plane außerdem Zeit für Modellwechsel ein. Neue offene Modelle erscheinen in kurzen Abständen, und jeder Wechsel braucht einen Test mit euren Aufgaben. Wer im Betrieb niemanden für diese Arbeit hat, verschiebt die Kosten von der Rechnung des Anbieters in die eigene Personaldecke oder zum IT-Dienstleister.
Eine Mischform ist häufig sinnvoll: Vertrauliche Aufgaben wie Personalunterlagen oder Kundendaten laufen auf dem eigenen Server, allgemeine Texte und schwierige Aufgaben in einem Cloud-Tarif mit Vertrag, am besten bei einem Anbieter mit Datenverarbeitung in der EU.
Was das für dich heißt
Ob sich der eigene Server lohnt, hängt von euren Datenregeln und euren Mengen ab.
- Schreib auf, welche Aufgaben vertrauliche Daten betreffen, die das Haus nicht verlassen sollen.
- Schätz die Token pro Arbeitstag mit ein paar echten Aufgaben und rechne Cloud und Server im KI-Kostenrechner.
- Teste ein offenes Modell zuerst auf einem vorhandenen Rechner mit euren Aufgaben, bevor du Hardware kaufst.
- Kläre, wer Updates, Sicherungen und Zugänge des Servers übernimmt.
Häufige Fragen
Kann ich eine eigene KI im Unternehmen ohne Cloud betreiben?
Ja. Mit einer Grafikkarte mit genug Speicher, einer Software wie Ollama oder vLLM und einem offenen Modell läuft ein Sprachmodell komplett im eigenen Haus. Für mehrere Nutzer kommt eine Oberfläche mit Anmeldung dazu.
Wie viele Mitarbeitende kann ein lokaler KI-Server bedienen?
Das hängt von Modellgröße, Speicher und gleichzeitigen Anfragen ab. Ollama bearbeitet standardmäßig meist eine Anfrage je Modell gleichzeitig und stellt weitere in eine Warteschlange. Für viele gleichzeitige Nutzer ist eine Serversoftware wie vLLM gedacht.
Ist lokale KI automatisch datenschutzkonform?
Sie vereinfacht den Datenschutz, weil keine Daten an einen Modellanbieter gehen. Die übrigen Pflichten bleiben, etwa Zweckbindung, Zugriffsrechte und Löschung, und auch ein lokaler Server muss gegen Angriffe geschützt sein.
Welche Grafikkarte brauche ich für einen KI-Server im Büro?
Für mittelgroße Modelle wie gpt-oss-20b reichen Karten ab 16 GB Speicher, für mehrere Nutzer und größere Modelle sind 24 bis 32 GB oder Workstation-Karten mit mehr Speicher sinnvoll. Den Bedarf für ein bestimmtes Modell berechnet der VRAM-Rechner.
Quellen
Stand:
- Ollama: FAQ (parallele Anfragen, Netzwerk, Datenschutz, Cloud abschalten), abgerufen am 22.11.2026. zurück
- vLLM Project: Projektseite auf GitHub (README), abgerufen am 22.11.2026. zurück
- OpenAI auf Hugging Face: gpt-oss-20b, Modellkarte, abgerufen am 22.11.2026. zurück
- NVIDIA: GeForce RTX 5090 (UVP und technische Daten), Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- NVIDIA: RTX PRO 6000 Blackwell: technische Daten, abgerufen am 22.11.2026. zurück
- Eigene Messung: Probemessung Llama 3.2 3B Q4_K_M mit Ollama 0.40.0 auf RTX 4090 und RTX 5060 Ti, Treiber 621.35, Kontext 8.192, drei Läufe, Median; Leerlaufwert vor dem Lauf, Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- BDEW: Strompreisanalyse Haushalte und Industrie, Oktober 2026, Stand 10/2026, abgerufen am 22.11.2026. zurück
- Anthropic: Claude API: Pricing, Stand 22.11.2026, abgerufen am 22.11.2026. zurück
- Europäische Zentralbank: Euro-Referenzkurs US-Dollar, Stand 20.11.2026, abgerufen am 22.11.2026. zurück